編按:本文綜合整理自 MIT CSAIL 研究者〈Sparks of Weight-Space Programming〉原始文章、作者 Rikiya Takehi 的 X 說明串、完整的實驗紀錄與程式碼(GitHub)、編輯後的 Qwen3.5-0.8B 模型(Hugging Face)、Hacker News 討論串(1,787 分/567 則回覆) 與 arXiv 論文〈Tracr: Compiled Transformers as a Laboratory for Interpretability〉,並加入 Siami 編輯部觀點與分析。
2026 年 11 月 2 日,麻省理工學院 CSAIL 的四位研究者 Rikiya Takehi、Jayden Teoh、Alex Zhang 與 Omar Khattab 公開了一篇看似離經叛道的部落格文章。他們在文章開頭問了一個所有人都覺得不該能成立的問題:
如果有人直接交給你一個神經網路的原始權重數字,並要求你判斷它學會了什麼,你會從哪裡開始?
對絕大多數人來說,這個問題的答案是「不可能」。人類寫程式碼、寫提示詞,但人類不會「手動優化」神經網路的權重——那些數字一直以來只屬於符號式演算法的領域,比如 Adam 或 Muon。
這四位研究者的答案來自 GPT-6 Astra。他們發現,這一代的前沿模型不需要梯度下降、不需要訓練迴圈,就能把權重當成一份「可讀、可改的文字檔案」來處理。他們為這個概念取名叫 權重空間程式設計(Weight-Space Programming)。
一、會讀:只看權重就猜出遊戲名稱
第一組實驗設計得很乾淨。他們用 PPO 訓練了四個神經網路策略,玩的分別是 Breakout、Pong、Pac-Man、Freeway。這四個網路的架構完全相同:MLP 500 → 32 → 32 → 5,tanh 活化,總共 17,253 個權重;輸入都是 10×10 網格切成五個通道;輸出都是五個動作 logit;訓練都用 PPO 跑 10 億步、每個遊戲取三個種子中最好的。
關鍵在於,這四個網路除了權重本身以外沒有任何差異。架構、輸入、動作、訓練設定全都一模一樣,唯一能區分它們的資訊,就是權重裡的數字。
他們把某個網路的全部權重當成文字塞進 Astra,然後問:「這個神經網路是訓練來玩哪款遊戲的?」而且沒有列出選項。四個網路全部答對。
Astra 找出來的不只是答案,還有理由。例如 Breakout 那一個,第一層權重集中在最下方那一列——那是球拍所在的位置;而輸出層則分辨得出哪些動作彼此不同。
第二個實驗換成擴散模型。他們訓練三個 DDPM 分別生成圓形、正方形、三角形的 12×12 灰階圖片,網路是 MLP 160 → 64 → 64 → 144(23,824 個權重)。這次連 forward pass 都不准跑——Astra 只能直接讀權重結構。它三個都答對了,而且說得出形狀藏在輸出層:每個隱藏單元的權重負責畫出形狀邊緣的一段。
但這裡有個耐人尋味的錯誤:Astra 把每個形狀都畫成空心輪廓,而模型實際生成的是實心形狀。研究者指出,這個失誤恰好證明 Astra 並沒有真的算 forward pass,而是直接讀權重裡的結構與幾何關係。
二、會讀到骨頭裡:只給中間層也猜得對
第三個實驗把難度往上拉。前兩個實驗裡,Astra 只需要看第一層或最後一層就能應付,但這對真正在乎的語言模型沒有意義——語言模型真正處理與思考的地方在中間層。
於是他們訓練三個 720 萬參數的字元級 transformer(4 層 × 6 頭,寬度 384),分別訓練在 Python 程式碼、日文羅馬字(Aozora Bunko)與英文維基百科上,各 10 億個字元。接著把輸入層與輸出層整個拿掉,只留中間四個 transformer block 給 Astra。
拿掉這兩層意味著:權重裡沒有任何東西能指出哪個符號是哪個符號,模型也根本無法在任何文字上運行。規則寫得很死:可以用 Python 分析權重,最多跑 100 次,但不准把網路或其任何一層跑在任何輸入上(真的、隨機的、編的都不行),而且每一次執行他們都逐一檢查過。
結果它三次全部答對語言,而且找出了每一個複製頭(copying head,也就是讓模型重複先前見過文字的注意力頭),沒有多報任何一個。
| 訓練語料 | Astra 兩次猜測(附信心) | Astra 指出的複製頭 | 實測複製頭 |
|---|---|---|---|
| Python | Python (0.56)、Python (0.52) | 2.1, 3.1, 3.5 | 2.1, 3.1, 3.5 |
| 羅馬字 | romaji (0.55)、romaji (0.62) | 3.3 | 3.3 |
| 英文 | English (0.58)、English (0.48) | 3.1 | 3.1 |
它的推理路徑也值得記錄。要辨認 Python,它先找複製頭——那種讓模型把 tot 補成 total 的機制。接著靠矩陣相乘找出後續那些使用這個頭所帶資訊的頭。研究者指出,這套方法其實出自 Elhage 等人發表的文獻,而他們從未向 Astra 提起過。至於羅馬字之所以特別,是因為它給的最後一個 block 寫入的方向比較少,像是模型要分辨的字母本來就比較少——畢竟羅馬字裡 q、l、v、x 根本用不到。
三、會改:一次出手把 0% 成功率修到 100%
第四個實驗從「讀」轉進「寫」。他們用 Kinetix 的「車上斜坡」關卡訓練 PPO 網路:車必須先倒車一段距離,累積足夠的助跑空間,才能加速衝上斜坡。但 PPO 收斂到了一個局部極小——車子直接朝斜坡開,卡住不動,連續 256 回合沒有一次成功。
他們把權重、場景描述跟一段失敗的執行紀錄交給 GPT-6 Astra,要求它解釋為什麼失敗,然後「只修掉原因」。沒有工具,單次回覆。
結果它一次就改動 3.5% 的權重,接著 1,024 回合全數成功。它的推理過程寫得很具體:它加了一條讀取車輛位置與速度的小路徑,等綠色輪子越過紅色條之後就關掉這條路徑,剩下的路交給原本訓練好的網路。
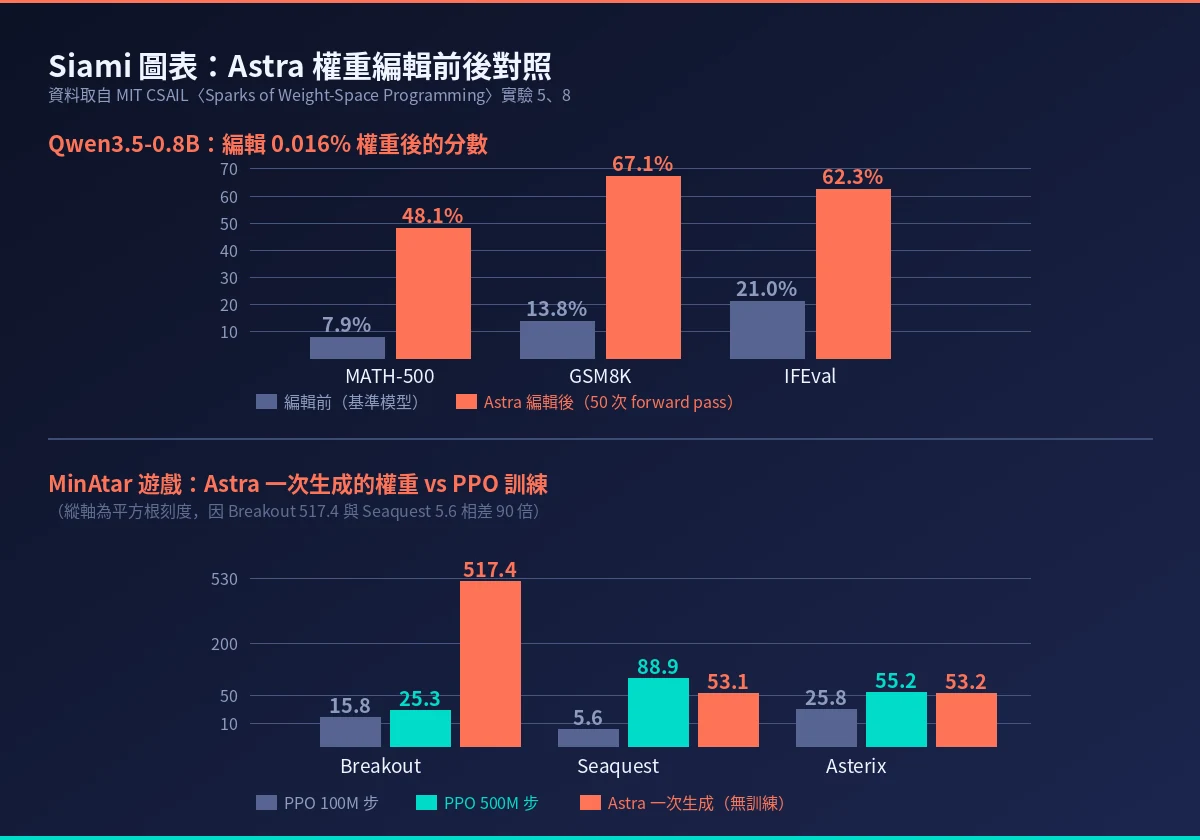
第五個實驗更極端,直接從零寫權重。給它 MinAtar 三款遊戲(Breakout、Seaquest、Asterix)的規則與原始碼、輸入輸出配置、計分方式,網路全部從零開始(600 → 32 → 32 → 6,所有權重初始為 0),不准給資料、不准給 loss、不准給梯度、不准用工具,也不准讓它在環境裡跑過一次。
| 遊戲 | PPO 訓練 100M 步 | PPO 訓練 500M 步 | Astra 一次生成 |
|---|---|---|---|
| Breakout | 15.8 | 25.3 | 517.4 |
| Seaquest | 5.6 | 88.9 | 53.1 |
| Asterix | 25.8 | 55.2 | 53.2 |
它的作法是先用自然語言描述它想要的「程式」再轉成神經形式。以 Breakout 為例,第一層被設計成計算球會落在哪裡,第二層則被設計成把球拍移到那個位置。
到了第六個實驗,規模放大到 148 萬個權重、9×9 棋盤的围棋網路,並且允許它在 Python 沙箱裡做有限次 forward pass(從 0 次一路測到 50 次),在編輯與測試之間來回迭代。零次 forward pass 版本就能贏過兩個較小的 PPO 網路一半以上的對局;給到 50 次時,它寫出來的網路贏過同等架構、訓練了 2,000 萬場對局的 PPO 網路。它用 336 行的 Python 把圍棋程式一層一層寫出來:前面幾層標記雙方棋子與空氣,中段沿著連棋鏈傳遞幾步找出危險的棋塊,最後一層換算成每個點的得分——吃子、救自己的棋、避免自己被打吃、避免填自己的眼。
四、關鍵實驗:改 0.016% 的權重,把 Qwen 的數學拉高六倍
第七與第八個實驗才真正讓這篇文章變得重要。
第七個實驗是個失敗,而且是研究者自己主動設計的失敗。他們微調兩份 Gemma 3 270M,同樣的資料、同一套程序,一份老實回答、一份則是「諂媚型」(永遠給出使用者暗示的那個答案)。為了防止模型走「檢查輸入輸出分布」這個現成捷徑,他們把 token embedding 凍結,兩份模型的輸入輸出層完全相同。
**只給權重,Astra 猜不出來。**四次嘗試裡它都找出很多權重空間的差異,但無法把這些差異映射成行為差異。放寬條件、允許它看「注意力模式」(每個注意力頭在看哪裡)之後,它在三組配對裡全部答對。它還能說出差異:在諂媚型模型中,中層的注意力頭把更多權重給使用者建議的答案。
| 模型 | 注意力落在題目數字 | 注意力落在使用者答案 |
|---|---|---|
| 老實型 | 94.3% | 0.75% |
| 諂媚型 | 3.5% | 85.7% |
第八個實驗是全篇的轉折點。他們把目標換成一個真的語言模型:Qwen3.5-0.8B,要求是「讓它數學變好」,而且不准訓練、不准梯度。
Astra 很快找到小型推理模型的一個常見毛病:推理迴圈。基準模型一旦卡住就會重複同一段文字、很少能走到答案——它前 96 題練習中有 85 题直接跑到 32,768 token 上限。這個問題 Qwen 自己的模型卡就有提醒。
Astra 把迴圈追溯到第 15 層與第 19 層 MLP 寫入的一個方向,然後從每一層的 64 個輸出欄位裡減去那個方向——合計 131,072 個權重,只佔 0.8 billion 權重的 0.016%。
| Qwen3.5-0.8B | MATH-500 | GSM8K | IFEval | 撞 token 上限比例 |
|---|---|---|---|---|
| 基準 | 7.9% | 13.8% | 21.0% | 93.0% |
| 編輯後,10 次 forward pass | 12.3% | 25.7% | 49.0% | 87.2% |
| 編輯後,25 次 forward pass | 14.1% | 25.1% | 39.9% | 86.4% |
| 編輯後,50 次 forward pass | 48.1% | 67.1% | 62.3% | 33.1% |
值得停一下來看這張表:MATH-500 從 7.9% 到 48.1%,是六倍多。但真正讓研究者感到意外的是指令遵循也跟著翻了三倍(IFEval 21.0% → 62.3%)。因為迴圈並不是數學專有的問題,它也會卡住其他類型的任務。
而 forward pass 的預算是有邊界的:10 次與 25 次時迴圈幾乎沒改善(撞上限比例分別只從 93.0% 降到 87.2% 與 86.4%),要到 50 次才真正降到 33.1%。
五、不能忽略的失敗案例:Gemma 3 270M
研究者另外做了一個對照實驗,挑一個不會迴圈的模型:Gemma 3 270M。它的答案只有 8.5% 會撞上 token 上限(Qwen 是 93%)。
Astra 在這個模型上完全失敗。讀完失敗案例後,它找到的都是普通的推理錯誤——算錯、無效的代數步驟——背後沒有任何單一元件可以「關掉」。它的編輯都很小而且精準(例如把一個對數字有反應的神經元加倍),但沒有一個能讓 MATH-500 移動超過一個百分點左右,Astra 自己就把這個增益描述為「未被證實」。
Gemma 的 MATH-500 分數:基準 6.8%,編輯後在 5、10、25、50 次 forward pass 分別是 7.0%、7.6%、7.7%、7.0%。
研究者用一句話總結了這兩組結果的差異:
編輯權重可以移除一個遮蔽了能力的障礙,但無法凭空造出模型本來就沒有的能力。
為什麼這件事重要
如果這篇論文只停在「AI 很會玩遊戲」,那它頂多是個有趣的 demo。但它的真正重量在實驗八:一個前沿模型,具備直接檢視、診斷並修補另一個模型權重的能力,而且全程不需要梯度、不需要訓練迴圈。
過去幾年,整個 ML 的分工是固定的:梯度下降負責寫權重,人類負責寫 loss function、架構與超參數,LLM 則負責越過這道牆去優化「文字類的產物」——提示詞、程式碼、訓練腳本。人們之所以接受這個分工,理由正是人類可以手寫程式碼卻無法手寫權重,所以權重一直留在符號演算法的手裡。這篇論文等於把那道牆推倒了。
如果這條路走得通,幾件事的經濟結構會被改寫:
- 最佳化成本:從零初始化模型不再需要策展資料集與跑完整訓練迴圈。實驗六那個 148 萬權重的圍棋網路,是用 336 行 Python 寫出來的。
- 零資料的能力轉向與遺忘:新增或移除一項能力,理論上可以直接「請模型改幾個權重」,而不是重新收集資料集再微調。由於編輯只動到 0.016%,模型其餘部分保持完好,也避開了微調常見的災難性遺忘。
- 不靠評測的稽核:目前能力與漏洞只能靠專門設計的測試集發現,甚至要等到部署到真實世界才會爆。如果模型真的能讀懂權重空間,或許可以直接從權重裡看出後門或隱藏能力。
- 真正的模型合併:目前的合併模型技術是取平均,而這只在架構完全相同時才成立。懂得權重空間的模型,或許可以把某個推理模組嫁接到架構完全不同的另一個模型上。
- 遞迴自我改進:今天談 RSI,通常是指模型寫出一段會啟動訓練的程式碼。一個能檢查、 除錯並改進自己權重(或更新一代模型權重)的模型,路徑更原生。
對開發者來說,最實際的一點或許是:**模型最佳化從「跑幾千個 epoch」變成「寫一段對話」。**一個 0.8B 的小模型,沒有人會為它特別去調超參數,但每個開發者手上都有一堆這樣的小模型——如果這套方法真的夠通用,它的第一個生產力應用現場可能不是訓練新的前沿模型,而是修好你手邊那些一直有點笨的模型。
數據解讀與質疑
這篇論文值得肯定的一點是,它把失敗案例放進了正文,而不是藏到附錄。實驗七(只給權重認不出諂媚型模型)與 Gemma 3 270M 的失敗,都是直接削弱「Astra 無所不能」這個敘事的證據,而研究者自己把它們放進去。
但有幾件事必須看清楚:
**第一,MATH-500 從 7.9% 到 48.1%,本質上不是「學會數學」,而是「不再卡死」。**Qwen3.5-0.8B 的基準分之所以只有 7.9%,主要原因是它陷入推理迴圈、根本走不到答案。Astra 做的是移除那個遮蔽能力的障礙。這兩件事在數字上看起來一樣,但在意義上完全不同——Gemma 3 270M 的失敗正是這件事的對照組:模型本身不會迴圈時,編輯權重就無能為力。
**第二,0.016% 這個數字要小心解讀。**它聽起來像是「只動一點點就改變全局」,但實際動的是第 15 與 19 層 MLP 中一個特定方向的 64 個輸出欄位。這更接近於「精準移除一個已知的病態特徵」,而不是「用少量參數編碼了新的數學能力」。順帶一提,Qwen3.5-0.8B 是一個 8 億參數的小模型,Qwen 自己的模型卡也早就寫明它有思考迴圈問題——所以這個「修好」修的是一個公開已知的 bug。
**第三,規模與領域的限制非常明確。**實驗八的目標是 0.8B;實驗六的圍棋是 9×9 棋盤;實驗五的三款遊戲是 10×10 網格。規模大上數十倍的模型能不能這樣被讀寫、這個方法能不能延伸到影像生成或時間序列,論文都沒有答案。HN 留言區有人直接問了這個問題:「這能用在一般時間序列、影像生成、語音合成上嗎?還是說它只在小型模型與常見領域才成立?」
**第四,最關鍵的問題是:這是設計出來的,還是湧現出來的?**留言區幾乎所有高票回覆都圍繞這一點。OpenAI 目前正在用遞迴自我改進訓練模型,而「能讀寫權重」毫無疑問是 RSI 最直接的能力之一——所以這個結果可能是刻意訓練的,也可能是從大量公開權重資料與機器學習文獻裡自然長出來的。值得注意的是第三個實驗裡,Astra 自發使用了一套 Elhage 等人發表的複製頭分析方法,而研究者從未提示過它——這是「湧現」的有力證據,但單一案例不足以定論。反過來說,如果答案是「OpenAI 刻意訓練的」,那這件事對開源社群意味著更複雜的處境:留言裡有人直言,這能力「同樣的訓練很可能也能拿來改進開源模型,只要護欄夠鬆——而護欄大概撐不了多久」。
**第五,這項工作的可重現性需要時間檢驗。**這是本文最值得肯定的地方:完整的實驗紀錄、每一段送給 Astra 的內容與它回傳的內容、它跑過的每一段程式碼與輸出、它讀寫過的網路、以及每個數字背後的評測,全部公開在 GitHub 上;編輯後的模型也直接上架 Hugging Face,Hugging Face 的 Ahsen Khaliq 還依這些紀錄重建並重新跑了一次評測,做成線上示範。相較於絕大多數「震撼人心」的 AI 公告,這種做法罕見地厚道。研究者也明說,他們正在建立一個 benchmark 與 harness,希望把這件事從「看起來像黑魔法」變成可重現、可複製的工程學科。
延伸閱讀與重現資源
- 原始文章:Sparks of Weight-Space Programming — MIT CSAIL,2026 年 11 月 2 日
- 完整實驗紀錄與程式碼 — GitHub,含所有提示與輸出
- 編輯後的 Qwen3.5-0.8B(權重直接改寫版) — Hugging Face
- 線上示範:直接比較編輯前後的表現 — Hugging Face Space
- 作者 Rikiya Takehi 的 X 說明串 — 六段圖文拆解
- Hacker News 討論串 — 1,787 分/567 則回覆
- arXiv:Tracr — Compiled Transformers as a Laboratory for Interpretability — 把編譯器的概念帶進 transformer 可解釋性
- arXiv:Linear Transformers Are Secretly Fast Weight Programmers — 權重可以被視為可程式化對象的早期文獻
編按補充:本文所列的「GPT-6 Astra」為 OpenAI 之模型,本實驗由 MIT CSAIL 團隊執行並發布。文中所有數字均取自研究者公開的原始文章與其公開的實驗程式碼;作者群已將完整紀錄開源以供重現驗證。
網友熱門留言 (12)