編按:本文綜合整理自 OpenAI 官方技術部落格〈Scaling Git at OpenAI〉、Anthropic 官方研究文章〈Redesigning source control at Anthropic〉、The New Stack 報導〈OpenAI built itself a new Git backend, too〉、GitHub 工程部落格〈Building Git infrastructure for agent-scale development〉、OpenAI 維護的 Git 分支(github.com/openai/git)、OpenAI Git 修補追蹤站、Developers Digest 分析〈OpenAI Pando: The Git Backend Built for Codex-Scale Pushes〉 與 Hacker News 討論串(241 分/165 則回覆),並加入 Siami 編輯部觀點與分析。
2026 年 11 月 2 日,OpenAI 公開一篇工程長文,談的是一件聽起來完全不性感、卻可能決定下一代 AI 開發效率的事情:他們的 Git 伺服器不夠用了。
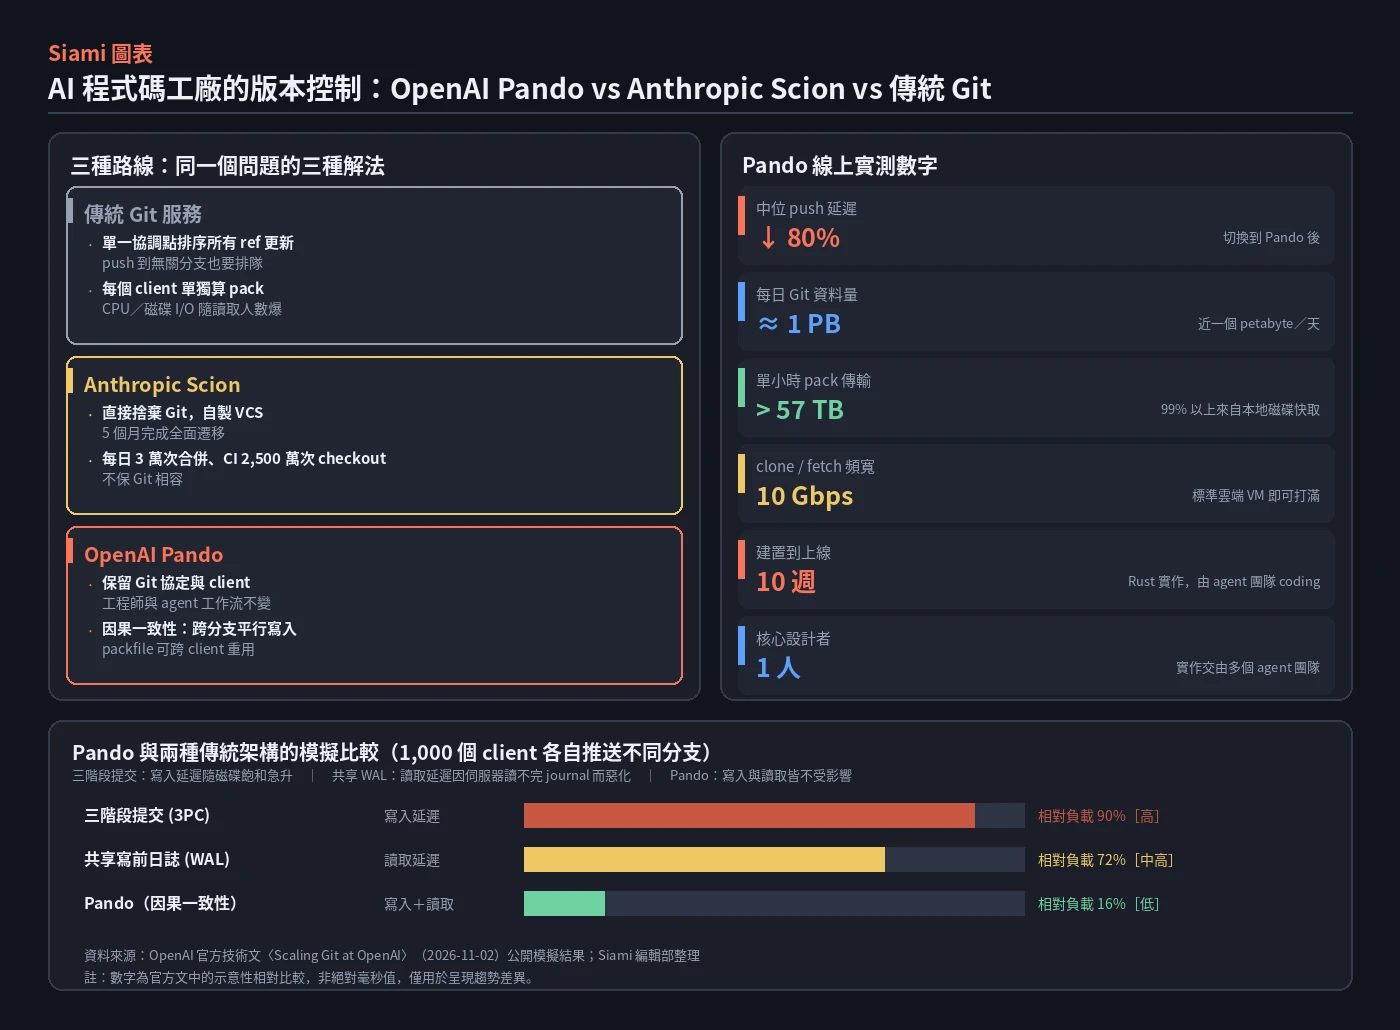
文章標題是〈Scaling Git at OpenAI〉。主角叫 Pando,是一套全新的 Git 儲存庫後端。OpenAI 說,Pando 已經接管他們 monorepo 的全部開發流程,把中位 push 延遲砍掉近 80%(約 5 倍加速),每天供應接近 1 petabyte 的 Git 資料,單小時曾經送出超過 57 TB 的 pack 檔。
但這篇報導真正值得讀的地方,不是那些效能數字,而是它揭露了一個更根本的轉折:AI 開始寫程式碼之後,版本控制系統的設計前提整個失效了。
一、Git 撐不住了:Codex 把 monorepo 逼到極限
先看問題從哪裡來。Git 是 2005 年由 Linus Torvalds 為 Linux 核心開發的工具,起因是核心團隊當年是用 email 互相交換 patch。二十多年來,開發者們一路改工具、改流程、改部署方式,但 Git 的核心設計前提幾乎沒動過。
OpenAI 的狀況是這樣的:
從去年底開始,支撐 OpenAI monorepo 的系統就開始跟不上。團隊遇到慢速的 fetch 與 push,以及失敗的合併,可靠性有時低於 90%。
原因寫得很直白:**Codex 讓工程師能同時開更多條線。**更多分支、更多 push、更多合併,以及更多來自開發環境、研究任務與 CI 的 fetch 與 clone。這些負載會互相疊加——一位工程師手上同時有多個變更等著進 CI,而每次 push 都可能讓好幾個工作同時去抓同一個 commit。
如果碰到的是 Git 本身的極限,或是供應 monorepo 方式的極限呢?
這句話的分量在於:OpenAI 沒有回答「Git 不夠好」,而是承認自己走到了一條路的盡頭。值得注意的是,Git 社群花了將近二十年把這套平台推到能服務數百萬開發者的規模,而 OpenAI 的選擇是保留 Git 協定與 client、重寫後端。
二、兩條走不通的路:三階段提交與共享寫入日誌
在動手寫 Pando 之前,OpenAI 先評估了兩種用既有 Git 擴展的常見做法,兩種都輸了。
**第一條:多副本 + 三階段提交(3PC)。**Git 服務在多個副本各留一份完整儲存庫,任何一台收到 push 就把 pack 平行複製給所有副本,要發布這次 push 必須有多數副本接受。代價是每一次 push 都要跑好幾輪 coordinator 與各副本之間的通訊,而且引用更新是一個一個來的。推給不同分支的 push 也得排隊。
**第二條:共享寫入日誌(WAL)。**把收到的 pack 上傳到 blob storage,再用 compare-and-swap 更新一份共享 manifest。問題出在「即使推的是完全無關的分支,也得更新同一份 manifest」——blob store 可以平行收 pack,但 manifest 更新仍互相競爭,而 compare-and-swap 的往返時間直接決定了整個儲存庫每秒能發布幾次。
| 設計 | 瓶頸所在 | 官方實測結果 |
|---|---|---|
| 三階段提交 | 等多數副本回應 | 磁碟飽和後寫入延遲顯著上升 |
| 共享寫入日誌 | 共用 manifest 的 compare-and-swap | 伺服器讀不完 journal,讀取延遲惡化 |
| Pando | 不設單一協調點 | 數千個 client 同時 push 互不影響 |
官方用 1,000 個 client 各自挑不同分支反覆推 unique commit 做了模擬,量測總耗時與「push 到 fetch」的往返延遲——後者是他們認定的協作關鍵指標,因為它直接決定工程師與 agent 之間能不能順暢配合。
三、兩個關鍵改動:因果一致性,以及 packfile 跨 client 重用
Pando 的核心是放棄兩個「大家都以為是必要」的 Git 假設。
**改動一:放棄全庫一致,改用因果一致性(causal consistency)。**每次 push,incoming pack 被當成不可變 blob 存進 blob store;每當分支移動,就記錄一個 ref version(含新 tip、供應它的 pack,以及依賴的先前 ref versions)寫進 metadata store。只有推給同一個 ref 的 push 才會衝突,推給不同分支可以完全平行。
代價官方也講得很清楚:客戶端讀多個分支時,不能假設這些讀取描述的是全庫同一時間點的狀態。這是一個明確的、寫在文件裡的取捨。
改動二:packfile 不再「一個 client 一份」,而是跨 client 重用。傳統 Git 伺服器要為每個 fetch 算一份專屬 pack,這件事又貴又難快取。Pando 直接重用之前 push 進來的 pack,透過 Git 協定的 packfile-uri 功能把連結交給客戶端,由一套名叫 Express 的 pack 交付服務透過區域快取供應。官方稱快取命中率超過 99%,並且用標準雲端虛擬機器就能讓 clone 與 fetch 打滿 10 Gbps 的網路連線。
在 push 端,Pando 還刻意不向客戶端廣告全部分支。原因是純粹的算術:有數百萬個分支時,光是 ref 廣告就能超過 100 MiB。而且廣告的 ref 越多,客戶端產生的 pack 越難被重用。Pando 預設只廣告一條 trunk 分支。
代價是:同一個分支反覆 push,客戶端得重傳 trunk 以外的物件。官方在自家 monorepo 實測,中位 pack 小於 20 KiB,99 百分位小於 3 MiB——他們認為這是合理的取捨。
在推的時候,Pando 讓 pack 檔以串流方式一邊寫進 blob store 一邊驗證,完全不需要解壓成本地儲存庫。伺服器只做協商與 pack 選取,所以可以用普通硬體的機器跑。寫入路徑的 metadata 讀寫次數是 O(1),不管 push 的大小;fetch 端則是 O(log Δ),Δ 是客戶端與目標之間最短的 ref version 距離。
四、背景壓縮:讓落後的客戶端不必下載幾萬個 pack
還有一個容易被略過、但決定實用性的設計。
在快速變動的儲存庫裡,如果每次 push 都留一個獨立 pack,客戶端要追上 trunk 就得下載幾萬個 pack 檔。因此 Pando 借用了 log-structured merge-tree 的 compaction 概念:每次 push 產生一個 L0 pack,背景工作把它們收攏成涵蓋一串 ref version 的「cover」,層級按幾何級數往上。目前 OpenAI 的 monorepo 已經用到 L4。
這些 cover 有兩個用途:一是讓 pack 內部物件重新排列以改善壓縮比;二是當成 ref version 的 skip list,讓 fetch 規劃可以用對數時間完成。
與許多 Git 伺服器不同,各層的 pack 都不會被丟棄或垃圾回收——每一層都持續被拿來服務客戶端。
官方稱這同時降低了傳給客戶端的總位元組量,也讓 pack 規劃隨客戶端落後程度次線性擴展。
五、被 Codex 寫出來的 Pando:10 週、1 個設計者、數百小時的形式化驗證
這一段可能是整篇文章最值得玩味的地方。
OpenAI 是用 Codex 打造 Pando 的,從開工到上線只花了 10 週。Pando 的核心由一位工程師設計,交由多個 agent 團隊實作,最後由少數幾位工程師部署。Pando 於今年 4 月開始服務正式流量。
技術選型上,這是一個全新的 greenfield 專案,用 Rust 寫、不帶任何 legacy 相依套件。他們寫了一套一致性測試套件,讓 agent 能在修改後對照標準 Git 行為自我驗證,也做了確定性模擬測試框架來檢查系統的不變量與性質,用來找出並修掉協商與 pack 規劃裡的細微競態。
OpenAI 用 GPT-6 Astra,讓 agent 寫 Lean 與 TLA+ 來形式化一套「Pando 理論」,用它找出並修正實作裡的 bug,並證明系統的性質。多個連續 session 跑了數百個小時,只為找出並修掉 Pando 的邊緣案例。團隊也讓 agent 二十四小時紅隊測試 Git 與 Pando。
把「用模型寫形式化規格來證明系統正確性」放進一個要服務數千人同時 push 的正式環境,是這整篇文章裡最不尋常、也最值得追蹤的一步。
部署方式同樣值得注意:Pando 最初的部署身分是既有原始碼管理系統的讀寫透傳代理,讓新舊系統保持同步,再分批把流量切過去,全程沒有停機。遷移過程中他們還改了 Git client 本身,引入 explicit haves 概念,讓伺服器可以把分支當前 tip 與推播端可能省略的歷史分開廣告,讓客戶端可以用 --force-with-lease 檢查功能分支有沒有被移動,卻又只針對 trunk 建 pack。這些改動有一部分已經進到上游 Git。
六、對照組:Anthropic 選擇直接廢棄 Git
Pando 不是孤例。Anthropic 在半個月前(10 月 13 日)就發表過〈Redesigning source control at Anthropic〉,處理的是同一個問題,卻走向相反方向。
Anthropic 的數字同樣驚人:2026 年 5 月平均每天合併約 2,500 筆變更,到 9 月已超過 30,000 筆。他們的 main 分支歷史將近 100 GB,壓縮後的工作副本超過 25 GB,光是 CI 每天就做約 2,500 萬次 checkout——若照 naïve 方式抓取,等於每天超過 600 PB 的 Git 流量。他們曾同時維護數百個內部 Git mirror 來應付。
Anthropic 的答案是 Scion:一套自製的版本控制系統,放棄了 Git 協定,花了五個月把整個 monorepo 遷移過去,同期合併量還成長了 10 倍。成果包括:基礎設施的 CPU 與記憶體用量比原本的 Git mirror 架構小 200 倍,CI 與研究任務的 checkout 快兩個數量級(從幾分鐘變成幾秒),CI 單獨省下 25% 的 CPU 容量。他們同樣是七個人做出 Scion 與內部的 code review 工具 Antique。
| 面向 | OpenAI Pando | Anthropic Scion | GitHub(進行中) |
|---|---|---|---|
| 是否保留 Git 協定 | 是,client 也一併改進 | 否,改用伺服器端 RPC | 是,重建底層基礎設施 |
| 一致性模型 | 因果一致性,單一 ref 序列化 | 為 agent 重新設計的取捨模型 | 目標為 agent 規模擴容 |
| 主要成效 | push 延遲降近 80% | 基礎設施用量小 200 倍 | 官方稱「在不中斷服務下重建」 |
| 是否對外提供 | 僅表示「正在探索分享」 | 非產品,非供外部使用 | — |
值得注意的是,連 GitHub 自己也在 2026 年 10 月 6 日發表〈Building Git infrastructure for agent-scale development〉,宣示在 GitHub 持續運作的同時重建底層 Git 基礎設施。三大廠同時動手改寫版本控制,說明這不是單一公司的特殊需求,而是整個產業被 agent 逼出來的共同轉折。
為什麼這件事重要
如果只把 Pando 當成「OpenAI 的內部工具」,就會錯過它真正的意義。這是第一次有人把「AI 寫程式碼」對基礎設施的影響,量化成具體的架構決策。
原因很簡單。傳統開發流程裡,一個工程師一小時能推幾個 commit 是有上限的;當同一個人同時跑十幾個 agent session,每個 session 都在推分支時,抵達版本控制伺服器的速率就不再像人類團隊,而像一座 build farm。Git 的設計前提——少量、緩慢、彼此協調的寫入——被整個抽掉了。
這件事連帶改變三個更上游的判斷:
- **競爭焦點從模型轉向系統。**HN 留言區有人數過,這已經是大型廠商針對同一題目的第五篇重量級文章。當模型能力逐漸拉平,瓶頸會移到那些沒人愛寫但每個人都得用的基礎設施上。
- **「Git 不能用」不再是一個簡單的結論。**過去開發者遇到 monorepo 規模問題,通常的直覺是「換掉 Git」。但 Pando 證明了另一條路:保留協定、重寫後端。這讓所有自架 Git 平台的廠商被追問:你的 per-client pack 產生成本、你的全庫 ref 排序瓶頸,何時能解掉?
- **模型的價值開始從「回答問題」轉向「建構並驗證系統」。**Pando 是用 Codex 寫出來的,再由 GPT-6 Astra 用 Lean 與 TLA+ 形式化證明其性質。這不是模型在寫腳本,而是模型在參與系統的數學保證。寫得多還要證得對,是完全不同等級的工程要求。
對一般開發者而言,最實用的一點可能很反直覺:**Pando 這種規模的系統你用不到,但它的設計原則可以立刻借用。**例如每個 agent 配一條自己的分支、不要假設多分支讀取是同一時間點的快照、在自己的 pipeline 裡量測 push-to-fetch 延遲(這是最便宜卻最常被忽略的協作指標)。
數據解讀與質疑
這篇文章的資訊密度與坦誠度都相當高,OpenAI 也主動寫出了自己的一致性取捨,這點值得肯定。但仍有幾件事必須看清楚。
**第一,所有數字都是廠商自報,且來自單一公司、單一工作負載。**Developers Digest 明確指出他們找不到對 OpenAI 延遲與吞吐數字的獨立驗證。更關鍵的是,官方那個三種一致性模型的互動式比較,OpenAI 自己在文中就把它描述為「模擬」與「教學模型」,不是正式環境的 benchmark。所以「Pando 讀取延遲低 16%」這類數字,不能當成跨系統的通用基準,只適合用來看趨勢。
**第二,「每天 1 PB」是平均值,不是尖峰。**換算下來約等於平均 11.6 Gbps 的持續流量;而「單小時 57 TB」折算約 15.8 Gbps,約為平均值的 1.37 倍。同一套系統能撐住平均值與尖峰、且 99% 來自本地磁碟快取,才是這段數字真正厲害的地方——單看 1 PB 這個數字其實不算驚人。
第三,因果一致性的取捨沒有被量化。官方說「使用者與 agent 對 ref 更新的全域排序並不敏感」,但這是針對 OpenAI 自己的工作流說的。對多數團隊來說,「讀分支 A 再讀分支 B 視為同一個狀態」是很常見的隱含假設,一旦失效,壞掉的不是速度而是正確性——而且這類 bug 會以極難重現的形式出現。
第四,這套東西目前誰也用不了。官方只說「正在探索如何把這項技術分享給使用者」,那不是承諾。文中提到 OpenAI 已在向 Git 上游貢獻 packfile-uri 的改進與 explicit haves 概念,部分改動也已進到上游 Git,這是實質貢獻,但距離一般團隊能部署 Pando 還很遠。
**第五,HN 留言區最大的爭議其實不在技術,而在「這些程式碼是誰要用的」。**多位網友質疑:一個 agent 寫出、人類不讀、只有其他 agent 讀的程式碼庫,除了製造版本控制的負擔之外究竟解決了什麼問題?也有網友舉出 Postgres 團隊因 agent 找到人類程式碼中的 bug 而暫停發布的例子作為反證。**留言區的主流共識並不是質疑工程做得不真,而是質疑這些數字所代表的流量究竟意味著什麼。**這種懷疑是有道理的——量變本身不會自動帶來質變。
**第六,別忘了整個 Pando 是被 agent 寫出來的這個前提。**OpenAI 用一致性測試套件與確定性模擬測試來確保 agent 寫的東西符合標準 Git 行為,這套防線值得信賴,但「用會產生大量重複程式碼的模型,來維護一個服務數千人同時 push 的系統」本身有沒有隱藏的品質債,目前沒有任何公開資料可以判斷。
延伸閱讀與重現資源
- 原始文章:Scaling Git at OpenAI — OpenAI 官方技術部落格,2026 年 11 月 2 日
- Anthropic 對照組:Redesigning source control at Anthropic — Scion,2026 年 10 月 13 日
- GitHub:Building Git infrastructure for agent-scale development — 第三家廠商的同題作文
- OpenAI 維護的 Git 分支 — 含 explicit haves 等改動
- OpenAI Git 修補追蹤站 — 送往上游 Git 的修補進度
- Developers Digest 深度分析 — 對廠商數字的保留態度與實務建議
- The New Stack 報導 — OpenAI 與 Anthropic 兩種路線的對照
- Hacker News 討論串 — 241 分/165 則回覆
- OpenAI Developers 官方 X 說明 — 官方帳號的摘要說明
- GitLab:Next-Gen SCM 架構說明影片 — 同一位於 agent 規模擴容的第三方方案
編按補充:本文所列的「GPT-6 Astra」為 OpenAI 之模型,「Pando」與「Scion」分別為 OpenAI 與 Anthropic 之內部系統名稱。文中所有效能數字均為廠商自報,OpenAI 官方亦將其模型比較標示為模擬教學用途;引用時請一併保留此限定。相較之下 Anthropic 一側的數字(每日合併量、checkout 數量、基礎設施用量縮減)同樣來自 Anthropic 官方文章,本文已盡量標明來源,並於正文中說明兩者不可直接互相比較。
網友熱門留言 (12)