編按:本文綜合整理自 Figma 官方部落格〈How we’re training a Figma-fluent editing model〉、Figma 官方〈Building Figma AI〉技術說明頁、Figma 官方〈3 ways product designers use the Figma agent〉、Canva 官方新聞稿〈Introducing Canva Brush〉、Canva 官方新聞稿〈Introducing Canva Craft〉、Hacker News 討論串(89 分/40 則回覆)、Canva 官方 X 貼文 與 The AI Economy 對 Canva Brush 的分析報導,並加入 Siami 編輯部觀點與分析。
2026 年 10 月 29 日,Figma 軟體工程副總 Josh Clemm 在官方部落格公開了一篇題目直白的文章:〈How we’re training a Figma-fluent editing model〉。
官方文章的標題翻成中文,就是「我們在訓練一個懂 Figma 的編輯模型」。這是 Figma 第一次把自家 agent 背後的模型訓練細節攤開來講——從監督式微調、強化學習,到評估方法與官方成效數據,全部寫在明處。
而就在同一天,Canva 也發表了首個專為設計打造的視覺語言模型 Brush。兩家設計工具的巨頭,在同一個上午,各自交出同一張牌:不再只是呼叫最前沿的通用模型,而是自己訓練一個專用模型來改設計。
一、為什麼連最前沿的模型都改不好設計
Figma 團隊從 agent 一開始就挑了一個很窄的任務:協助設計師修改畫布上「已經存在」的設計。
官方文章點名了設計日常工作的樣貌——調整間距、改一個顏色、有人給了意見之後重排版面。這類工作的特徵是:單次改動很小、迭代頻繁,而且結果很難驗證。沒有標準答案可以對,也沒有測試可以跑。
Figma 遇到的問題是:最前沿的模型連 Figma 自己的語法都看不太懂。要讓通用模型用對,只能靠堆系統提示字(system prompting),代價是極度耗 token。
「我們看到專門的後訓練(post-training)可以跟前沿模型競爭。這裡分享的是我們如何把這件事搬到設計編輯工作流上的研究過程。」—— Josh Clemm,Figma 軟體工程副總
二、監督式微調:一條能走通的路,和它的天花板
團隊的第一條路是監督式微調(SFT)。每一筆訓練樣本包含三件事:
- 一份起始的設計
- 一個合成的編輯請求
- 一次成功的修改範例
關鍵在於,設計是用 Figma 原生檔案格式表示的,所以模型產出的變更可以直接套回畫布,不用再經過一層轉譯。當任務牽涉設計系統資產時,管線另外產生涵蓋主題與元件變更的合成提示。
接下來是候選生成的環節:團隊讓更大的教師模型去嘗試執行這些編輯,再用兩道關卡篩選——確定性驗證器檢查輸出是否合法,視覺模型裁判檢查有沒有真的滿足請求。整條生成管線具備自我修復能力,可以拿評測回饋回頭修正修改結果。
這條路的效果好到有點意外:官方提到,早期版本用 Llama 3.3 70B 訓練了超過 25 萬筆樣本,就在當時的編輯任務上與當時最頂尖的模型相當。
但天花板同樣明顯。模仿學習(imitation learning)的代價是泛化能力流失——模型會產出跟訓練時看過的很像的設計;而且樣本效率差,訓練要靠大量樣本去覆蓋任務的各種面向。
三、轉向強化學習,把「好看」變成可打分的東西
後來團隊換上更強的基底模型,包括較新的 Qwen 系列、Muse Spark Open、Inkling,並把重心轉向強化學習(RL)。官方描述的工作重點有四項:
- 打造設計領域專用的 RL 環境
- 拉高訓練樣本整體的多樣性
- 塑形獎勵模型
- 擴充由專家撰寫的評分準則,讓獎勵貼近設計師真正在乎的事
評估方式同樣被拆得很細。官方強調「好設計」很主觀,但不代表品質只能當成無法測量的東西:
- 一個設計可以有良好的對齊,卻有糟糕的對比
- 一次編輯可以看起來精緻,卻整個沒接到請求
- 一顆按鈕可以長得對,卻用了錯的元件
他們把這些維度拆開個別評分,AI 生成設計最常見的三種錯誤被明確點名:圖示與文字重疊、箭頭被裁切、文字元素重疊。實際做法是結構檢查加上視覺裁判,再用專業設計師校準與複核結果。
官方比較的是尚未發佈的 Figma 編輯模型——以 Qwen 3.8 27B 後訓練——與其他第三方模型在設計編輯任務上的成績。
四、官方成效:62%、33%、60% 這三個數字
Figma agent 在 2026 年 10 月 6 日從開放測試轉為正式版(GA),這篇研究正是它背後模型的第一次公開解剖。官方揭露的數字:
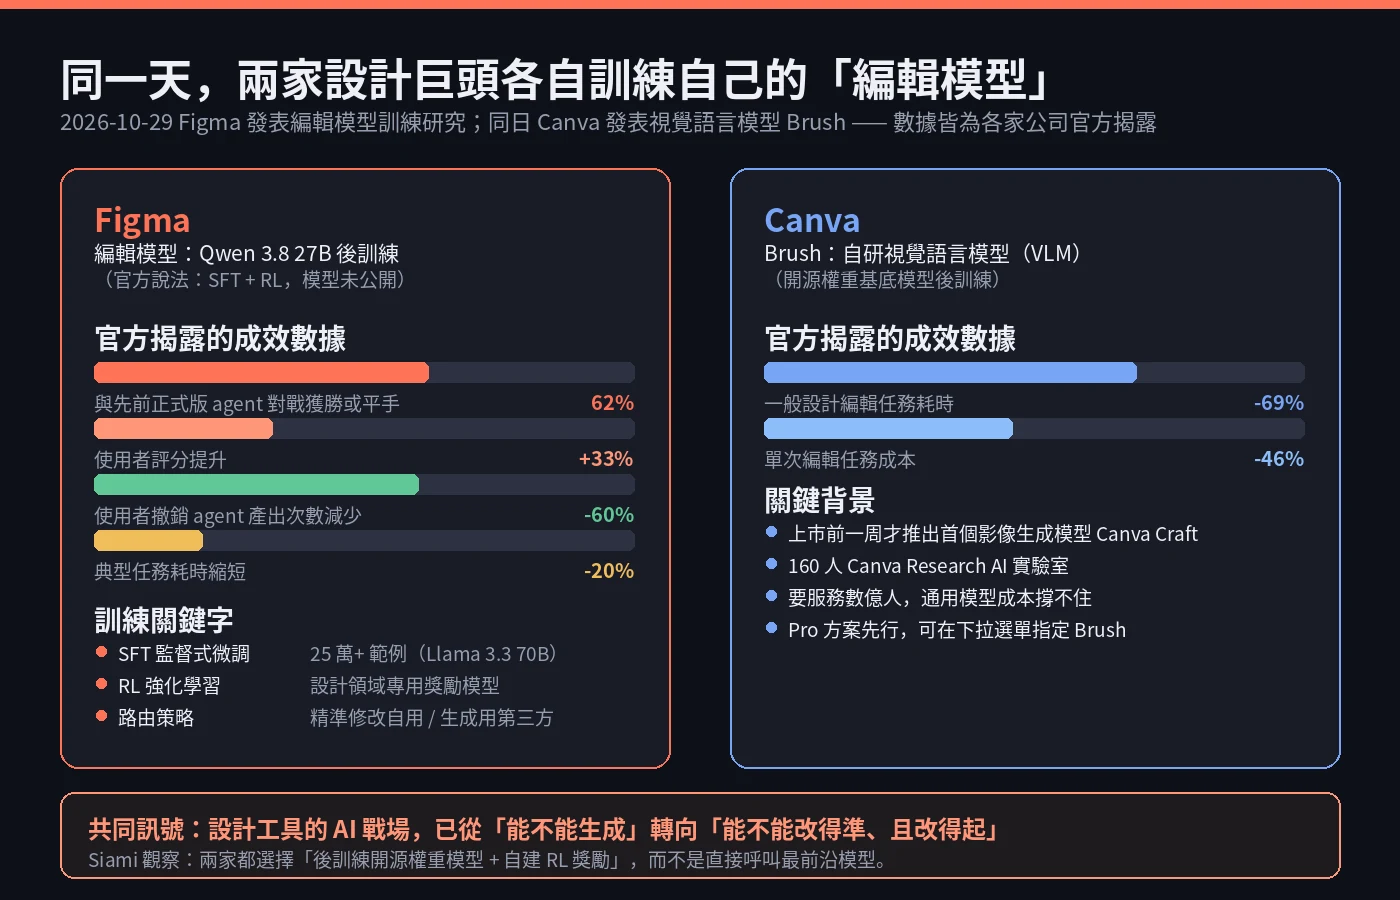
- 從 beta 到正式版之間,典型任務快約 20%
- 與專家設計師一對一對戰,62% 的機率勝出或打平先前正式版的 agent
- 使用者評分提高 33%
- 使用者撤銷 agent 產出的次數減少 60%
- 由自研後訓練模型處理的作業占比翻倍以上,單則訊息的平均成本下降
架構上,agent 會同時跑自家模型與第三方前沿模型:影像生成、向量圖、全新設計探索交給當下最強的第三方模型;精準修改與迭代交給自家模型。這是一種明確的分工,而不是二選一。
五、同一天,Canva 也交出同樣的答案
Canva 在同一天(10 月 29 日)公布 Brush,自稱是首個為設計打造的視覺語言模型,架構上是一個會讀懂版面結構、圖層與「整體調性」的 agentic loop,背後靠寫程式碼調整設計元素、再回頭檢視畫面來決定下一步。
Canva 官方給的數字是:一般設計編輯任務最高提速 69%、單次編輯任務成本降低 46%,並強調「再漂亮的編輯,如果沒改到位也沒有意義」。
技術路線與 Figma 高度重疊:從領先的開源權重模型出發,在真實設計與編輯任務上後訓練,再結合大規模強化學習。獎勵系統會評估視覺品質、版面是否符合設計原則、任務是否完成,評分依據來自設計專業、設計庫,以及數十萬次模擬互動;Canva 明說,什麼叫「好」的定義,是由團隊裡真正的專業設計師訂定的。
Canva 團隊也解釋了經濟動機:通用模型有能力處理設計編輯,但同樣的能力意味著更貴的執行成本。當有數億人在 Canva 上創造數十億份設計時,每個編輯多花幾美分都會累積成天文數字。
一個禮拜前 Canva 才推出首個影像生成模型 Canva Craft,並因此讓 Canva 依 DesignArena 的評測成為全球影像生成能力第二強的 AI 實驗室。Craft 負責生成,Brush 負責修——兩週內連推兩個模型,節奏相當明確。
六、為什麼這件事重要
設計工具的 AI 競賽,正在從「能不能生成」轉向「能不能改得準、而且改得起」。
生成一張圖或一版設計,是一次性、可驗收的輸出;修改一份既有設計,則要求模型同時理解「要改什麼」與「什麼必須保持不變」。Canva 的官方說法很直白:如果模型不知道什麼該留,一個簡單的編輯請求就會變成一堆你根本沒要求的改動。
而「改得起」這三個字,才是這兩篇官方文章真正共同的主軸。Figma 選擇把自研模型與第三方模型分工路由、並且公開「單則訊息平均成本下降」;Canva 直接把「成本降低 46%」寫在新聞稿標題。對一個要服務數億使用者的平台來說,AI 的單位經濟模型比模型排行榜更能決定成敗。
更值得注意的是時間軸。Figma 這條路是從 agent 開始做才發現「前沿模型連語法都不懂」,才被迫走後訓練;Canva 則是先做了生成模型,隔了一週才補上編輯模型。兩家都在同一個星期把「自己訓練專用模型」這件事攤到檯面上,這在設計工具的歷史上是罕見的同步。
七、數據解讀與質疑
「62% 勝出或打平」是個有意義的數字,但比較基準要自己看。 這是自家模型對自家上一代正式版 agent 的比較,測試條件由 Figma 自己定義、評分由自家設計師校準。Figma 在 10 月 6 日那篇產品公告裡用的是比較保守的說法「在約 60% 以上的人評測中勝出」,這次換成更具體的 62%。數字本身不矛盾,但它的可比性只在 Figma 內部成立,外界無從複核。
Qwen 3.8 27B 這個基底模型的選擇才是重點。 這是一個 27B 規模的開源權重模型,官方卻說它「與其他第三方模型」在設計編輯任務上處於同一個評測區間。換句話說,Figma 花大成本訓練出來的專用模型,強項不在「比前沿模型更強」,而在「用便宜得多的模型做到同樣的編輯品質」。這與 Figma 官方反覆強調的速度、成本目標是一致的,也解釋了為什麼 agent 要同時掛載兩套模型。
留言區的質疑比官方數字更值得讀。 這篇討論串裡反覆出現的論點是:既然 coding agent 已經能直接產出 HTML/Tailwind 介面,「為什麼還需要 Figma 這種中間格式?」有開發者說自己已經完全不用 Figma,改為維護一條 /design/{project} 路由、讓 agent 直接寫 html/css/react;也有人直指 Figma 的 MCP 品質不佳、API 限制太緊。
這不是空穴來風。Figma 自己的架構說明也透露了一個關鍵細節——agent 需要從畫布與設計系統取得脈絡,而當產品脈絡不在 Figma 裡,模型就會開始漂移並幻用自己的樣式。換句話說,Figma 這條後訓練路線能解決「模型不熟 Figma」,但解決不了「設計根本不在 Figma」。
相關延伸
- Figma 官方部落格〈How we’re training a Figma-fluent editing model〉 — 本文主要來源
- Figma 官方〈Building Figma AI〉 — 第一方模型策略、訓練資料與隱私揭露
- Figma 官方〈3 ways product designers use the Figma agent〉 — agent 轉正式版與設計系統技能
- Canva 官方新聞稿〈Introducing Canva Brush〉 — 同日發布的競爭對手方案
- Canva 官方新聞稿〈Introducing Canva Craft〉 — 一週前的影像生成模型
- Hacker News 討論串(89 分/40 則回覆) — 設計師與開發者的第一手反應
網友熱門留言 (8)