編按:本文綜合整理自 Anthropic 官方研究部落格〈Progress on provable inference for large language models〉、FlashProve 技術報告、GitHub 開源專案 anthropics/FlashProve、Help Net Security〈Anthropic FlashProve: Provable inference now open source〉、Unite.AI〈Anthropic Releases FlashProve for Cryptographic AI Inference Proofs〉 與 Hacker News 討論串(207 分/93 則回覆),並加入 Siami 編輯部觀點與分析。文中所有效能數字均引述自 Anthropic 原始發表內容。
當你跟一個 AI 對話的時候,你有沒有辦法確認「這一段回覆,真的是你選的那個模型寫出來的」?
現實情況下,多數人直覺答案是「應該是吧」,然後就繼續往下問了。但這裡藏著一個正在快速變得尖銳的問題:市面上的模型路由服務會不會為了省成本,把你付費買的旗艦模型悄悄換成便宜的小模型?開發團隊做的第三方評測,跑的到底是不是他們以為的那個版本?駭客動了伺服器上的權限,你能不能察覺?
Anthropic 在 11 月 2 日公布的研究裡,給出的答案是一個相當反直覺的工程選擇:不要相信,來證明。
一、FlashProve 到底在做什麼
這套系統的名字叫 FlashProve,屬於 Anthropic Frontier Red Team。核心概念是「可證明推理」(provable inference):模型提供者先對自己的權重做出承諾,然後在每次回答時附上一份密碼學證明,讓使用者能在不持有權重、也不需要大量算力的前提下,驗證這段回答確實出自那個被承諾的模型。
機制選的是 zkSNARK(零知識簡潔論證)。用最白話的說法:
- 零知識——證明檔本身不會洩漏模型權重的任何資訊。提供者可以放心讓證明流通到客戶手上。
- 簡潔——驗證成本相對被證明的運算量大幅下降。實測只要一台一般電腦的 CPU,24 執行緒約 17 秒、單執行緒約 21 秒就能驗完一份證明。
- 綁定——證明與特定權重承諾綁死。攻擊者就算完全入侵了推論伺服器,也無法替換成別的權重還生出有效證明,因為那等於要破解被廣泛相信的密碼學假設。
整個流程分兩個階段。離線階段,提供者公布一份權重承諾值——一個短指紋,用來釘住「到底是哪一組權重」,但權重本身仍然隱藏。在線階段,使用者送出提示詞、收到回覆,旁邊多了一個證明檔。任何同時握有承諾值、提示詞與回覆的人,都能確認「被承諾的那組權重跑出這個提示詞,產生了這些 token」。
FlashProve 這套 release 一次交付了五項成果:這篇研究部落格、一份技術報告、一份由 Claude 寫成的協定規格文件、可執行程式碼(包含 prover、兩個 verifier——一個是 C++ 寫的高速版,一個是用 Lean 寫的可證明正確版本),以及 Lean 證明與一個互動式視覺化工具,方便稽核者檢視定理結構。全部以 Apache 2.0 釋出。
合作名單也說明這件事的分量:Anthropic 的 Roy Rinberg 與 Alex Allain、EPFL 與 StarkWare 的 Alessandro Chiesa、MIT 與 RESI 的 Miranda Christ、Anthropic STEM Fellows 與 Succinct 的 Rahul Dalal、EPFL 的 Giacomo Fenzi,以及 Anthropic Fellows Program 與 MIT 的 Ben Mayer、EPFL 的 Guy Weissenberg。
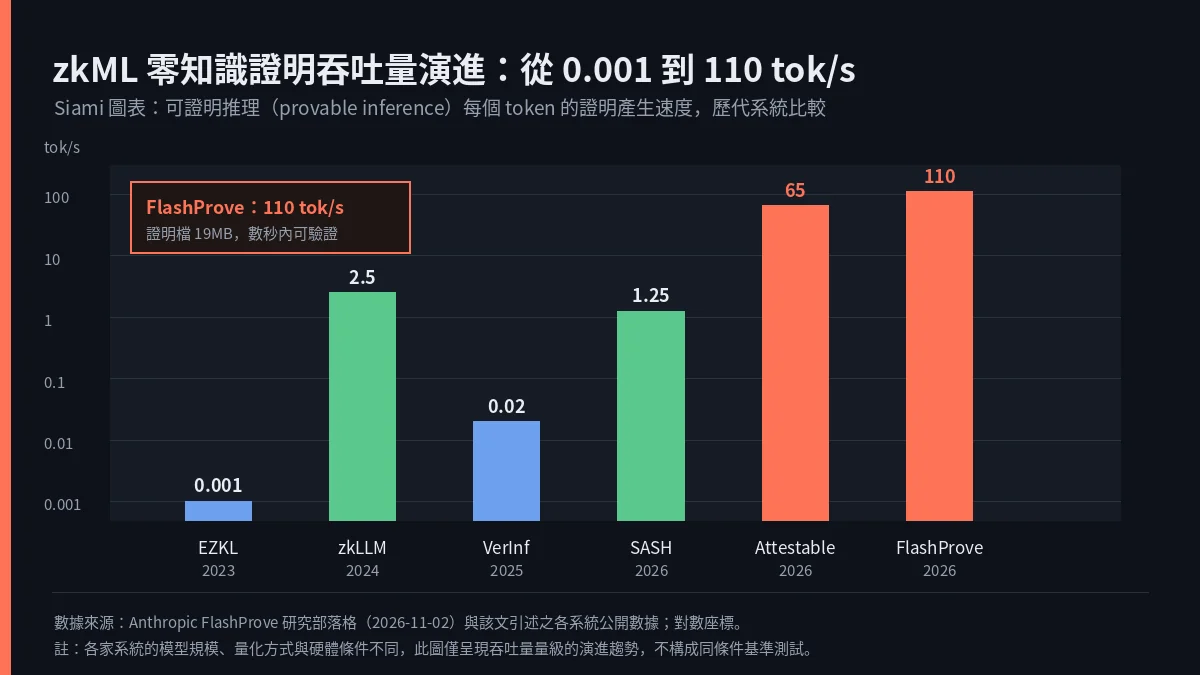
二、數字:從 0.001 到 110 tok/s
這條線的歷史比多數人想像的長。zkML(用零知識證明做機器學習推論)從 2017 年就開始了,但很長一段時間裡,它證明的模型小到沒有任何實際意義——SafetyNets 證明的是兩層卷積的 MNIST CNN。
真正的轉折點在 2024 年。zkLLM 用 GPU 證明了 LLaMA-2-13B,速度約 2.5 tok/s;2025 年 zkGPT 把 GPT-2 拉到 21.8 秒/token;同年的 zkPyTorch 用單一 CPU 核心證明 Llama-3 8B,約 150 秒/token。
而在 2025 年,前作 VerInf 為同一個模型(Llama 4 Maverick,400B MoE)做證明時,需要 14.3 小時產生 1,000 個 token 的證明,證明檔大到 93.6 GB,幾乎要花一整天才驗完。
FlashProve 把這條曲線整個拉平:
| 系統 | 年份 | 模型 | 證明速度 | 備註 |
|---|---|---|---|---|
| EZKL | 2023 | 1M 參數 GPT 式架構 | ≈0.001 tok/s | 每 token 約 966 秒 |
| zkLLM | 2024 | LLaMA-2-13B | ≈2.5 tok/s | GPU 上約 15 分鐘/2,048 token |
| VerInf | 2025 | Llama 4 Maverick | ≈0.02 tok/s | 證明檔 93.6 GB,驗證近一天 |
| SASH | 2026 | Llama 3.1 8B | ≈1.25 tok/s | 單張 H100 |
| DeepProve | 2026 | GPT-2 / Gemma 3 | 2.9 / 1.4 tok/s | 同級已發表 SOTA,分散式可達 31 tok/s |
| Attestable | 2026 | Gemma 4 31B | 53–77 tok/s | 商業系統,尚未釋出開源函式庫 |
| FlashProve | 2026 | Llama 4 Maverick | >100 tok/s(實測 110) | 單張 H100,證明檔 19 MB |
Anthropic 自己的評語是:這些數字應該要更新外界對「零知識裡到底能證明什麼」的先驗判斷。
三個設計決定是關鍵。第一個是 MoE 結構的紅利:在 400B 參數的模型裡,每個 token 只會用到約 17B 參數,而 prover 的工作量是與「實際跑到的那些專家」成比例,不是與全部 400B 成比例。證明仍然隱藏了究竟是哪幾個專家被選中,但 prover 的計算量降到全參數的約 4%(400B 裡每個 token 實際只用到約 17B)。
第二個是批次化的事後證明(post-hoc proving)。 prover 讀完已完成的文字後,用一次平行掃描處理,並且每批次只對權重承諾開一次,而不是每個請求開一次。
第三個是硬體門檻。權重被切成片段,單張 80 GB GPU 搭配約 290 GB 主機記憶體就能跑完,不需要多卡叢集。
三、Anthropic 為什麼要在意這件事
官方在文章裡列了四類信任挑戰,每一類都指向同一個提問:「你怎麼知道?」
- 節奏管制(pacing)——監管機關可能要求提供者把硬體用於推論而非訓練。提供者可能想作弊:改用便宜模型服務,或把算力挪去訓練別的東西。監管者可以要求一批請求的證明;證明必須顯示這些請求確實由宣稱的模型產生,惡意提供者就無法通過。同一份機制也讓提供者保住 proprietary 的模型資訊——監管者能驗證聲明,卻學不到權重。
- 竄改偵測——當模型越來越有自我改進與部署的能力,一個更強的模型可以頂替被授權的模型運作,並假裝自己是較弱的模型以避開分級器與監控。提供者可以要求伺服器對每個回覆交出有效證明;駭客若佔領了伺服器,就必須替預期的權重生出有效證明,而這件事做不到。
- 出處溯源(text provenance)——開發者可能宣稱「這個函式庫已經被前沿資安模型掃過」。但就算公開對話紀錄也不構成絕對保證,因為開發者理論上可以用便宜模型偽造這些紀錄。證明機制可以讓這類聲明變成可驗證的事實。
- 模型核准——若法規要求只能服務「已核准為安全」的模型,提供者就有動機繞過(因為高風險模型可能更強或更便宜)。監管者要求每個回覆附證明,就能強制這個約束。
Anthropic 也提到一個延伸應用叫做「Proof-of-Failure」:在釋出程式碼之前,提供者可以交出一份證明,證明「我在這個特定模型上至少花了 X token,而且沒有達成這個結果」——例如,這個模型在嘗試至少 100 萬 token 之後,確實沒有在這個 patch 上找到任何 bug。
值得注意的是,Anthropic 在自己的 Frontier Safety Roadmap 裡,早就承諾過「2026 年 9 月 30 日前做出可證明推理的原型」,把 AI 模型的輸出「簽章」成可歸因於特定權重。他們說這項承諾是透過一個「separate but related」的專案達成的——簽署推論流量,並在受信任的伺服器上重算推論;這篇部落格則是用另一種方法 pursue 同一個目標。
這是一條從資安研究一路接到 AI 治理的線。
四、為什麼這件事重要
第一,它把「模型偷換」從信任問題變成可驗證的事實問題。 過去一年整個社群最瀰漫的抱怨不是「AI 變笨了」這種模糊感受,而是「我付了旗艦模型的錢,它卻給我小模型的答案,而我不知道」。這些抱怨之所以無法解決,不是因為沒有人懷疑,而是因為使用者手上沒有任何能拿來對質的工具。FlashProve 提供的正是那個工具:承諾值可以公開、可以重算,證明可以被第三方獨立驗證。這件事一旦被主流模型廠商採用,「eyes glaze over」這種靜默降級在技術上就變成了一件可以被主動抓包的事。
第二,AI 管制第一次有了可執行的技術抓手。 過去所有關於 AI 節奏管制的討論都卡在同一個死結:監管者要驗證「這家公司的硬體真的在跑推論」,但沒有任何技術手段能做這件事。Anthropic 在文章裡說得很直白,這類提議通常只能靠硬體層級的監控裝置(trusted execution environment)來做,而那需要製造商提供防篡改硬體——信任鏈拉得越長,主權越容易流失。zkSNARK 走的是純軟體路線,就算硬體、作業系統、整個環境都被攻陷,攻擊者仍然生不出無效證明。這意味著監管者第一次可以在不動用駭客級入侵能力的前提下,取得可稽核的證據。
第三,這是形式化驗證從「驗證程式」走向「驗證推論」的下一站。 Anthropic 上個月(10 月 22 日)另一篇形式化驗證的工作,是讓 Claude 為 123 個開源函式庫、1.8 億行機器碼層級的證明碼做形式化檢驗——證明「這套測試永遠會通過」。這兩件事其實是同一條路線的兩端:一端是把程式碼的正確性變成可以機器檢查的命題,另一端是把「這個回答來自這個模型」變成可以機器檢查的命題。當 Anthropic 這次用 Lean 寫出協定的安全性質時,那份 Lean 證明本身就是前一份工作的延伸。
第四,也是台灣業者最需要留意的一條。 台灣的 AI 生態鏈裡,模型轉售商、雲端 GPU 代管服務、API 聚合平台、以及大量替企業導入 AI 的系統整合商,構成了一條長長的「你不知道你實際拿到的是什麼」的灰色地帶。過去這條鏈的信任基礎是合約與品牌;當證明機制成熟,「這張卡上跑的到底是不是你宣稱的模型」會變成一個可以逐案稽核的技術事實。對做 AI 服務的中小型業者來說,這既是新的信任資本,也可能是新的揭露義務。
五、數據解讀與質疑
關於「110 tok/s」這個數字。 這是單張 H100 產生證明的速度,代表的是 prover 端。但同一份技術報告也給了另外兩個數字:產生證明所需的時間約為 vLLM 處理相同請求的 70 到 95 倍(實測 72 倍,多次執行落在 66 到 77 之間,在 vLLM 滿載時則是 94 倍)。換句話說,跑 FlashProve 等於多花 70 到 95 倍的 GPU 時間在做同一件事。這是一個非常昂貴的奢侈品——Anthropic 自己也說明,這是「研究原型」,目標是展示 zkSNARK 用於可證明推理在技術上是實用的,而不是提供一套可以立刻上線的服務。
關於那個「70 到 95 倍」的比較基準。 這組數字的比較條件並不對等,一份認真的評讀必須把這點講清楚:FlashProve 是 4-bit 量化的整數權重、單張 H100、prover 端 24 個 CPU 核心;對照組 vLLM 則是 FP8 發布版、8 張 H100 跑同一模型。不同的量化格式、不同的硬體數量、不同的批次負載,得到的數字自然不是同條件基準測試。所以「比 vLLM 慢 72 倍」應理解為「在同一個任務裡,多花了大約兩個數量級的算力」,而不是「這套系統比現有推論引擎慢 72 倍」的普遍化結論。
關於上下文長度這道硬牆。 FlashProve 目前只能證明最長 1,024 個 token 的上下文。這是相當短的一截——前沿模型的上下文窗口動輒數十萬到上百萬 token,日常聊天累積的長度早已遠遠超過。也就是說,FlashProve 今天能證明的是「這開頭的一段回答」,不是「整場對話」。這是所有技術進步故事裡最容易被跳過的一項,但它直接決定了這套系統在實際使用場景中的適用半徑。
關於「證明的是貪婪解碼」這件事。 官方明確說明,證明斷言的是每個被檢查的 token 都是該模型的「greedy choice」。但真實的推論服務幾乎都會用溫度採樣,這代表證明所覆蓋的模型行為與實際生成行為之間存在一個需要額外處理才能對上的落差。這道落差在實務上如何收斂,是這套系統從研究原型走向部署時必須回答的問題。
關於整數權重與浮點誤差的縫隙。 HN 上有網友直接追問這個問題:如果證明的是「已發布權重的整數版本」,而實際推論跑的是浮點實作,那證明還成立嗎?Anthropic 的回答是,整數版本在實測上預期與真實浮點推論維持在一個很小的誤差率內,並且承認這個保證不涵蓋對抗性設計的提示詞。換句話說,證明不是零和的,它是一個有明確邊界的近似保證,而這個邊界會隨著對抗性提示詞的演化而被一點點試探。
關於「FlashProve 到底解不解決資料外洩」的質疑。 這是 HN 上反對派最有力的一擊。灰區網友 grey-area 的說法是:這整套東西只回答「用的是哪個模型」,不回答「我的資料有沒有被外流」。如果攻擊者已經能改動你的 token 串流,那他大概也能做更多惡意的事;而如果駭客在端點後面做手腳,你真正該擔心的是資料流的問題,不是模型的身分。有意思的是,Anthropic 自己的文章其實也承认了這道邊界——它特別指出,zkSNARK 驗證的是「硬體確實在服務推論」,但並不能證明「硬體沒有在旁邊偷偷訓練」。這是一份相當誠實的技術文件,不假裝自己能解決所有問題。
最後一個必須誠實面對的質疑:這到底是不是公關。 HN 上有網友說得直接——這看起來像是一場公關操作,畢竟這是一間曾被指出「在未告知用戶的情況下把請求路由到較弱模型」的公司。另一派則反駁指出,如果 Anthropic 能解決這個問題,大部分「今天是不是只有我覺得 Opus 特別奇怪」的雜訊就會蒸發掉——這恰恰是使用者在抱怨最多的地方。公允地說,這兩邊都觸及了真實面向:技術本身確實有價值,且確實開源、可重現、可用第三方工具攻擊測試;但一份由涉事廠商發布、又被廣泛轉載為「重大突破」的技術報告,其激勵結構無疑會影響敘事方向。
值得注意的是,Anthropic 在 10 月 19 日的更新中,已經把原本的目標名稱從「provable inference」改成「inference verification」。官方的解釋是:原始目標是達成「token 串流完整性」的高階保證,這可以用多種方式達成,而「provable inference」這個詞暗示的途徑比實際上更窄。這個改名本身就是一個訊號——他們自己也認為,純靠密碼學證明不是唯一也不是最終的答案。
六、相關延伸
- Anthropic 研究部落格〈Progress on provable inference for large language models〉|本篇主要來源,FlashProve 完整技術說明
- FlashProve 技術報告|協定細節與工程設計
- GitHub:anthropics/FlashProve|Apache 2.0 開源程式碼、Lean 證明與文件
- Help Net Security〈Anthropic FlashProve: Provable inference now open source〉|資安媒體的技術角度整理
- Unite.AI〈Anthropic Releases FlashProve for Cryptographic AI Inference Proofs〉|發布當日的第三方報導
- Hacker News 討論串(207 分/93 則回覆)|社群對「這是公關還是真技術」的主要辯論場
- Anthropic 官方 X 貼文|官方發布聲明
- Wikipedia:zkSNARK|零知識簡潔論證的技術背景
網友熱門留言 (6)