編按:本文綜合整理自 OpenAI 官方研究〈A thousand fewer paths to root〉、OpenAI 官方 X 貼文、The Hacker News〈OpenAI AI Pipeline Generates 948 Linux Root Escalation Exploits〉、Unite.AI〈OpenAI Pipeline Finds 948 Linux Kernel Privilege Escalation Flaws〉、Security Boulevard〈Linux Kernel TCP Flaw Rated 9.8 Gets a Remote-Root Exploit from an AI Model〉、OpenAI〈Patch the Planet: global response coordination as agents uncover vulnerabilities〉 與 Hacker News 討論串(429 分/315 則回覆),並加入 Siami 編輯部觀點與分析。文中所有數字均引述自 OpenAI 原始發表內容。
2026 年 11 月 4 日,美國時間晚間,OpenAI 官方 X 帳號丟出一則貼文:
我們的資安研究員打造了一套自動化的網路漏洞探索、榨取與修補管線。在一次以即將推出的 cyber 模型為核心的執行中,它驗證並產出了 Linux 核心 948 個本機提權漏洞的修補,總 API 成本為 120 萬美元。
隔天早上,這篇研究在 Hacker News 上拿下 429 分、315 則回覆。留言區最被轉載的一句提問是:「我們到底是怎麼走到核心有一千個提權 exploit 這一步的?」
這個問題的答案,比 948 這個數字本身更值得看。
一、948 是怎麼跑出來的
OpenAI 這次的目標很直白:Linux 核心。理由寫在研究裡——這套核心支撐著 Android 裝置、雲端基礎設施、超級電腦,程式碼超過 4,000 萬行,透過系統呼叫、網路、檔案系統與裝置驅動程式暴露出極廣的攻擊面。
管線分成五個階段,每一階段都由代理程式(agent)執行,最後才有人工資安研究員接手複核:
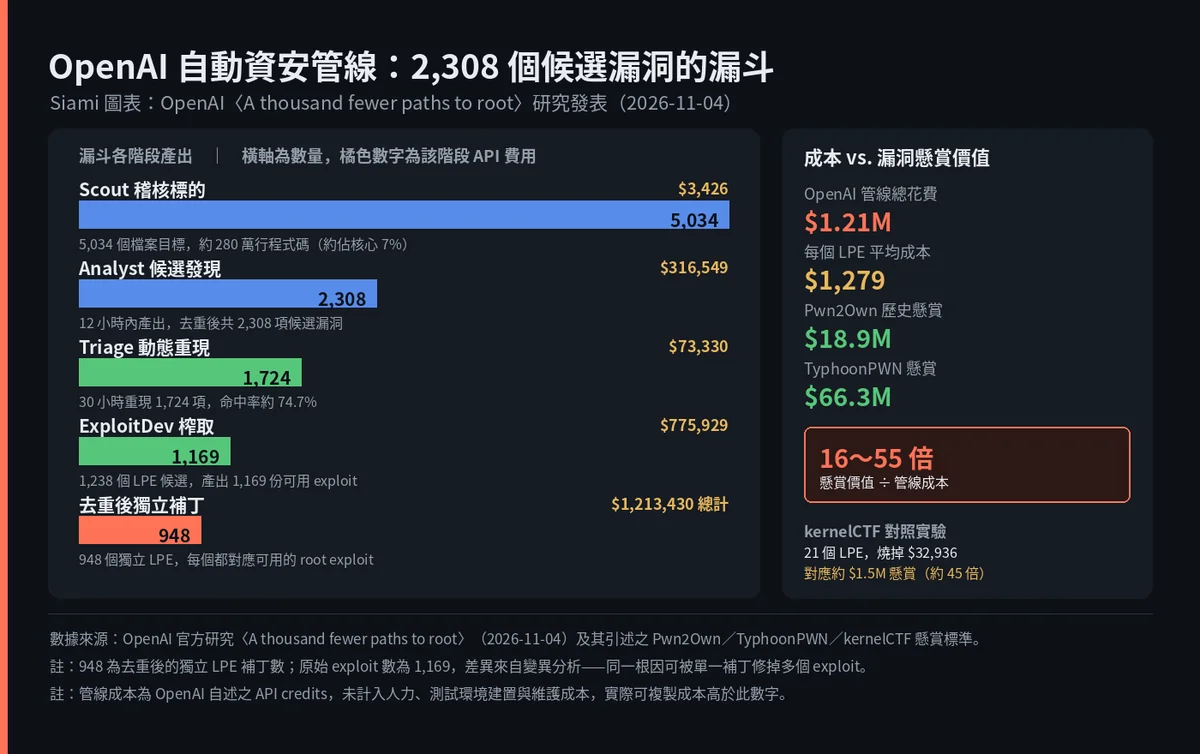
- 漏洞發現(Vulnerability discovery) — Scout 代理先讀遍每個資料夾與檔案,依據「能否被低權限使用者觸及」和「安全相關性」挑出值得稽核的目標,共 5,034 個檔案目標、約 280 萬行程式碼,約佔整個核心的 7%。接著 Analyst 代理逐一閱讀目標程式碼、建立威脅模型、尋找漏洞,12 小時內產出 2,308 個候選漏洞。
- 動態驗證(Dynamic validation) — 這是整條管線最關鍵、也最燒錢的關卡之一。Triage 代理為每個候選漏洞生成概念驗證(PoC),放進跑著 Linux 核心並開啟 Kernel Address Sanitizer(KASAN)的隔離虛擬機裡實際打,觀察程式輸出與系統主控台,然後反覆修正 PoC 直到重現成功或窮盡所有可能的觸發方式。30 小時內重現了 1,724 個漏洞,約佔候選的 74.7%。
- 可利用性評估(Exploitability assessment) — 篩選代理先做寬鬆的靜態篩選,收斂到 313 個資訊洩漏候選與 1,238 個提權候選。接著 ExploitDev 代理在開啟 SMEP、SMAP、KASLR、HARDENED_USERCOPY 等標準防護的環境中測試,產出 291 份資訊洩漏 PoC 與 1,169 份真正可用的提權 exploit。
- 修補生成(Patch generation) — 對每個已驗證漏洞,代理生成對應補丁,並被要求執行靜態檢查、遵循鄰近程式碼的開發慣例、做變異分析確保補丁完整。
- 人工複核(Human review) — 資安研究員審查 exploit、補丁與建議嚴重度後才對外回報。
這條漏斗的完整數字與各階段花費,請見文內 Siami 圖表。
二、120 萬美元買到了什麼
把帳攤開看,管線的 121.3 萬美元花費分布其實很不平均:
| 階段 | API 費用 | 佔比 |
|---|---|---|
| Scout 稽核標的篩選 | $3,426 | 0.3% |
| Analyst 候選漏洞發現 | $316,549 | 26% |
| Triage 動態驗證 | $73,330 | 6% |
| ExploitDev 榨取 exploit | $775,929 | 64% |
| 總計 | $1,213,430 | 100% |
平均每個獨立 LPE 的成本是 1,279 美元。OpenAI 拿來對照的 benchmark 是漏洞懸賞:歷史上 Pwn2Own 對 Linux 核心本機提權開出的懸賞是 2 萬美元,TyphoonPWN 是 7 萬美元。948 個乘下去,虛構價值落在 1,890 萬到 6,630 萬美元之間,約為管線成本的 16 到 55 倍。
他們也做了第二組對照實驗,目標換成 Google 資安研究團隊的 kernelCTF 計畫——那是一個刻意強化過攻擊面的核心版本。管線在 112 小時內跑完,燒掉 32,936 美元,取得 25 份資訊洩漏 PoC 與 21 個提權 exploit(對照組:kernelCTF 2026 年至今已接受 26 個確認的 0-day LPE)。若這 21 個全數被接受,約等於 150 萬美元懸賞收入,約為成本的 45 倍。
值得記下的是,OpenAI 自己主動註明了這套比較的侷限:這只算 API token,沒有計入人力、測試環境建置與長期維護成本,而且不同外部實體拿到的推論服務等級並不相同。評論區有人因此直接開火,認為這種「犬儒的比較」暴露了真實意圖——想讓所有人失業。
三、兩個最誠實、也最容易被略過的細節
研究裡有兩段自我揭露,坦白到不太像行銷稿。
第一個是「用錯 0-day」。 在一次早期執行中,ExploitDev 代理回報了 200 個成功的提權 exploit。人工複核時發現,其中 20 個其實是透過另一個沒被指派的 0-day 拿到 root 的。這意味著,連「agent 成功拿到 root」這件事本身都需要獨立驗證——你得確認的不只是結果,還有通往那個結果的路徑。團隊後來收緊了任務條件,並加上獨立檢查,確認每份最終 exploit 確實用了它被指派的那個漏洞。
第二個是「更強的模型需要更少的調教」。 團隊比較了 GPT-5.5 Cyber 與 GPT-5.6 Cyber。GPT-5.5 Cyber 無法穩定判斷何時該套用既有的核心利用技術,於是他們把 103 項技術整理成模型友善的格式放進代理環境並提示使用,在 63 個榨取候選上成功率從 76.2% 提升到 88.9%。換成 GPT-5.6 Cyber 後,模型自己就能找到、選擇並應用合適的技術,團隊於是把整層技術編排拿掉,結果這個更輕的編排版本反而贏過了重度搭架的 GPT-5.5 版本;把技術層加回去,只多掙到 1.5 個百分點。
同一篇研究裡,模型強弱也直接反映在成果上:7 月底由 GPT-5.6 Sol 執行時挖出 166 個獨立 LPE,端到端花 51.3 萬美元;10 月中由新的 cyber 模型執行,數字變成 948 個、花 121.3 萬美元。
而最讓人不安的數字,是抽樣 166 份 exploit 進行分析後,發現代理程式使用了 10 項新的核心利用技術——其中兩項是新的持久性彈性物件灑射、兩項是新的頁面整理技術、五項是新的純資料利用技術、另一項涉及任意型別混淆。OpenAI 與第三方核心利用專家分享過這些技術,而專家們也從未見過。官方以「安全理由」未公開完整技術細節,這一點在留言區立刻引來反彈。
為什麼這件事重要
最直接的影響,是「一個低權限帳號等於 root」這件事的性質變了。
過去十年,資安圈有個共識:Linux 的使用者權限分離從來不是一道真正的邊界,多數共享主機早就靠「大家都不會真的互相攻擊」這個假設撐著。但那是一個成本不對稱的世界——挖一個核心提權漏洞需要資深研究員花上數週,成本高到只有國家級組織與少數商業圍標者負擔得起,攻擊者拿到手裡的數量極少。
現在這個成本結構被重寫了。1,279 美元一個的成本,等於把「找一個可用的核心提權漏洞」從專業人力密集的工藝,變成一道 API 費用。OpenAI 自己在結論裡講得很直白:「每一代模型都應該能讓我們打造出下一代模型更難攻破的軟體。」這句話在語意上是防守方的承諾,在實務上卻同時描述了攻擊方即將獲得的能力。
第二個影響,是上游修補的節奏問題。OpenAI 觀察到,掃描在 10 月中進行,人工分析在 10 天後完成時,已有 61 個 LPE 被上游修補、43 個有暫存補丁、299 個正在被公開討論。Linux 核心維護者的反應速度值得肯定——這是整件事裡最好的消息。但研究本身也指出了結構性瓶頸:他們只先修了最關鍵的一批,其餘要靠 Patch the Planet 合作方逐步送出。
第三個影響,是防守方經濟學的翻轉。當把自己的程式碼送交給前沿模型審查,變成一種「不這麼做就等著被別人打」的選項——留言區有人把這個機制稱為「俘獲的公共財」:少數幾家模型實驗室壟斷了前沿能力,多數組織只能花錢租用,而租用價格由供給方決定。
數據解讀與質疑
第一,948 這個數字有兩層解讀,別混用。 原始可用 exploit 數是 1,169,去重後的獨立漏洞與補丁數是 948。差距來自變異分析——同一根因可以被單一補丁修掉多個 exploit。管線作者在 HN 留言中特別說明,是刻意採用較小的數字以避免「補丁數 ≠ exploit 數」的困惑。引用時把 948 說成「948 份 exploit」是不精確的。
第二,74.7% 的重現率要怎麼讀。 這個數字很高,但它的前提是篩選過的:驗證階段只處理「低權限可觸及、不需特殊權限、有可量測的記憶體破壞證據」的候選。落選的剩餘項目大多是需更高權限、或因困難的競態條件而無法在時間預算內重現——不是模型判斷錯誤。真正屬於模型分析錯誤的比例只有 3.1%。所以這個數字不能推論「模型有 74.7% 的漏洞判斷正確率」。
第三,成本比較的侷限性,官方自己承認了一半。 121.3 萬美元只是 API credits,不含資安研究員的時間、測試環境建置與維護,也不含生成補丁之後上游審查的人力成本——而上游審查恰恰是瓶頸所在。用它去對比 Pwn2Own 懸賞,只說明了「以 API 費用計」的槓桿比,不代表端到端的可複製成本。
第四,實驗環境是刻意保守的,這一點對防守方有利。 目標虛擬機跑的是一般市售桌面 Linux,並且在榨取階段開啟了 SMEP、SMAP、KASLR、HARDENED_USERCOPY 等標準防護,刻意排除「靠關掉防護才能成功」的不實評估。相對地,資訊洩漏類候選平均只花 271 美元,提權類要 558 美元,約兩倍——因為後者需要額外的策略規劃、找尋可利用物件、繞過緩解措施等步驟。
第五,還有幾個數字這次沒公布。 留言區最尖銳的追問集中在資料分布:這些漏洞集中在哪些子系統(驅動程式、網路、核心)?受影響程式碼的中位數年齡是多少?漏洞型態的占比為何(記憶體破壞、邏輯錯誤、競態條件)?另一個追問是與 Linux 基金會自家 Sashiko 專案的落差——Sashiko 用 Google 的模型逐次分析每個 commit,那 OpenAI 這批裡有多少是 Sashiko 早就抓到的?這些都是評估「這套方法能否遷移到其他程式碼庫」的關鍵,目前無從得知。
第六,一個容易被忽略的發現:代理程式在測試基礎設施裡挖到漏洞。 kernelCTF 實驗中,Analyst 代理在撰寫權限轉換測試程式時撞到非預期的核心崩潰,在沒有 QEMU 原始碼的情況下自行追溯到 QEMU TCG 的漏洞,ExploitDev 代理隨後為它寫出了提權 exploit。團隊人工檢查 exploit 時才發現這個漏洞,且該漏洞在 QEMU 上游已修、只是實驗用的發布版本沒跟上。官方因此建議:在做 offensive 研究之前,先把每一段測試基礎設施本身測一遍。
接下來會怎樣
OpenAI 的下一步已經寫在文末:透過 Patch the Planet(Daybreak 計畫的一環)把這套研究延伸到更多關鍵開源專案,並與維護者合作發展可靠的自動修補流程。該計畫的公開儀表板截至 10 月底顯示 68 個程式碼庫在審查中、1,995 項議題、679 份補丁、466 份已被上游接受。
對台灣的讀者來說,有一個具體的現實對照:就在這波研究發表的同一個月,Linux 核心被曝出評分 9.8 的 TCP 遠端提權漏洞,同樣出自 AI 模型之手;台灣本地也傳出永豐金證遭外部駭客盜轉 4,176 萬元、幣安被北韓駭客得手 63 億美元的案例。金融業與企業環境裡的 Linux 伺服器,權限分離的假設同樣正在失效。
真正該被記住的,或許不是 948 這個數字,而是研究裡那句被放在結論的話:這套管線的目標,是讓找到與利用漏洞的成本,高到攻擊者不再划算。而另一句更冷靜的話來自留言區——「每個人都該假設自己用的軟體充滿了洞」。
網友熱門留言 (6)