編按:本文綜合整理自 Ricursive Intelligence 官方發布〈Introducing Ripple-65B Preview〉、Hugging Face 模型卡 ricursiveAI/Ripple-65B-Preview、MarkTechPost〈Ricursive AI Releases Ripple-65B Preview〉、eesel.ai〈Ripple-65B review: benchmarks, price, and who should run it〉、emergent.sh〈Ripple-65B Preview Hits US Open-Weight Coding SOTA〉、Alphaxiv 論文頁 2611.ripple、Reflection〈Introducing Beam〉 與 Hacker News 討論串(332 分/73 則回覆),並加入 Siami 編輯部觀點與分析。文中所有分數均引述自各廠商自行公布之數據,本文觀點不代表任何一方官方立場。
2026 年 11 月 5 日,美國一間沒什麼名气的新實驗室丟出了一顆石頭:它叫 Ricursive Intelligence,第一次公開模型,卻直接把手伸進了「美國開源權重第一」這個位置。
這顆石頭叫 Ripple-65B Preview。
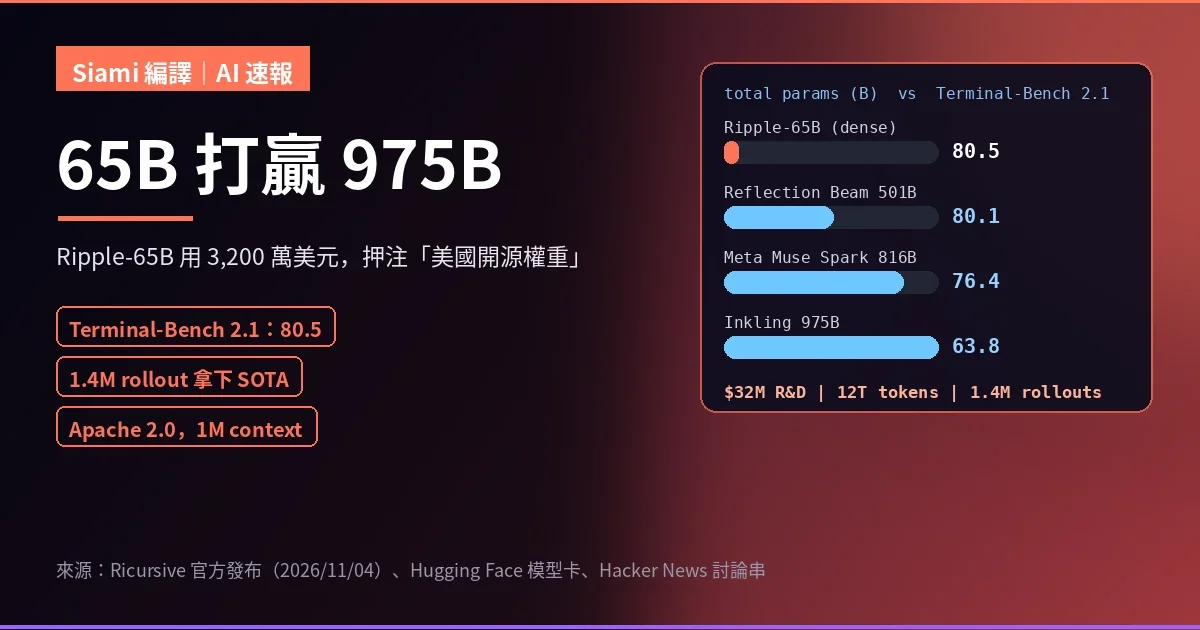
而它最反直觉的地方是——它只有 65B 參數,卻在官方比較表上贏過 501B、816B 乃至 975B 的對手。
一、它到底做了什麼:Terminal-Bench 2.1 上的 80.52
先看核心數字。Ripple-65B Preview 在 Terminal-Bench 2.1 上拿到 80.52 分,Ricursive 稱之為「美國開源權重模型的 state of the art」。
官方比較表如下(分數均為各廠自報):
| 模型 | 架構 | 總參數 | 活躍參數 | Terminal-Bench 2.1 | SWE-bench Verified |
|---|---|---|---|---|---|
| Ripple-65B Preview | Dense | 65B | 65B | 80.5 | 76.5 |
| Reflection Beam 501B | MoE | 501B | 23B | 80.1 | 80.9 |
| Meta Muse Spark Open 816B | MoE | 816B | 42B | 76.4 | 未公開 |
| Thinking Machines Inkling 975B | MoE | 975B | 41B | 63.8 | 77.6 |
| NVIDIA Nemotron 3 Ultra 550B | 混合 Mamba-2 LatentMoE | 550B | 55B | 56.4 | 70.7 |
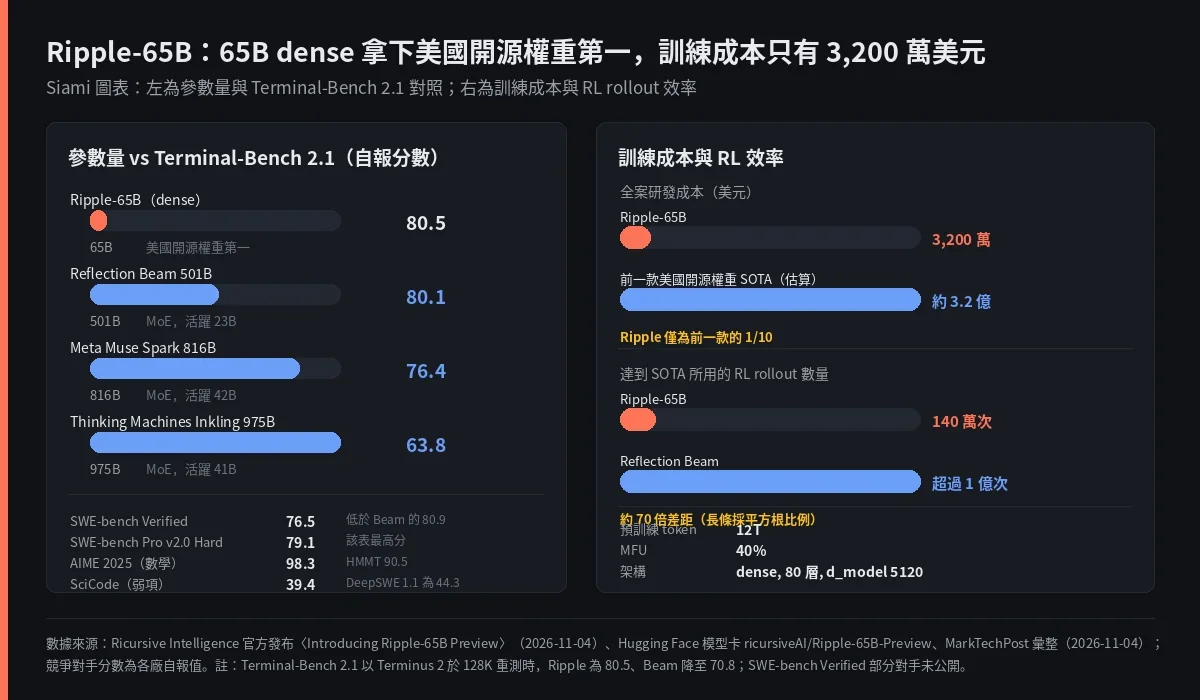
這張表最值得停下來的地方,是第一欄與第二欄的落差:Ripple 用 65B 拿到 80.5,Reflection Beam 用 501B 拿到 80.1——領先 0.4 分,參數量少了 87%。
而且比較基準線是 Terminal-Bench 2.1 這個專門考 AI agent 能不能真的在終端機裡修好 bug、跑通任務的基準,不是什麼 MMLU 題海。它衡量的是「模型能不能自己動手把事情做完」,這正是 2026 年整個業界最在乎的能力。
Ripple 官方公布的完整成績單:
- Terminal-Bench 2.1:80.5(用官方 Terminus 2 harness 在 128K 重測仍是 80.5,同時 Beam 掉到 70.8、Muse Spark Open 升到 78.7)
- SWE-bench Pro v2.0 Hard:79.1(該表最高分)
- SWE-bench Verified:76.5
- 數學:AIME 2025 拿 98.3、HMMT 2026 年 2 月場拿 90.5
而弱點也列得很坦白:SciCode 只有 39.4、DeepSWE 1.1 只有 44.3、MCP Atlas 71.67、GPQA Diamond 85.2。SWE-bench Verified 的 76.5 也低於 Beam 的 80.9 與 Inkling 的 77.6。
一個模型要有多自信,才會在自家發布頁面主動列出自己落後的項目?Ricursive 列出來了。這一點值得記在帳上。
二、3,200 萬美元與 140 萬次 rollout:這才是真正的新聞
如果說 80.5 分是一個數字,那下面這兩個數字才是這次發布真正的震撼點。
第一,3,200 萬美元。
Ricursive 宣稱 Ripple-65B 從零開始的「全案研發成本」是 3,200 萬美元——而且這個數字包含的不只是最後那一次預訓練,而是包含了預訓練階梯實驗、資料混合、評測、除錯、合成資料生成、後訓練配方開發,以及最終的主預訓練與後訓練執行。依他們的估算,這大約是前一款美國開源權重 SOTA 的十分之一。
作為對照,Sam Altman 在 2023 年說過 GPT-4 的訓練成本超過 1 億美元,Dario Amodei 隔年說前沿模型最高要 10 億美元,並預測 2026 到 2027 年光預訓練就會來到 100 億到 1,000 億美元區間。Ricursive 這次直接用 3,200 萬美元砸出一個開源權重 SOTA——落差大到有點像在講冷笑話。
第二,140 萬次 rollout。
Ripple 沒有走「暴力堆 RL」的路线。他們自己寫了合成資料管線、品質過濾與覆蓋率指標,用的是 truncated importance sampling、score centering 與 linear length penalty 這套配方。結果是:只用 140 萬次 RL rollout 就打到 Terminal-Bench 2.1 的 80.5,而 Reflection Beam 這支前 SOTA 用了超過 1 億次。大約 70 倍的差距。
而這裡有個關鍵細節,也是整篇最值得學的部分:Ripple 的模型階梯(model laddering)是从 AI2 的 Olmo 3 階梯出發,一路改到 v1.6 這個版本,所有改動加總後,在 4B 規模上把程式碼的計算效率提升了 16 倍。換句話說,同等程式碼能力,用 Olmo 3 的階梯要燒 16 倍的算力。
這不是「更大的模型」,這是「更聰明的訓練方法」。
三、為什麼要選 dense 而不是 MoE:一個反直覺的工程決定
2026 年幾乎所有前沿模型都走 MoE(混合專家)路線——因為把參數拆成多個專家、每次只喚醒一部分,是當下拉高能力又壓低推理成本的主流做法。
Ricursive 卻刻意選了 dense Transformer。官方給的理由是基礎設施複雜度:要同時訓練自己的模型、又要讓模型去訓練自己的晶片,團隊不想在推論叢集上再疊一層 MoE 的動態路由開銷。
這個選擇的結果是:
- d_model 5120、80 層的「thin and deep」比例,比同級模型更瘦更深
- 整體維持 40% MFU,而且是用簡單分片、沒有自訂 kernel、沒有量化做到的
- 額外上了 FFN activation clipping、gated attention、global NoPE、value residuals 這幾個技術
- 預訓練 12 兆 token、支援最長 1M context
- 授權是乾淨的 Apache 2.0(Muse Spark 用的是自家 Muse Model License,Nemotron 用的是 OpenMDW-1.1)
而在所有 MoE 對手動輒 501B 到 975B 總參數的同時,Ripple 是全部 65B 都在工作。
而這帶來一個很實際的後果:它小到可以塞進單機。官方 NVFP4 量化版(實驗性,MLP 層量化、注意力保持 BF16)可以直接跑在 NVIDIA DGX Spark 級裝置上;社群做的 Q4_K_M GGUF 量化檔是 38.8 GB——不過要等一個尚未合併的 llama.cpp patch 才能讓 Ollama 或 LM Studio 直接載入。BF16 原始權重約 129.6 GB,跑 2 張 B200,官方報的數字是 batch 8 情況下約 250 tok/s。
有開發者已經把它在本地機器上跑起來了:
四、Siami 質疑:「美國開源權重第一」這個標籤,是誰的遊戲?
現在來講這篇發布最尖銳的部分。因為在 Hacker News 的討論串裡,被吐槽最多的正是官方比較表本身。
網友 karmakaze 的批評相當精準:
更好笑的是,在已經挑選過比較對象之後,他們又挑了 Inkling 來做規模對照,而不是更小也更好的 Beam 1.0。那張長條圖裡放的是 Nemotron 3 Ultra,而不是更小也更好的 Nemotron 3.5 Super。
而另一則留言更直白(網友 syntaxing):
當一篇貼文連 Qwen 都不拿來比較的時候,你就知道它的表現不會有多好了。
這批評有沒有道理?有的,而且可以從另一個留言者提供的數據佐證。網友 2001zhaozhao 在討論串裡補上:
這個模型在 Terminal Bench 2.1 拿到 80.5。作為參考,Qwen 3.8 Flash Next(比這個模型大,但因為是 MoE 所以推理成本可能更低)拿到 84.3,而 Qwen 3.8-27B 拿到 73.0。
也就是說,在同樣的 Terminal-Bench 2.1 上,比 Ripple 更大的中國模型分數更高(84.3 > 80.5)。
那為什麼不放進比較表?評論區網友 advael 把這個現象整段拆開來講,語氣是全串最尖銳的一段:
把 SOTA 這個詞收窄到這種程度,已經把它稀釋得差不多了。你是指它是「你所鎖定的那一小撮基準測試」上的 state of the art 嗎?不對。那至少是「某個模型規模級距」上的 SOTA 吧?那「可用於本地推理的模型」呢?啊,原來是「美國製造的、特定規模的開源模型」上的 state of the art。喔,真棒。
這裡有三層問題需要分開看:
-
「美國開源權重第一」是個真命題,但沒什麼含金量。 這個標籤之所以成立,是因為在同一時間點,「美國」與「開源權重」這兩個限定詞把所有中國模型(無論多強)與所有閉源美國模型(無論多強)都排除在外了。剩下來的對手集合本身就不大。
-
但它解釋了一個真實且巨大的市場需求。 討論串裡網友 Onawa 說得很具體:美國政府不允許中國模型託管在任何內部基礎設施上,連本地 AI 都不行。他提到自己在 NIH 與一家 IT 營運公司工作時,都被明確告知在 DoD 硬體上部署時中國模型完全不可行(他同時坦承沒有正式文件可引,只能靠內部Directive 佐證)。
換句話說,「美國開源權重第一」這個標籤背後不是虛榮,而是一道政策牆。政府與關鍵基礎設施需要一個可以合法自架的、能力足夠的開源模型,而市面上的強開源模型幾乎都來自中國。Ripple 精準地填上了這個位置。
-
挑選比較對象這件事本身,不必然是壞事。 網友 stewartpark 的解讀其實相當成熟:主要用戶(美國政府機構、晶片設計業)本來就不會把「那些其他開源權重模型」當成選項,所以這張圖對真正會考慮這個模型的人來說是正確的。問題在於用一個經過四層限定的標籤當標題,而不是把限定條件講清楚。
至於那筆 3,200 萬美元的訓練成本,則有另一個更實際的視角——網友 wmf 說:「也許 Palantir 會用它之類的吧。美國模型確實有市場,但我不知道那個市場有多大。」這是誠實的:技術指標漂亮,跟能不能變成生意,是兩件事。
五、還有哪些坑要留意:context window 的落差
有一個技術細節,值得單獨拉出來講,因為它在實際接進 agent 時會直接卡住你。
官方宣稱 Ripple-65B 支援最長 1M context,模型卡上的伺服器 README 也確實把 1M 設為預設值。但當天實際走 API 的路徑,context 只有 16,384 tokens。
OpenRouter 上 Ripple-65B Preview 的報價是每百萬 token 輸入 0.20 美元、輸出 0.60 美元,cached read 每百萬 2.60 美元——對照同業:Qwen3.8 27B 是 0.15 / 1.875、DeepSeek V4.1 Flash 是 0.045 / 0.50、Inkling 是 1.00 / 4.05、Muse Spark Open 是 1.25 / 4.25。Ripple 的輸入價格跟 Qwen 同級,但輸出價格只有 Qwen 的三分之一。
但 eesel.ai 的實測評論還留了兩句更關鍵的話:作者當天記錄到的 OpenRouter 頁面只有單一供應商、可用率 53.69%、吞吐 73 tokens per second——對一個專為 agentic coding 而生的模型來說,這個配置「對它要解決的問題來說太短視了」,而且「對第二天上線的模型來說算正常,但不該放進正式環境」。另外 Together AI 的頁面當天仍標示為「coming soon」。
還有兩個小陷阱值得記:聊天模板沒有實作 thinking on/off 開關,也沒有 reasoning effort 等級控制;NVFP4 的本地腳本是一次只跑一個請求、context 設在 128K。
所以正確的讀法是:Ripple 的「1M context」是模型能力,不是今天就能在 API 上買到的服務。若你只是想跑 API,Beam 的 1M context 更省事;Ripple 的價值在於權重歸你、可以自架。
六、為什麼這件事重要:開源權重的遊戲規則正在被改寫
把上面所有東西拉開來看,這次發布真正有意思的地方有三個。
第一,效率戰爭已經取代了規模戰爭。
過去兩年,開源模型與閉源模型之間的差距靠堆算力硬追。DeepSeek 那一波把「低成本訓練」打成了行業信仰,但大家心底仍舊相信「最強模型就是超大模型」。Ripple 這次的訊號是:**65B 打贏 975B,不是奇蹟,是把階梯設計、資料混合與 RL 配方設計到極致的結果。**一旦 16 倍的計算效率提升被複現,那些沒有數百億美元預算的實驗室,第一次有了正面競爭的入場券。
第二,這是一場由政策驅動的技術競爭。
「美國開源權重第一」聽起來像行銷話術,但對照討論串裡關於 NIH、DoD 硬體的實際限制,它其實回答了一個非常具體的採購問題。當聯邦機構不能部署中國模型、又不想被閉源 API 綁住,能自己託管、權力最高、授權最乾淨(Apache 2.0)的美國模型,就有了不等於效能第一的商業價值。這是理解這家公司為什麼從第一天就把「美國」兩個字寫進標題的關鍵。
第三,模型與晶片一起設計,這是下一個戰場。
Ricursive 的自我定位是「用 AI 做晶片設計、用晶片設計 AI」的全棧實驗室,而 Ripple 是這條路線的第一個公開產品——內部變體正在支撐他們的 AI 晶片設計平台。討論串裡網友 xyzrt 點出了這件事的對稱性:「一個是靠 AI 與 AI 晶片協同設計來達成自我改進的 AI,另一個是只靠軟體達成自我改進的 AI。」
如果這條路真的走通,那「模型能力」這個指標本身會被重新定義:不是模型有多強,而是模型能多快地把更好的晶片造出來、再回頭餵養自己。這是一個比 Terminal-Bench 分數重要得多的遊戲。
七、Siami 觀點:這次發布最該被記下的一句話
如果要為這篇文章留一句結論,我會挑這一段。
Ripple-65B 最讓人興奮的不是 80.5 這個分數,而是它把「訓練成本」從一個玄學變成了一個可以攤開來談的工程數字:3,200 萬美元、140 萬次 rollout、16 倍階梯效率改善。這些數字是可以被質疑、可以被複現、也可以被別人超越的——而這正是它比「某某模型有 900 億參數」這種行銷話術有意義得多的地方。
但同樣地,它最讓人擔憂的也不是分數,而是標籤的偷換。
一個模型的真實水平,是一個客觀事實;但「美國開源權重第一」是一個經過四層限定的敘述。這種標題在行銷上很有效,在技術溝通上卻是有害的——它讓讀者以為自己看到的是絕對第一,實際上看到的是一個被精心框選過的視角。
Siami 的原則是:數字要攤開,標籤要看清楚。
所以這篇文章的結論不是「Ripple-65B 是最強的開源模型」。它不是——至少在 Terminal-Bench 上,Qwen 3.8 Flash Next 的 84.3 就擋在那裡;而在 SWE-bench Verified 上,Ripple 的 76.5 輸給 Beam 的 80.9;SciCode、DeepSWE 1.1、MCP Atlas 也都是明顯的軟肋。
這篇文章的結論是:Ripple-65B 是 2026 年 11 月最值得認真讀的一份技術發布,因為它第一次把「用 1/10 的錢做到同級別」這件事擺到了台面上,而且擺的時候附帶了足夠多的細節讓你可以自己去驗。
這比一個 SOTA 標籤值錢得多。
八、接下來看什麼:三個可以驗證的觀察點
- 第三方獨立重測。 目前的分數全是自報。Terminal-Bench 2.1 在官方 Terminus 2 harness、128K 設定下重測的結果,是判斷 80.5 真實性的第一道關卡——Ricursive 自己就公布過重測後競爭對手會掉分(Beam 掉到 70.8)。第三方在同樣條件下的結果會更有參考價值。
- API 的成熟速度。 16,384 的 context 限制、53.69% 的可用率、73 tok/s 的吞吐,以及 Together AI 的「coming soon」,都會隨時間收斂。這是判斷「美國開源權重第一」能走多遠的關鍵變數——政策需求存在,但採購還是要看服務品質。
- Apache 2.0 + 可自架 + 1M context 的組合有多快被企業採購。 如果政府與關鍵基礎設施真的把它列為替代方案,那它的商業價值就不在排行榜,而在採購名單上。
延伸閱讀與延伸來源
- Ricursive Intelligence 官方發布〈Introducing Ripple-65B Preview〉 — 原始出處
- Hugging Face 模型卡 ricursiveAI/Ripple-65B-Preview — 權重、評測細節與推理設定
- MarkTechPost〈Ricursive AI Releases Ripple-65B Preview〉 — 第三方彙整的完整比較表
- eesel.ai〈Ripple-65B review: benchmarks, price, and who should run it〉 — API 報價與實測陷阱
- emergent.sh〈Ripple-65B Preview Hits US Open-Weight Coding SOTA〉
- Alphaxiv 論文頁 2611.ripple
- Reflection〈Introducing Beam〉 — 前 SOTA 的原始發布
- Hacker News 討論串(332 分/73 則回覆)
網友熱門留言 (6)