編按:本文綜合整理自 Anthropic Research〈The components of agent memory〉、arXiv〈Sleep-time Compute: Beyond Inference Scaling at Test-time〉、Anthropic 官方 cookbook〈Dreaming with a dynamic workflow〉、anthropics/claude-quickstarts〈managed-agents/knowledge-wiki〉、harveyai/harvey-labs、Karpathy 的 wiki 範例、The New Stack〈Anthropic gave agents the ability to dream. Then developers woke up.〉 與 Hacker News 討論串(48 分/23 則回覆),並加入 Siami 編輯部觀點與分析。文中所有實驗數字均引自 Anthropic 官方文章與其公開基準測試,非媒體推估;文中觀點不代表任何一方官方立場。
2026 年 11 月 7 日,Anthropic 研究團隊在官方研究部落格公開〈The components of agent memory〉,把 Claude 的記憶系統從黑箱拆成三個可攤開來看的元件。這篇文章的份量不在於又宣稱了什麼新能力,而在於它第一次把「Agent 到底記了什麼、什麼時候忘、怎麼自我糾錯」變成一份可以複算的工程說明——而且附帶了一組相當難看、卻很有價數字的實驗結果。
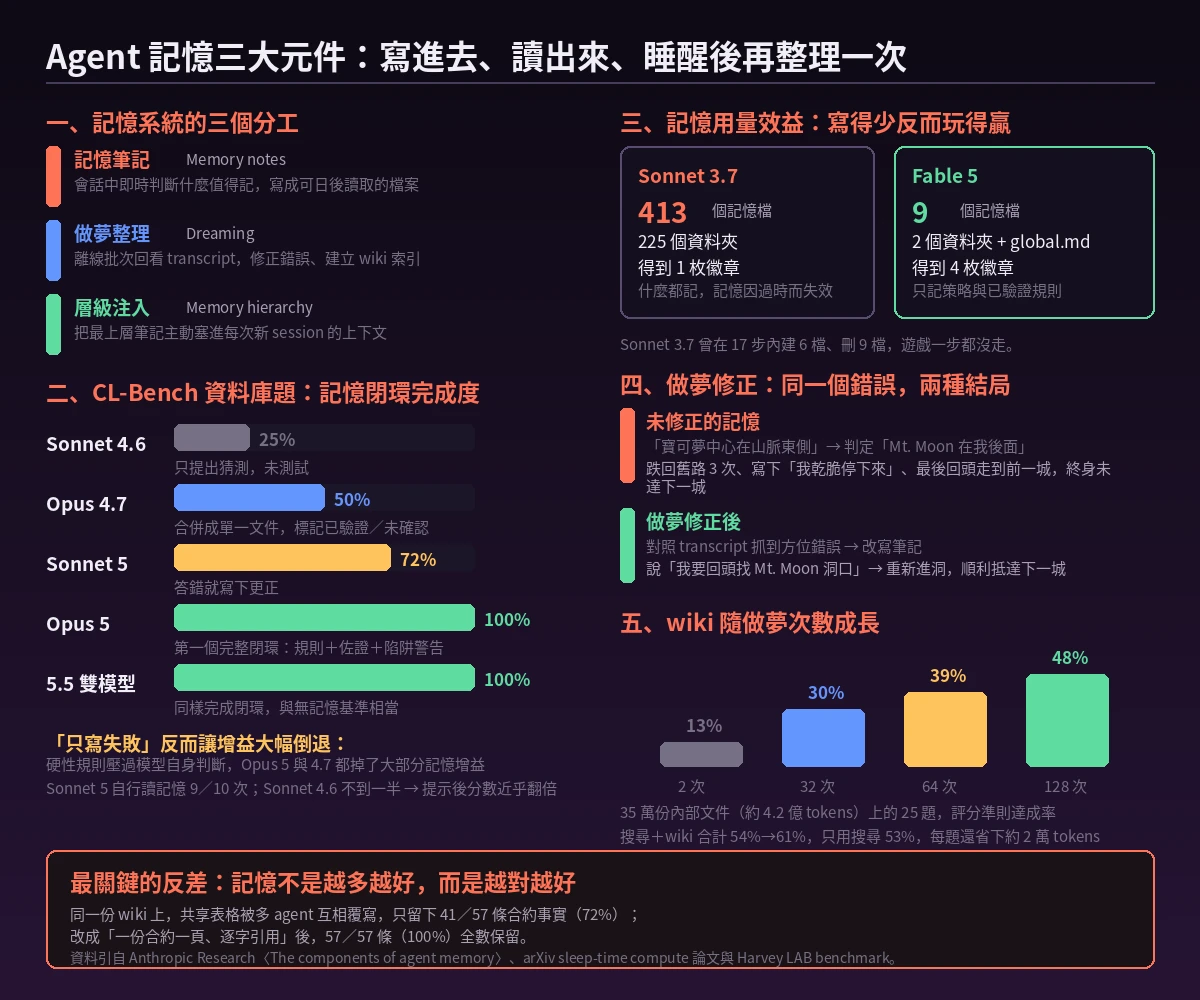
先講結論:記憶多寡跟記憶好不好,是兩件事。同一場寶可夢實驗裡,寫了 413 個記憶檔的模型只拿到 1 枚徽章,寫了 9 個的模型拿到 4 枚。Anthropic 官方的說法是——記憶不是越多越好,而是越對越好。
- Lessons on AI agents from Claude Plays Pokemon(David Hershey)|本文引用的寶可夢實驗原始開發者談記憶系統設計
一、記憶的三層結構:寫進去、讀出來、睡醒後再整理一次
Anthropic 對「Agent 記憶」給了一個相當嚴格的定義:指的是 Claude 從經驗中取得的知識——包含與使用者互動、以及被交付的任務——並且在跨 session 之間保留下来,以後還讀得到的上下文。它明確排除了三樣東西:訓練期間調整模型權重所改變的「學到的东西」、單次對話內的 in-context learning,以及把舊對話摘要化來騰出 context window 的 compaction。
在這個定義之下,整套系統拆成三個元件:
- 記憶筆記(Memory notes) — 會話進行中,Claude 當場判斷什麼事件「顯著」,把它寫進一個記憶目錄(實作上就是一個資料夾裡的一堆 markdown 檔)。類比人類的記憶重放(replay),顯著事件會被標記、在離線時段被更頻繁地重播。
- 做夢(Dreaming) — 一個非同步、批次執行的離線程序,讓模型在兩次互動之間的空檔,運用閒置算力回看自己的 transcript,重組既有的記憶脈絡。這條思路的學術源頭是 Letta 與 UC Berkeley 提出的 sleep-time compute(arXiv 2504.13171):讓模型在查詢還沒來之前就先想。
- 記憶階層(Memory hierarchy) — 做夢可以把某些筆記「浮」到階層最頂端,由 agent harness 在每次新 session 開始時主動注入上下文。Claude Code 的 auto memory 就是同一套思路的縮小版:它不會把所有記憶都塞進每個 session,只載入 MEMORY.md 的前 200 行或 25 KB 當作索引,其餘的層按需讀取或搜尋。
這裡有個容易被忽略、但決定了整個系統成敗的設計選擇:記憶是純檔案,不是向量資料庫。開發者可以直接 cat 出來看、diff 出來審、code review 掉。Anthropic 內部工程師 Lamis Mukta 在 AI DevCon 倫敦場的說法是,agent 的「context 常常與模型本身的智能是正交的」——模型再強,也不會自動知道你這個組織要怎麼做事。
二、CL-Bench 實驗:從「寫下猜測」到「完整閉環」
Anthropic 用 CL-Bench 1.0(Continual Learning Benchmark)裡的一個資料庫題追蹤記憶能力:模型要查資料庫回答一連串問題,每答完一題就會被告知正確答案,並且可以為未來的題目寫一條記憶。每一題都是全新 session,唯一能延續的是那個記憶目錄。
結果是一條非常清楚的階梯:
- Claude Sonnet 4.6(25%) — 只做到「提出假設」。它的記憶目錄裡散落著一堆檔案,每個都列著幾個未經驗證的猜測。它想過為什麼答錯,但沒有去測試那些猜測。
- Claude Opus 4.7(50%) — 開始收斂。把筆記整合成單一參考文件,並標記哪些事實已檢查、哪些仍未確認。
- Claude Sonnet 5(72%) — 答錯時會寫下更正,等評分者確認答案後,把條目標記為 confirmed。
- Claude Opus 5(100%) — 第一個完整走完閉環。大部分條目包含一條規則、它是怎麼知道這條規則成立的、對先前題目的答案,以及它沿途發現的陷阱的明確警告。
- Claude Opus 5.5 與 Sonnet 5.5(100%) — 同樣完成閉環。有記憶時與 Opus 5 相當,但值得注意的是,它們「不用記憶時」的基準分數反而略高。
最後這行是整篇文章最耐人尋味的地方之一:記憶帶來的增益會隨模型本身變強而邊際遞減。Claude Sonnet 5 沒有任何提示,就會在 9 次裡有 9 次先讀記憶再作答;Sonnet 4.6 這個比例不到一半。當研究團隊直接提示 Sonnet 4.6「先讀記憶檔、並明確測試你的假設」,它的基準分數幾乎翻倍。
三、最反直覺的數據:記憶寫得多,遊戲反而玩輸
Anthropic 用 Claude 玩寶可夢紅色版來測「模型知不知道什麼值得記」。在遊戲進行到約 10,000 步時,兩份記憶目錄被拿出來對照:
- Claude Sonnet 3.7 — 寫了 413 個記憶檔、分散在 225 個資料夾,換到 1 枚徽章。
- Claude Fable 5 — 只寫了 9 個檔案、2 個資料夾加上一個頂層的 global.md,換到 4 枚徽章。
差異不是隨機的。Sonnet 3.7 假設「什麼都可能重要」,所以無差別地寫:每一場戰鬥、每一件道具、每一個 NPC 都各自開一個檔。而遊戲狀態是不斷變化的,所以那份詳細記錄很快就過時——到了約第 10,000 步,它開始建立第四個「master」記憶資料夾,接下來 17 步裡建立了 6 個檔案、刪掉 9 個,在遊戲裡一個動作都沒做。它把算力全花在整理自己過時的筆記上了。
Fable 5 的做法相反:只記遊戲不會直接告訴你的東西。像是「玩家有多少錢」「現在地圖上哪裡」這種每回合都能從畫面讀到的資訊,存下來純屬冗餘;真正有價值的是策略、計畫與測試過的規則——那些東西除非自己推導並寫下來,否則不會存在。它的 global.md 是一個儀表板:目前目標、打 gyms 的預寫計畫、以及自己使用記憶的規則。像「連續 3 顆以上精靈球失敗就改變時機(選單步驟間多插幾次等待),改成時機後就抓到了」這種經過驗證的規則,才是值得留下來的東西。Opus 5.5 用的是同一套思路:一份小小的筆記追蹤目前目標與下一步,邊玩邊改寫,最後通關。
更關鍵的是,Sonnet 3.7 的記憶在 17 步內瘋狂增刪檔案,而 Fable 5 幾乎不動——省下來的注意力就是繼續玩下去的空間。
四、做夢能改掉錯誤,但不能保證改對
做夢最有說服力的案例來自同一場寶可夢實驗。Mt. Moon 洞穴的入口在西側、出口在東側,入口附近有一個單向落差,掉下去就會回到原路。Claude 把山腳下的寶可夢中心當成地標,因此它是否會走錯方向,取決於它記得寶可夢中心在哪一側。
某個時刻,Claude 錯誤地記下「寶可夢中心在東側」。它走出建築時宣布「Mt. Moon 在我後面」,並把筆記更新為「Mt Moon DONE」——但其實並沒有。幾步之後它走過落差、落回原路,而它的導航工具沒有顯示那個落差,所以 Claude 得出結論:「我大概是往西走過頭了。」它沒有錯。它只是從一個錯誤的筆記出發。
接下來團隊對這份記憶目錄跑了做夢。Claude 拿筆記去對照原始 transcript,抓到方位錯誤,改寫了筆記。結果是兩種結局的分野:筆記沒修正時,它說「Mt. Moon 在我後面」、往下一座城走、落回原路三次,第三次失敗後寫下「我乾脆停下來,不要再繞圈了」——setup 的自動回覆要求它繼續,於是它一路走回前一座城 Pewter City 想補血補給,最後整場都沒走到 Cerulean City。筆記被做夢修正後,它說「我得回頭找 Mt. Moon 的洞口重新進去」,然後成功回到洞穴,最後抵達下一座城。
做夢不只是修錯。它還能建構新的記憶表徵:一種叫 wiki 的形式——由 Claude 自己撰寫與維護的頁面集合,把同一主題的知識集中起來並互相連結,這些連結等同於一張地圖,讓模型能在日益龐大的記憶庫裡有效率的定位。做夢也能補上 session 留下的缺口:有一次做夢在 wiki 中發現九個指向「尚不存在頁面」的連結,把它們改指到同一份文件既有的頁面,另外新增三個頁面(含一個索引)。
五、wiki 會長大,但長太大就變成垃圾場
Anthropic 拿內部文件做了一次大規模實測:來自他們 5 月收購的 Stainless,約 35 萬份檔案、約 4.2 億 tokens。他們挑了 25 題,給 Claude 搜尋工具,同時要求它用做夢來建立 wiki。128 個 session 之後,Opus 5 agent 探索檔案、撰寫或修正互相連結的 wiki 頁面、合併重複頁面、並把主張回頭對照來源查核。
從 2 次做夢拉到 128 次,25 題的評分準則達成率從 13% 成長到 48%。而且 wiki 跟搜尋工具是互補的:只給搜尋工具是 53%,只給 wiki 是 48%,兩者併用則從 54% 爬升到 61%,每題還省下約 2 萬 tokens。
但同一篇研究也誠實地寫了 wiki 會失敗的兩種情況。在某個 LAB benchmark 任務上,評分準則大多可以直接從單一文件用文字搜尋取得,wiki 相對搜尋沒有明顯增益;在另一個任務上,wiki 長得比原始文件本身還大——Anthropic 引用波赫士(Borges)那篇〈On Exactitude in Science〉裡的製圖師做了一張跟帝國一樣大的地圖,「Claude 做了一份極度詳細、實際上等於什麼都沒抽象掉的 wiki」。
為什麼這件事重要
Agent 記憶從「要不要加個向量資料庫」的技術選項題,變成了一個制度問題。這篇文章真正的價值不在任何單一數字,而在於它把記憶系統放進了「狀態管理」(state management)的框架裡:記憶有版本、有層級、有回寫路徑、有生命週期。這對正在自建 agent 的團隊有一個非常具體的實務後果——記憶系統的設計目標不該是「存得下」,而該是「能被人讀、被人審、被人回滾」。
三個數字最值得記:第一,Sonnet 3.7 的 413 個檔案對上 Fable 5 的 9 個檔案,說明記憶系統的瓶頸不在容量而在判斷力;第二,Opus 5 是第一個自己走完閉環的模型,但它的 5.5 世代「不用記憶時分數反而略高」,說明記憶機制的紅利會隨模型能力遞減——如果你的模型已經很強,投資記憶系統的邊際效益要重新算;第三,說明指派記憶規則是反效果的,正確做法是給模型判斷權限——模型越強,越該自己決定怎麼記。
對台灣的中小企業與工作室來說,這更直接。導入 AI agent 的門檻從「要有向量資料庫工程能力」降到「要有檔案管理紀律」——一個能被 cat 出來審的 MEMORY.md,遠比一個不能被稽核的向量庫好管理。
數據解讀與質疑
數據這邊有三處必須打的折扣。第一,寶可夢對照只跑了「每一種模型各一次」(one run each),10,000 步的遊戲本來就有極大的隨機性,413 對 9 這個對比再怎麼驚人,統計上仍屬單次觀測。第二,CL-Bench 資料庫題的絕對分數沒有在文中公開,圖表裡的 25%/50%/72%/100% 是各模型「記憶閉環完成度」的相對刻度,不是可跨模型比較的絕對準確率——引用時不該把它說成「Opus 5 拿到 100 分」。第三,做夢的全部成本(token 消耗、算力排程、每輪跑多久)在文章中沒有列出,只說了「這需要算力」。
質疑的部分來自業界。The New Stack 訪問的三位工程師,結論相當一致但比官方文章樂觀。獨立研究者 Jayakumar Ramalingam 認為做夢「有用,但也製造了一條危險的升級路徑」:壞掉的答案會隨 session 一起死亡,壞掉的記憶卻可能影響未來幾千個 session,「人力審核聽起來令人安心,但在機隊規模下很容易變成沒人有力氣重建的橡皮圖章」。他主張每一條記憶都必須帶著來源、證據與到期條件,否則做夢只會讓 agent 記得更多,卻讓組織忘記自己當初為什麼相信那條記憶。
企業 AI 架構師 Vladimir Beskorovainyi 的批評更銳利:他認為做夢是「方向對但瞄錯目標」——被修正的失敗(單位寫錯、工具設定壞掉、破折號用太多)全都在 transcript 表面看得到,真正會付出代價的失敗是「agent 選了錯的工具,而當時的理由看起來完全合理」。而記憶庫會漂向「agent 隊伍最近恰好在做的事」,讓「最近」這個因子安靜地變成真理。他倒是給了 Anthropic 一個很高的評價:「產業花了兩年堅持記憶等於向量資料庫,而 Anthropic 用檔案系統加 grep 解決了,這是整場討論裡最有趣的決定。」
滲透測試公司 Penetrify 創辦人 Viktor Bulanek 則點出做夢最讓他不安的地方:它把自動寫入者指向 session transcript,而「transcript 裡滿是 agent 沒有自己撰寫的內容」。他主張「回滾不是合規功能」,而是工程師三週後發現記憶被污染時的那顆 undo 鍵——而且這套架構裡沒有任何東西會宣告某條已儲存的事實「從現在起不再成立」。
Hacker News 的反應則從另一個角度切入。網友 yfontana 說他在每個 harness 都關掉了自動記憶建立,「Claude Code 還是會自己建立一些,而我大概會刪掉 95%」,因為那些記憶幾乎永遠只跟當下任務有關;他最想要的其實就是文章證明了的那件事——更好的判斷力。有網友 prtmnth 直接寫了一個 memory-prune skill,專門接手自動生成的記憶、評估它該活著還是被刪掉。另一條線則质疑「做夢」這個詞本身:主流假說之一是,做夢其實是記憶處理與鞏固的副產品,用副產物的名字去描述產生它的過程本身就有誤導性。
綜合來看,這篇文章最誠實的一點,是它自己就寫明了 wiki 會長得比原始文件還大、會在某些任務上完全沒有增益——這在自家官方部落格裡算是少見的坦率。
Siami 觀點
官方那份文章最容易被誤讀的地方,是標題裡的「做夢」聽起來像意識或某種神秘機制,但它在工程上就是兩件事:非同步批次重整記憶+把整理後的結果結構化成可索引的層級。把它想成「定期幫模型做一次檔案系統 garbage collection,把過期筆記修正、把散落筆記合併成 wiki、把最上層索引自動更新」,會比想成「模型睡著了所以變聰明」精準得多,也才能判斷它值不值得投資。
真正值得帶走的操作準則只有一條:不要寫規則去規定模型該記什麼。Anthropic 自己用實驗證明了這件事——「只記失敗」的硬規則讓 Opus 5 和 Opus 4.7 都丟掉大部分記憶增益;同一篇研究也證明了「規則只寫得更細、記憶反而更差」。正確姿勢是給模型一個記憶目錄、告訴它這個目錄可以用,然後讓它自己判斷顯著性,並且定期讓它對照原始紀錄自我稽核。實務原則很簡單:規則寫得越死,模型越容易照著死規則跑,記憶反而變成噪音。
第二個值得帶走的判準是記錄密度。Sonnet 3.7 一天寫 413 個檔案,最後 17 步完全沒推進任務——記憶寫到後來會反過來吃掉模型對主線任務的注意力,這跟人類的筆記成癮是同一個結構。Fable 5 的 9 個檔案贏在它把「每回合都能從螢幕讀到的資訊」全部排除,只留下無法重建的推論。這個判準可以直接翻譯成給團隊的規則:記憶只記「推導出來的結論」與「驗證過的規則」,不記「觀察到的事實」。
第三,官方文章提到的兩個細節,是最容易被忽略、但最決定成敗的:MEMORY.md 只載入前 200 行或 25 KB 當索引,以及記憶必須能被人讀、被人審、被人回滾。前者說明記憶系統的瓶頸永遠在「最上層索引有多大」,後者說明純檔案系統贏過向量庫不是因為效果,而是因為可稽核。在企業環境裡,一條不可稽核的記憶等於一份沒人負責的設定檔——這是 The New Stack 那些受訪工程師一致同意、而 Anthropic 官方文章沒有正面回答的問題。
本文涉及的完整數字、各模型能力階梯與 wiki 成長曲線,請見文內 Siami 圖表。
延伸資源
- Anthropic Research〈The components of agent memory〉|本文主要來源
- arXiv〈Sleep-time Compute: Beyond Inference Scaling at Test-time〉|做夢的學術源頭
- Anthropic cookbook〈Dreaming with a dynamic workflow〉|官方可執行範例
- anthropics/claude-quickstarts〈managed-agents/knowledge-wiki〉|wiki 實作程式碼
- harveyai/harvey-labs|LAB 法務簡報基準測試
- The New Stack〈Anthropic gave agents the ability to dream. Then developers woke up.〉|三位工程師的質疑
- Hacker News 討論串(48 分/23 則回覆)|開發者社群實戰反應
網友熱門留言 (12)