編按:本文綜合整理自 METR〈Independent Assessment of AI R&D Acceleration at Anthropic in October 2026〉、METR〈Review of the “Risks from automated R&D” section in Anthropic’s Risk Report (August 2026)〉、Anthropic Institute〈Measurements for understanding the pace of AI development inside frontier labs〉、Anthropic S-1 更新、METR 官方 X 貼文、Ryan Greenblatt(METR)推文、Ajeya Cotra〈AI is dramatically accelerating AI research right now〉、The Verge 報導、Resultsense 分析、AI 2027 情境報告 與 Hacker News 討論串(327 分/288 則回覆),並加入 Siami 編輯部觀點與分析。文中所有加速倍率、信賴區間與內部量測數字均引自 METR 與 Anthropic 官方文件,非媒體推估;文中觀點不代表任何一方官方立場。
2026 年 11 月 5 日,獨立評估機構 METR(Model Evaluation & Threat Research)公開一份調查報告。4 名研究員、2.5 名全職人力,從 2026 年 8 月 12 日住進 Anthropic 內部到 10 月 29 日,總計約 11 週,執行了史上少見的高權限評估。他們查看了預訓練與強化學習的內部指標、各領域的訓練算力、內部模型的基準分數、AI 加速分析、對未來模型的指標預測,並訪談相關員工。
結論只有一句話,但份量極重:
截至 2026 年 10 月,Anthropic 在明確指定任務上的模型能力提升速度,大約是 2024 年 3 月至 2025 年 10 月期間的兩倍。
這不是某位高管的乐观宣稱,也不是模型廠商的行銷稿,而是一份第三方評估機構用員工級權限、看了三個多月內部資料後得出的結論。而 METR 自己給出的信心範圍,寬到有點罕見——他們說,如果真實值是 1.3 倍或 3 倍,也不會感到意外。
- Independent Assessment of AI R&D Acceleration at Anthropic in October 2026(METR 報告逐節解說)|第三方科技頻道 AskwhoCasts AI 對 METR 報告的逐節帶讀,含執行摘要、關鍵發現與風險評估三大部分
一、1.9 倍是怎麼量出來的:AECI 這把尺子
所謂「能力在加速」,聽起來很玄,但 METR 用的量測工具其實相當具體:Anthropic 內部版本的 Epoch Capabilities Index,簡稱 AECI。這個指數把一系列可驗證的基準測試分數彙整成一條能力趨勢線,概念上等同於 Epoch AI 對整個業界模型能力走向的追蹤。
用這把尺子量出來的結果是:
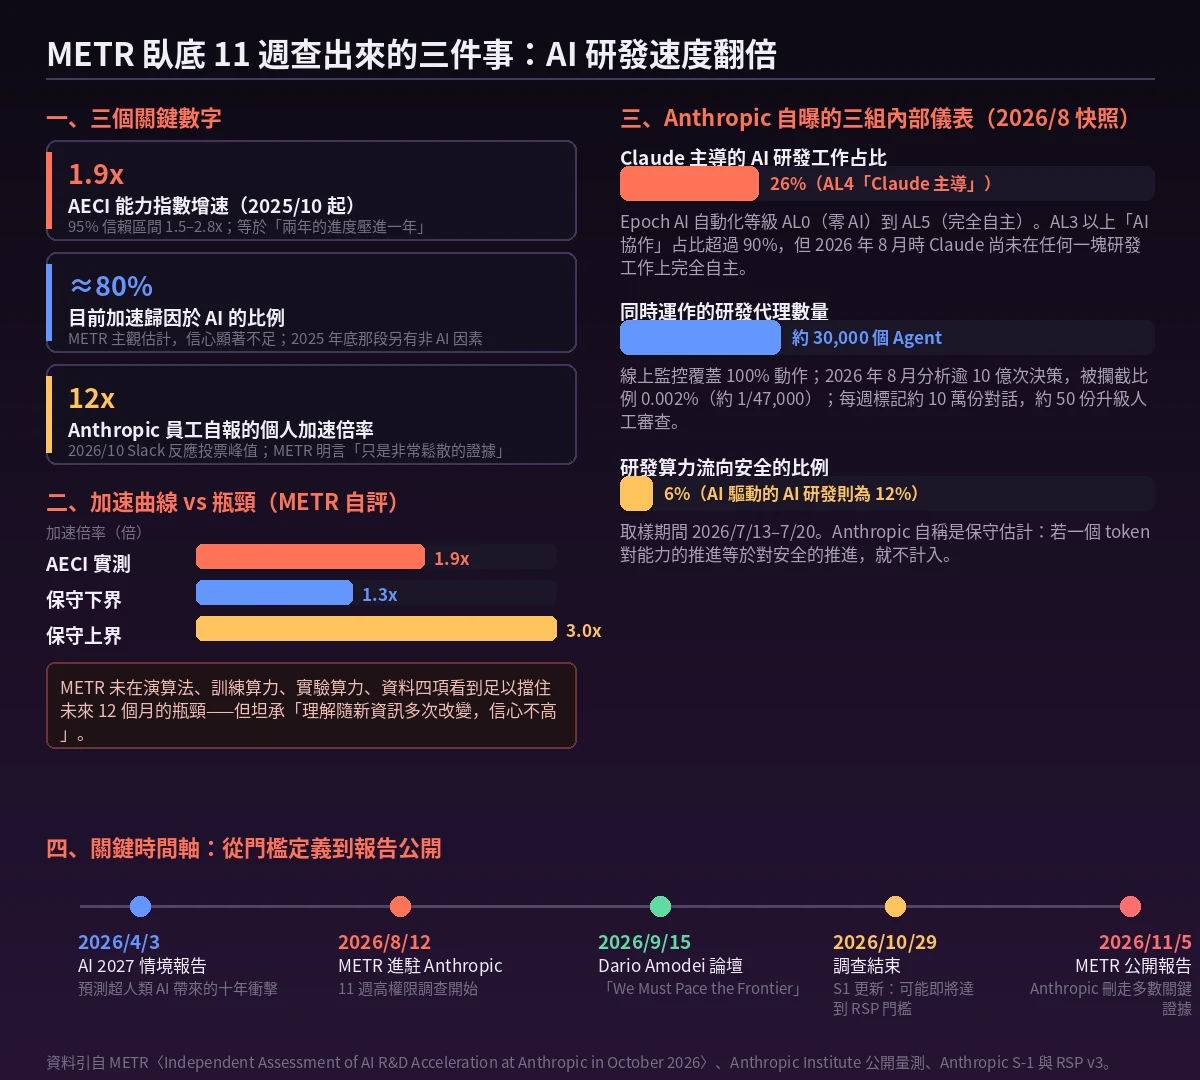
- 2025 年 10 月以來,AECI 分數增速為 1.9 倍(95% 信賴區間 1.5–2.8 倍)
- 換句話說,Anthropic 在過去一年累積的進度,相當於過去兩年(約 2023 年 10 月到 2025 年 10 月,大致是 Claude 2.1 到 Sonnet 4.5 的距離)
- 這個估計值高於 Haiku 5.5 系統卡自報的 1.7 倍,主要差異是因為 METR 的計算納入了尚未發布的內部模型資料
- 穩健性檢驗的結果落在 1.1 倍到 2.9 倍之間;METR 說,若真實的加速幅度完全沒有,或超過 3 倍,他們才會感到意外
這裡有個容易被忽略的細節,也是整份報告最誠實的一段。METR 特別指出:如果改用「全業界前沿模型」而非 Anthropic 自身模型來算,得到的加速倍數只有約 1.4 倍。他們列出兩種相反的解讀,並明說無法判定哪一種才對:
- Anthropic 的模型在 2025 年之前是次前沿(subfrontier),所以它自己的歷史增速被低估了——那麼 1.9 倍是高估,1.4 倍比較接近真相。
- Anthropic 的模型相較其他模型比較不為基準測試最佳化,代表歷史趨勢中的早期資料過度擬合基準測試——那麼 1.4 倍是低估,1.9 倍才更接近真相。
換句話說,1.9 這個數字的真實位置,取決於一個至今沒人能回答的技術問題。
二、把加速歸因給 AI:80% 這個數字怎麼來的
METR 排除了多個可能的替代解釋,包括訓練算力規模的加速、招募人數、資料改善、演算法發現,以及其他瓶頸的解除。最終他們能有把握排除的只有一項:
「我們有令人信服的證據顯示,這次加速並非來自訓練算力規模增速的加快。」
剩下的部分,METR 用的是主觀判斷:
- 2025 年底的那段加速,很可能受到非 AI 因素的影響(具體細節被刪除)
- 當前(2026 年 10 月)的加速,約 80% 來自 AI 自身——METR 明說這個判斷「具有顯著的不確定性」
支撐這個判斷的有三條公開證據來源。
第一,深度訪談。 METR 與 Anthropic 雙方都對許多研究員做了詳細訪談,詢問 AI 在其工作領域帶來的加速程度。整體印象是估計值分布很寬,但中心值落在 2 倍加速附近。
第二,員工自報。 Anthropic 提供的是一系列 Slack 投票,員工用表情回應投票表達「最新模型帶給我的加速倍率」。METR 對這份證據的評價非常保留——「我們認為這只是非常鬆散的證據,因為回應反映的是低投入程度的考量」——但他們仍觀察到一致的成長趨勢,以及「極高的水準(2026 年 10 月達到 12 倍)」。
這裡必須補一句 METR 自己寫在報告裡的免責說明,因為它經常被媒體跳過:
「個別的 uplift/speedup 估計值並不等同於加速率。」
用白話說:「我覺得 Claude 幫我快了 12 倍」跟「整體研發速度加快了 12 倍」是兩回事。要維持某一個產出增速,通常需要輸入端(人力或勞動生產力)有相近的加速才能抵銷邊際收益遞減。所以 METR 真正在意的是個別 uplift 的成長率變化,而不是它的絕對值。
第三,自主貢獻的跡象。 METR 得知 AI 目前還無法對模型訓練流程中最重要的部分做出高度自主的貢獻,「AI 主要以輔助而非完全自主的方式加速研發」。但研究員描述了一些「生命跡象」(signs of life),暗示這類貢獻很快就會出現,且不同領域的成熟度差異很大。
三、沒有瓶頸:報告裡最樂觀也最讓人不安的一段
METR 明確表示,他們沒有看到任何足以阻止未來 12 個月進一步能力進展的顯著瓶頸——在演算法進展、訓練算力、實驗算力與資料這四個方向上都是如此。
但他們緊接著補上一句讓這段話可信度大打折扣的話:
「然而,我們對不同瓶頸狀態的理解,在獲得更詳細資訊的過程中改變了好幾次,因此我們對目前的評估並不有信心。」
METR 同時表示,Anthropic 刪除了他們對若干具體瓶頸的分析。
而這正是整份報告的核心張力所在。METR 自己的原始文件寫得明白:
「我們並未發現任何明確的瓶頸(限制進一步成長的有限輸入),也未發現會阻礙這種複利式加速的陡峭邊際收益遞減……因為我們認為,能力進一步進展有相當大的風險,會在未來一年帶來更快的加速。」
他們也提到,看到了一些「令人困惑的、已被刪除的證據」,顯示加速可能已經超過 2 倍,而且還在持續上升。
四、Anthropic 自己公佈的三組內部儀表
就在 METR 報告公開的同一時間,Anthropic 的 Institute 也發布了一篇量測文章,公開了公司內部的三組數據。這兩份文件放在一起看,才拼得出完整圖景。
第一組:Claude 到底做了多少 AI 研發?
Anthropic 建了一個「AI 研發自動化指數」,用 Epoch AI 開發的自動化等級(Automation Level, AL)來評分:AL0 是完全沒有 AI 參與,AL3 是「協作」(AI 在人類緊密指導下完成大部分工作),AL4 是「主導」(AI 從高階指令出發端到端完成任務、人類負責監督),AL5 則是完全自主、人不在迴路中。
2026 年 8 月的快照數字是:
- Claude 主導了 Anthropic 26% 的 AI 研發工作(AL4 等級)
- AL3 以上「AI 協作」占比超過 90%
- 但 Claude 尚未在任何一塊被量測的研發工作上完全自主(AL5 仍是零)
第二組:Agent 規模與監督機制。
- Anthropic 最常用的內部平台上,同時約有 30,000 個 Agent 在做研發與工程工作
- 線上監控覆蓋 100% 的 Agent 動作(執行前,通常在數秒內),事後也 100% 被納入監控
- 2026 年 8 月分析了逾 10 億次決策,被攔截比例為 0.002%(約 1/47,000)
- 每週標記約 10 萬份對話紀錄交由多個分類器檢查,其中約 50 份升級到人工審查
- 人被阻擋的動作,一週內由人審查
第三組:算力有多少流向安全。
- 2026 年 7 月 13 日至 7 月 20 日的一週樣本中,約 6% 用於 AI 研發的算力流向安全相關工作
- 若只看由 AI 驅動的那部分 AI 研發,流向安全的比例是 12%
- Anthropic 自稱這是保守估計:若一個 token 對能力的推進程度等於對安全的推進,就不計入;此外也不含安全防護分類器本身的算力(Anthropic 稱那是「另一筆可比的算力量」)
這三組數字拼起來的圖像很具體:Claude 已經主導了四分之一的 AI 研發工作,整間公司同時跑著三萬個 Agent,但只有十分之一的安全算力比例守著這套系統。
五、這份報告真正的爭議:證據被刪掉了
METR 與 Anthropic 的合作協議裡有一項權利安排:Anthropic 有權刪除報告中任何非公開資訊。METR 依其透明度原則,必須公開揭露 Anthropic 是否行使這項權利,以及刪除是否影響結論。
他們揭露了,而且坦白得相當直接:
「Anthropic 刪除了我們認為最有資訊量的大部分證據。」
METR 在公開報告中直言,這造成三個後果:許多被刪證據原本有多種合理詮釋、讓公眾無法自行判讀與其他來源交叉比對、使得這份報告無法達成「證據透明」——公眾只能過度依賴 METR 的判斷,而這並非理想狀態。
METR 官方在 X 上也重複了這句話:
「我們提交了一份約 100 頁的完整評估報告給 Anthropic。對外公開版本中,Anthropic 刪除了我們認為最有資訊量的大部分證據。其後果是,公眾必須比我們認為理想的情況更多地依賴我們的判斷。」
關於利益衝突,METR 也逐項列出並確認滿足了第三方評估的要求:沒有索取或收取任何與評估結果掛鉤的報酬(Anthropic 提供的是筆電與 token 額度)、系統提供方未對評估者行使組織或財務控制、且評估者已公布並執行利益衝突政策。
另一份同日公開的 METR 文件《風險報告「自動化 R&D」章節審閱》則給出了更尖銳的判斷:METR 同意 Anthropic 對 2026 年 7 月 15 日模型的災難性風險評估為低,但認為報告中「尚未跨過早期預警門檻」的說法「仰賴了未清楚溝通的可爭議判斷」,並認為公開報告整體低估了當時實際發生的加速程度。
而另一邊,Anthropic 在其 S-1 更新中新增了這段文字:
「我們對內部估計以及對未來模型(而非當前模型)的預期,顯示我們可能即將達到 Responsible Scaling Policy 中『因 AI 而出現戲劇性加速進展』的定義。」
這就是所謂「戲劇性加速」的門檻。依 2026 年 7 月生效的 RSP 定義,該門檻要求同時滿足兩個條件:觀察或預期整體能力進展速度是「AI 還沒大量參與 AI 研發之前」最快持續速率的兩倍,而且相對於「若沒有 AI 自動化會是怎樣」的反事實基準也是兩倍。設兩個條件是為了排除一種情況:如果沒有 AI 自動化,研發本來就會大幅放慢,只是 AI 把舊趨勢維持住了——那不算「戲劇性加速」。
為什麼這件事重要
加速會不會真的複利?
METR 的報告給的是證據,而真正的推論來自 METR 研究員 Ajeya Cotra 在 11 月 6 日發表的分析文章。他在文中做了一件 METR 報告刻意不做的事——把數字往外推。
他的推導分成兩步。
第一步:人力需要被加速多少倍?
整體 AI 能力(「有效算力」)是訓練算力與「計算乘數」(compute multiplier,Anthropic CEO Dario Amodei 對演算法與架構創新的稱呼)的乘積。既然算力乘數只是能力的一個輸入,要讓整體能力加速兩倍,計算乘數的增長速率就必須遠超兩倍——依合理假設約需 2.5 到 3 倍。
接著,發現算力乘數本身需要人力與實驗算力。用最簡單的 Cobb-Douglas 模型(假設兩者同等重要),人力加速就需要是計算乘數加速的平方:約 2 到 3 倍的平方,即 4 到 9 倍。
但這還不夠。因為加速本身會讓「低垂的果實」被更快摘光,每一個新的計算乘數都需要更多時間去發現與實作。Cotra 的估計是:今天的實際人力 uplift 需要大約 10 倍。
這個數字有旁證。Anthropic 內部員工的非正式自述提到,他們目前從內部模型獲得的 uplift 約為 12 倍。兩者意外吻合。
第二步:複利會怎麼走?
Cotra 接著指出,這個 10 倍不該被想像成「每位研究員變成十人團隊」——那種事不會發生。他給的比喻是:每位研究員都處在一個時間扭曲泡泡裡,外面過一天,裡面像過了十天。
如果這個 uplift 隨模型能力提升而持續增強,復利就會啟動。Cotra 給的時間表是:今天一個月能做完過去一年的工作,幾個月後變成一週,然後可能是一天。進展速率會從 4 倍、8 倍、16 倍這樣疊上去。
在這種推演下,他寫道:
「如果我們走完這個反饋迴圈,我預期另一端出來的 AI 系統將能非常迅速地開發新型武器,並在衝突中輕易壓倒人類文明。如果這些系統真的嚴重失準,我認為它們很可能會解除人類的權力,這可能導致人類滅絕。」
必須說清楚的是,Cotra 在文章開頭就註明他沒有參與該專案、也沒有看過未刪節的報告,他所有的觀點都是自己的,不代表 METR 或報告作者的立場。他的數學推導也坦承極度不確定——「今天所需的人力 uplift 也許需要大約 10 倍」、「相當不確定,明顯更高或更低都完全可能」。
但 METR 的報告裡有一個數字讓這種複利推論變得不再抽象:
「整體能力進展速率的翻倍,反過來要求研究人員的速度提升遠多於兩倍。」
如果 AI 只是讓研發快兩倍,這就是個好故事。但 METR 的數學顯示:要讓整體能力翻倍,人力得加速 4 到 9 倍,而要維持這個新速率(面對更高的邊際收益遞減),需要今天就有約 10 倍的人力 uplift。
數據解讀與質疑
這份報告有四個明顯的軟肋。
站在懷疑者的位置看,這份報告至少有四處值得打問號。
第一,基準測試分數不等於真實世界能力。 AECI 是一組可驗證基準測試的彙整。HN 上有開發者指出,每一個點都是多個基準測試揉在一起的結果,而基準測試本質上就是「可被衡量與評估的東西」——這意味著它們可以被(很貴地)拿來訓練。圖表裡沒有呈現的是那些難以、昂貴或根本無法量化的智力面向。METR 自己也承認「AECI 對可驗證任務的專注」是他們可能高估加速的理由之一。
第二,1.9 倍與 1.4 倍的落差沒有解決。 前面提過,Anthropic 自身模型與全業界模型的量測結果相差甚遠,而 METR 明說無法判定哪一種詮釋才對。這個落差直接影響所有下游推論。
第三,刪密讓外部無法驗證。 這不是批評 METR——他們自己揭露了這件事。但客觀事實是,支撐「無瓶頸」與「80% 歸因」這兩個關鍵判斷的證據,恰好就是被刪掉的部分。任何人都無法獨立重算。
第四,METR 的獨立性本身存在疑問。 HN 上有網友直接說「這些人說穿了就是大 AI 實驗室的公關作業」,也有資深研究者指出 METR 團隊的整體立場從來不是「這太棒了」,他們本來就是負責獨立監督的角色。兩種批評都值得聽。
Siami 觀點
真正的新聞不在「AI 加速 AI」這件事本身。
「AI 正在加速 AI」這句話本身不算新聞——過去兩年每一家模型廠商都在說。但這份報告的價值在於三件別的事。
第一,它把「加速」從行銷語言變成一個有信賴區間、有基準量測、有第三方權限背書的數字。 過去你聽到的「我們的模型三個月迭代一次」,沒有任何外部機構能查證。現在有:AECI 1.9 倍、95% 信賴區間 1.5–2.8 倍、4 人 11 週進駐調查、明確排除訓練算力加速這個解釋。這個數字不漂亮、置信度很寬、還被刪掉一半,但它是真的。
第二,Anthropic 自己公佈的那三組儀表,比 METR 的報告更值得每天盯著看。 因為 METR 是外部的季度性快照,而 Anthropic 承諾要把這些數據定期公開發布——「Claude 主導了 26% 的 AI 研發」、「三萬個 Agent 同時在跑」、「10 億次決策攔截 0.002%」、「6% 的算力流向安全」。這四組數字會變。如果未來某個季度「AL4 占比」從 26% 跳到 50%,或者「流向安全的算力比例」從 6% 掉到 3%,那就是比這份報告更有力的訊號。Anthropic 自己也說,這些數字「會因為前沿協調而改變」。
第三,這是一份關於「誰能驗證」的教材。 Anthropic 行使合約刪密權,刪掉最有資訊量的證據,METR 照樣公開發表並主動揭露。這個互動模式值得所有關注 AI 治理的人研究:一家公司願意讓獨立評估機構進駐 11 週,是非常大的讓步;但願意讓步同時保留刪密權,也是非常大的保留。兩件事同時為真。
如果要用一句話總結這份報告的實質:AI 研發的加速是真的(約兩倍),但「加速會不會複利成失控」這個問題,目前既沒有足夠的證據被公開,也沒有被足夠的證據排除。 而 Siami 認為,下一個值得追的節點不是 2027 年的某場發表會,是 Anthropic 那份承諾要定期公開的三組儀表——它們會比任何一份風險報告更早、更具體地給出答案。
延伸閱讀
- METR〈Independent Assessment of AI R&D Acceleration at Anthropic in October 2026〉|完整原始報告
- METR〈Review of the “Risks from automated R&D” section in Anthropic’s Risk Report〉|同日公布的第二份文件
- Anthropic Institute〈Measurements for understanding the pace of AI development inside frontier labs〉|Anthropic 自曝的三組內部儀表
- Ajeya Cotra〈AI is dramatically accelerating AI research right now〉|從 2 倍推到「一年內超級智能」的那篇分析
- Anthropic Responsible Scaling Policy|「戲劇性加速」門檻的官方定義
- AI 2027|2025 年 4 月的開源情境報告,本次事件後被多位元批評為「過時」
- Hacker News 討論串(327 分/288 則回覆)
網友熱門留言 (12)