編按:本文綜合整理自 John Langford〈The End of AI Frontiers〉、Microsoft Research AI Frontiers 官方實驗室頁面、Dion3: Full-stack orthogonal updates(arXiv:2608.11612)、Full-bandwidth transformer(arXiv:2608.08888)、Microsoft Research〈Full-bandwidth transformer〉論文頁、Microsoft Research〈Fara-7B: An Efficient Agentic Model for Computer Use〉、Microsoft 官方部落格〈Announcing Copilot leadership update〉 與 Hacker News 討論串(433 分/260 則回覆),並加入 Siami 編輯部觀點與分析。文中所有研究數字、作者名單與時間軸均引自論文原文與官方公告,非媒體推估。
2026 年 11 月 6 日,John Langford 在自己的部落格寫下一個標題:〈The End of AI Frontiers〉。
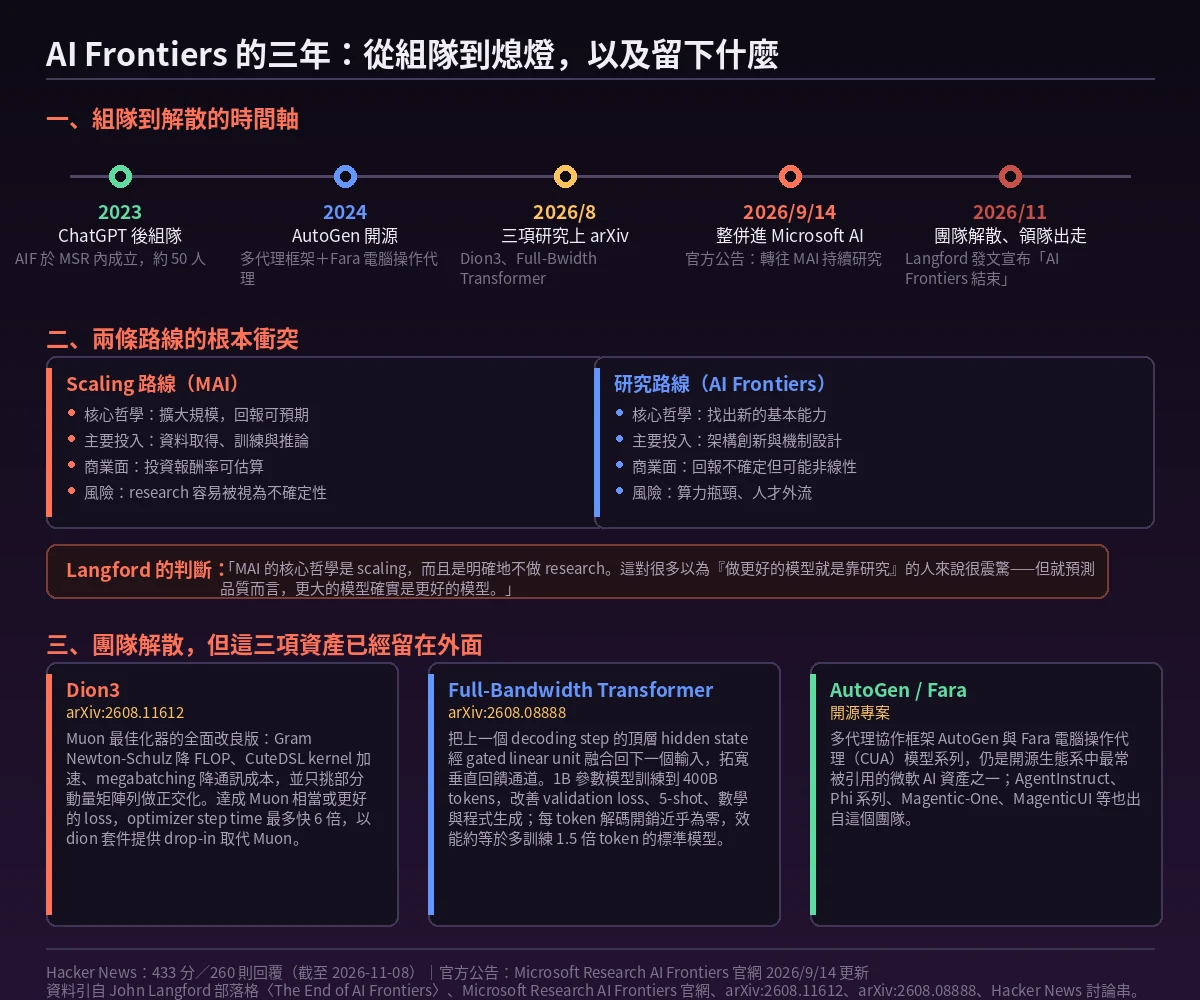
這位 2023 年 ChatGPT 發布後在微軟研究院(MSR)內組起 AI Frontiers 團隊的創辦人,用第一人稱宣布:他一手建立的這個研究組織已經結束,他自己也已經離開微軟。團隊規模約 50 人。
事情並非突然發生。真正的轉折點在 2026 年 9 月初——AI Frontiers 被整併進 Mustafa Suleyman 領軍的 Microsoft AI(MAI),而 Langford 對此的描述是「核心哲學不相容」。
- The Information Bottleneck|World Models — John Langford(Microsoft AI Labs)|第三方頻道 The Information Bottleneck 對 John Langford 的訪談,談他本人帶頭的 Next Latent 研究方向與「世界模型」的世界觀
一、三年間,這個團隊到底做出了什麼
要理解這次的解散為什麼值得關注,得先看清楚 AI Frontiers 不是一個什麼都沒做出來的研究部門。
Langford 在文中回顧:2023 年 ChatGPT 發布後,他判斷微軟研究院內部的既有研究方式不足以應付新的競爭環境——「就算有一個人想出很聰明的點子,也很可能來得太晚、說服力不足,因為一個人移動得不夠快,而一個人能組出來的 baseline 也不夠強,根本無法證明這個點子值得起飛。」於是他和幾位同事著手組織 AI Frontiers。
團隊的定位是「在亂世中間」——不是純粹自上而下,也不是純粹自下而上。Langford 承認其中有難以化解的分歧,而算力往往是嚴重瓶頸。
成果主要有三條線:
- 代理系統:AutoGen 編排框架與 Fara 電腦操作代理(computer use agent)。
- 模型機制:Next Latent 目標函式(讓模型能外推)、Dion3(最佳化過的 Muon)、Full Bandwidth Transformer(讓模型透過遞迴更有效率地運作)。
- 基礎設施:AI Frontiers 決定開發一個預設與整個 MSR 共用的 monorepo,其中包含了那套已經驗證過的 edge scale 預訓練程式碼庫——Langford 說明,這聽起來像小事,但建立一條完善的模型生產管線需要大量投入,他光是在 MSR 內部就至少知道有 4 個團隊(另外 3 個不在公開的 MSR repo 裡)在各自嘗試做類似的事。
這支團隊也明確把自己定位在「agent-native lens」:官方頁面列出他們交付過的東西包括 AgentInstruct、Phi 系列模型、Fara 系列的 CUA 模型、AutoGen、Magentic-One、MagenticUI、Magentic Marketplace,以及 agent 紅隊測試、基準測試與安全研究。實驗室主任是 Ece Kamar。
二、9 月 14 日的官方公告,與「不相容」到底指什麼
微軟研究院官方頁面在 2026 年 9 月 14 日更新,寫得很直接:
Update, Sept. 14, 2026 – Microsoft Research AI Frontiers is now part of Microsoft AI. Our lab has long focused on advancing frontier research in efficient language models and agentic systems, while reimagining existing computing through an agent-native lens.
官方說法是「我們會在 MAI 追求同樣的目標」——humanist superintelligence,專注於真實問題、服務於人。
但 Langford 在部落格裡的描述要尖銳得多。他寫道,把 AIF 和 MAI 兩個組織合在一起「表面上看起來合理」,因為能集中資源;但實務上有實質問題:
The core philosophy there is scaling, and aggressively not research.
MAI 的核心哲學是 scaling,而且是明確地不做研究。Langford 補了一句他認為很多以為「做更好的模型就是靠研究」的人會感到震驚的話——但他同時承認,就預測品質而言,更大的模型確實是更好的模型;而從商業角度,回報到 scaling 的可預測性,遠高於回報到研究。
這裡有個關鍵細節:MAI 由 Mustafa Suleyman 領軍,而 Suleyman 是 Inflection AI 的共同創辦人、前 DeepMind 共同創辦人。Langford 沒有指名批評個人,但「ex-Inflection leadership」的措辭已經把衝突來源點得很清楚了。
於是有了那個在 Hacker News 上引發最多共鳴的段落:
Aside from the incompatible focus, there was plenty of evidence that they just did not really want us.
除了方向不相容之外,還有大量證據顯示對方「並不真的想要我們」。
Langford 說,他把下面的人安頓好之後就離開了。他也坦承不願回 MSR 的兩大理由:第一,他不想待在一個「自己做的研究沒有實際落地路徑」的公司;第二,他擔心 MSR 的基本契約正在崩壞——「把工作做好,好事就會發生」這件事。「就我看來,我們做出了好工作,然後被非自願地重組掉了。」
三、ByteDance 那個實驗,才是真正的爭點
如果這篇部落格只是抱怨組織政治,那它的新聞價值就到此為止。但 Langford 舉了一個具體的量化論據來支撐「研究值得投入」。
他引用的是 ByteDance 的實驗:
the Bytedance experiments suggest a variant of the Full Bandwidth Transformer might be comparable to a model of twice the size, implying significant savings in training and inference for the same capability. Do the math—how much is it worth to halve training and inference cost given that the industry has investments approaching a trillion dollars?
如果一個架構變體能達到兩倍大模型的同等能力,那意味著同等能力下的訓練與推論成本可以砍掉一半。 而當產業投資規模「接近兆美元」時,這筆帳是值得認真算的。
這不是空話。Langford 是 Full-Bandwidth Transformer 論文(arXiv:2608.08888)的共同作者之一,該論文第一作者為 Xi Wang,共同作者還包括 Ziyang Cai、Zheng Zhan、Harry Dong、Ying Fan、Gustavo de Rosa、Tim Pearce,2026 年 8 月 9 日提交,10 月 1 日修訂。
論文的核心機制是把 transformer 的「垂直回饋通道」拓寬:自回歸 transformer 沿兩個軸計算——橫向沿著已生成的 token,縱向沿著模型深度。密集注意力給了每個 token 廣泛的橫向存取,但縱向回饋通道依然很窄:只有被抽樣出來的 token 會回到堆疊底部,頂層的 hidden state 則被丟棄。 Full-Bandwidth Transformer 的做法是,在每個 decoding step,把上一個 step 的頂層 hidden state 透過 gated linear unit 與 token embedding 融合後餵回作為下一個輸入。這讓「非語言化的運算」可以重新進入堆疊,並帶著一份重置的深度預算。
實驗結果:1B 參數模型訓練到 400B tokens,改善了 validation loss、5-shot 語言模型評估、數學與程式生成,以及指令微調後的表現。在每 token 解碼開銷近乎為零的前提下,全頻寬 transformer 能追平或逼近多訓練約 1.5 倍 token 的標準 transformer,而且在沒有提供 off-policy 模板時能產生更短的推理過程。
而 Dion3(arXiv:2608.11612,2026 年 8 月 12 日提交,作者含 Noah Amsel、Jack Zhang、Kwangjun Ahn、Ali Naeimi、Austin Feng、Berlin Chen、Tri Dao,以及 John Langford)則從最佳化器下手,針對 Muon 的 Newton-Schulz 正交化步驟在堆疊各層的開銷逐層改良——Gram Newton-Schulz 演算法降低 FLOP、CuteDSL kernel 利用對稱性加速、megabatching 降低通訊成本,再加上只挑動量矩陣的一部分列來做正交化的更新規則改動。最終結果是達成與 Muon 相當或更好的 loss,同時把 optimizer step time 最多縮短 6 倍,並以 dion 套件形式提供作為 Muon 的 drop-in 取代方案。
換句話說,這支團隊留下的不只是一份部落格,而是兩篇有具體、可重現效能數字的研究論文。
四、Hacker News 的反應:真正的爭點不在微軟,在 scaling 還能撐多久
討論串累積 433 分、260 則回覆。反應大致分成三條線。
第一條線是「這不只是 AIF 的事,是整個 MSR 的事」。 網友 frolix 的說法最尖銳:他認為真正的消息是「微軟研究院的終結」,AIF 只是過去一年多來被拆出去的一個個部門中的一個;他提到 Kevin Scott 底下的 T&R 部門大約一年前就悄悄解散,MSR 後來被重組到 Azure Security 底下。
第二條線主張把 scaling 與研究的爭論拉回到「基礎設施才是瓶頸」。 網友 godelski 指出,因為預訓練細節從不公開發表,大家就「懶得把架構改進歸因於 scale」——而 scale 是什麼的 scale?要到 AGI 以上,需要的是架構改變而不只是更多資料。
第三條線是對 scaling 極限的量化懷疑。 網友 mrandish 用 S 曲線的歷史規律指出,幾乎每個物理、計算與經濟系統在拐點前看起來都是超線性成長,LLM 智力的成長率大約會在兩到四年內達到峰值。Zigurd 則從資本市場角度切入:如果 scaling 真的通往無限算力需求,「沒有任何一個為了滿足這個需求而建的公司會有垃圾債評級」——是那些搞錢的人不懂嗎?
還有一則回應特別值得記錄,因為它把整件事拉回最實際的商業邏輯。網友 lovich 說:花在算力上的錢是花在公司完全擁有的機器上,而花在研究員身上的錢是花在另一群有權利、能觸發高管社會階層腦回路的猿類上。公司會試圖殘忍地擺脫勞動。
這或許是對整個事件最簡潔、也最不留情面的解釋——在資訊不對稱的情況下,「買機器」的資產負債表永遠比「養人才」好交代。
為什麼這件事重要
第一,這是 2026 年「研究 vs 商業」路線之爭第一次由當事人用第一人稱完整說清楚。 過去兩年,類似的爭論總是停留在推測:某某實驗室是不是被整併了、某某大廠是不是放棄了 research。Langford 這篇文章難得之處在於,它把三件事同時擺在一起——組織層面的整併時間點、哲學層面的衝突(scaling 而非研究)、以及量化層面的反證(Full-Bandwidth Transformer 可能等同兩倍大模型)。 這三件事合起來,才是完整案例。
第二,它把「模型效率」從工程問題提升成資本配置問題。 ByteDance 那個實驗的意義在於:它把架構創新從「研究者的浪漫」轉換成一個有明確金額的選項。當產業在算力上的投資接近兆美元時,「同等能力下成本砍半」不是一個學術主張,而是一個任何 CFO 都聽得懂的句子。如果這條路是通的,它甚至不該由微軟的研究院來證明——而該由微軟自己來賺。
第三,它凸顯了開源作為「解散後遺產保存機制」的價值。 這支團隊解散了,但留下來的東西全部在外面:Dion3 在 arXiv 上並以 dion 套件發布、Full-Bandwidth Transformer 有完整論文與可訓練的開源實作、AutoGen 是 GitHub 上最常被引用的多代理框架之一、Fara 是 Microsoft 官方的 CUA 模型系列、Phi 系列與 AgentInstruct 早已是業界常識。這意味著「解散」對外部生態的實際損害,遠小於對組織內部語氣的衝擊。 對照之下,如果這些成果被鎖在某個內部 repo 裡,跟著團隊一起消失,那就完全是另一個故事了。
第四,這是給所有「在公司做研究」的人的一堂課。 Langford 說他離開,是因為「不想待在一個自己做的研究沒有實際落地路徑的公司」,以及擔心 MSR 的基本契約正在崩壞。一個研究組織的存在前提,是組織內部相信「把工作做好,好事會發生」。當這個前提失效的時候,理性反應就是退出——而退出本身,會進一步削弱留下的人對這個前提的信心。
數據解讀與質疑
「scaling 而非研究」這個診斷,來自單一當事人的敘述。 Langford 是被整併的一方,也是主動離開的一方。他的描述對組織內部發生了什麼具有很高的資訊價值,但「MAI 的核心哲學是 scaling,而且是明確地不做研究」這種概括,畢竟是事後的個人詮釋,不是微軟的官方說法。官方公告講的是「在 MAI 追求同樣的目標」「humanist superintelligence」。兩個版本之間的落差有多少是實質的組織差異、有多少是离职者敘事的取捨,從外部無法驗證。
「兩倍大的模型」這個等價說法,需要非常小心地讀。 ByteDance 的實驗是在特定設定下的比較,而 Full-Bandwidth Transformer 論文自身的數字是「約等於多訓練 1.5 倍 token 的標準 transformer」——注意這兩個數字來源不同:1.5 倍是論文自己的結果,2 倍是 Langford 轉述的 ByteDance 實驗(針對一個「variant」)。把 2 倍這個數字當成論文結論,是不精確的。 論文自己也說了這是「comparable to」而非等價,而且實驗規模是 1B 參數、400B tokens——這與前沿模型的規模相差甚遠。
「兆美元投資」是產業整體數字,不是這個團隊能影響的錢。 Langford 問「砍半訓練推論成本值多少」,前提是這些錢花在 scaling 上。但如果 MAI 的判斷是 scaling 的邊際報酬仍然高於研究,那麼即使架構創新能省一半成本,最優解仍然是「把省下來的錢繼續投入 scaling」。這才是這個爭論最硬的核心,而不是誰比較有遠見。
HN 討論串的樣本有嚴重偏差。 這是一個 433 分、260 則回覆的技術社群討論,參與者高度集中在熟悉 transformer 與研究方法論的工程師。這類討論中「研究派」的比例,幾乎肯定高於企業 AI 採購決策圈的實際比例。在 HN 上讀到的共鳴強度,不等於業界的共識強度。
最需要被質疑的,其實是「研究路線被解散 = 研究失敗」這個前提。 AIF 的解散有太多可能原因:MAI 策略調整、人事權鬥、資源週期、甚至只是組織合併的副作用。HN 網友 frolix 說的「真正的消息是微軟研究院的終結」提供了另一種解釋框架;而 ViktorRay 關於「開除說錯話的人會導致 group think」的評論則提醒:這類事件裡,研究組織的消失往往是方向被定調之後的結果,而不是原因。
最後,Langford 自己的未來是未知的。 他寫「我很幸運,因為世界上還有很多其他人能看到研究的價值,而這正是我內心真正的核心興趣」,並說「每一個 AIF 創辦領導團隊成員似乎都做出了類似結論」。但他同時指出,微軟可能會發展出「讓研究再次變得有吸引力的智慧」,而他並未說自己會回去。這支團隊的集體出走,本身就是一種市場訊號——但它是個小樣本。
Siami 觀點
這篇文章真正有意思的地方,不在「又一個大廠研究團隊解散了」,而在它把 2026 年 AI 產業最深的那條裂縫,用第一人稱攤開了。
裂縫的兩邊,都有非常堅硬的道理,這才是它難解的地方。
Scaling 這邊的理由不是偷懶。Langford 自己都承認「就預測品質而言,更大的模型確實是更好的模型」,而且從商業面看,scaling 的回報可預測、研究的回報不確定——對一家市值數兆美元、每季度要對股東交代的公司而言,選擇可預測的那一邊是理性的、幾乎是生存性的。Suleyman 帶進來的是 Inflection 與 DeepMind 的血脈,那是一種把 AI 當產品工程而非基礎科學來做的傳統。
研究這邊的理由也不是浪漫。Full-Bandwidth Transformer 在 1B 參數規模上做到「等同 1.5 倍 token」,Dion3 把最佳化器步驟時間砍到 1/6——這些都是可以在論文裡複現的數字,不是 PPT。當算力成本是硬上限時,架構效率就是唯一能讓能力持續往上走的通道。
Siami 的判斷是:這個衝突的正確解法,在 2026 年這個時間點上,並不是二選一,而是把研究與 scaling 拆成兩個不同的會計科目。
Nevermark 在 HN 上提出的一個三階段模型,比這整場口水戰都更有建設性:第一階段是開放研究(自由度大、成本低、點子多);第二階段是成果篩選與中等規模驗證(把看起來可行的點子挑出來、用中等預算確認效益);第三階段才是大規模投入。目前的問題是,大廠把第一階段直接跳過了——因為在 scaling 的回報還很清楚的時候,沒有任何一個 CFO 會批准一筆「探索性」的預算。
但這正是像 AIF 這樣的團隊存在的原因:他們做的,是第一階段。 而當一個組織把第一階段的人整併掉,理由是「第一階段產出的東西還不能立刻變成 scaling 的燃料」,那麼三階段模型就永遠不會成立。
所以,這件事對台灣的 AI 團隊有一個很實際的提醒:在 scaling 邊際報酬還很高的這兩三年裡,沒有人會資助你的研究——這不是陰謀,是會計。 因此台灣的研發路線如果要走,唯一可能的位置是在「研究」這個工作本身能變現的地方:把架構創新做成別人願意付費的服務、把開源最佳化器做成部署在自家硬體上的差異化、把代理系統做成產業垂直的落地能力。不是去跟微軟比誰的模型大,而是去做那些大廠 scaling 之餘不會做、也做不划算的事。
最後一點:Langford 在文章結尾寫「我不敢意外地看到這類事情持續發生,直到微軟研究院領導層發展出足以應對這個時刻的意願」。這是整篇文章最傷心的一句話。一個組織最貴的成本,不是裁掉多少人,而是讓最願意做困難研究的人開始懷疑「做好工作就會有好事發生」。 這個成本不會出現在任何一份財報上,但它會出現在五年後那個組織還有沒有能力做出原創成果上。
延伸閱讀
- The End of AI Frontiers(John Langford 部落格原文)|本次事件的一手聲明,HN 433 分/260 則回覆
- Microsoft Research AI Frontiers 官方實驗室頁面|2026/9/14 官方公告「AI Frontiers is now part of Microsoft AI」,並列出 AutoGen、Fara、Phi、AgentInstruct、Magentic 系列等交付成果
- Dion3: Full-stack orthogonal updates(arXiv:2608.11612)|Muon 的全面改良版,達成相當或更好 loss,optimizer step time 最多快 6 倍
- Full-bandwidth transformer(arXiv:2608.08888)|拓寬 transformer 垂直回饋通道,1B 參數訓練至 400B tokens,約等於多訓練 1.5 倍 token 的標準模型
- Microsoft Research〈Full-bandwidth transformer〉論文頁|官方出版版本與實作細節
- Microsoft Research〈Fara-7B: An Efficient Agentic Model for Computer Use〉|AIF 團隊的電腦操作代理代表作
- Microsoft〈Announcing Copilot leadership update〉|Microsoft AI 領導結構調整的官方說明
- Hacker News 討論串(433 分/260 則回覆)|關於 scaling 極限、研究商業化與 MSR 命運的實戰爭辯
網友熱門留言 (9)