編按:本文綜合整理自 llama-modchip 官方 repo、Hacker News 討論串(292 分/104 則回覆)、antirez〈deepseek-v4-gguf〉討論區第 24 篇、Unsloth〈DeepSeek-V4: How to Run Locally〉、arXiv〈Reliability Scaling Laws for Quantized Large Language Models〉、arXiv〈Four Over Six〉 與 Synchopate 於 Hugging Face 發布的量化模型,並加入 Siami 編輯部觀點與分析。文中所有 GGUF 檔案體積數字,均為 Siami 於 2026 年 11 月 9 日以 Hugging Face tree API 實測加總所得。
2026 年 10 月 29 日,GitHub 上多了一個叫 llama-modchip 的專案。十天後,它登上 Hacker News 首頁,累積 292 分、104 則回覆,專案本身則有 416 顆星、25 個 fork、9 個 open issue。
它要解決的問題很具體:把 284.33B 參數的 DeepSeek-V4-Flash-0731,塞進一台只有 64 GB 記憶體、而且完全沒有顯示卡的機器裡。
這不是概念驗證,repo 裡有可執行的二進位檔、Hugging Face 上有權重、有 30 人以上的社群跑分排行榜、有 Apple Silicon 與 Windows 的專屬指南。作者在架構文件中自稱 Paolo C,GitHub 帳號為 synchopate。
一、這是什麼:llama.cpp 的核心修補,不是新模型
llama-modchip 的本質不是訓練了一個新模型,而是對 llama.cpp 進行核心層級的修改,加上自己寫的量化轉碼器。官方 README 把它拆成三塊:ggml/llama.cpp 的核心修補、量化轉碼器、以及執行期工具。
開發者可以用 ./modchip chat 開互動式終端機聊天、./modchip web 開深色模式的網頁聊天與即時遙測 HUD、./modchip bench 跑 30 秒兩階段測速並印出可分享的跑分卡、./modchip claude 直接啟動接上本地 256K 引擎的 Claude Code CLI(載入 40 個工具)。
專案採 Apache 2.0 授權,授權證書就在 repo 裡。
真正值得注意的是時間軸。作者在 11 月 5 日就把技術貼到 antirez 的模型討論區(〈[Tip for 64GB RAM Users]〉),當時標題已經寫明「Fitting DeepSeek-V4-Flash 284B in 56.56 GiB」,三天後才在 GitHub 正式公開並引爆 Hacker News。
二、核心工程:76.87 GiB 怎麼壓成 56.56 GiB
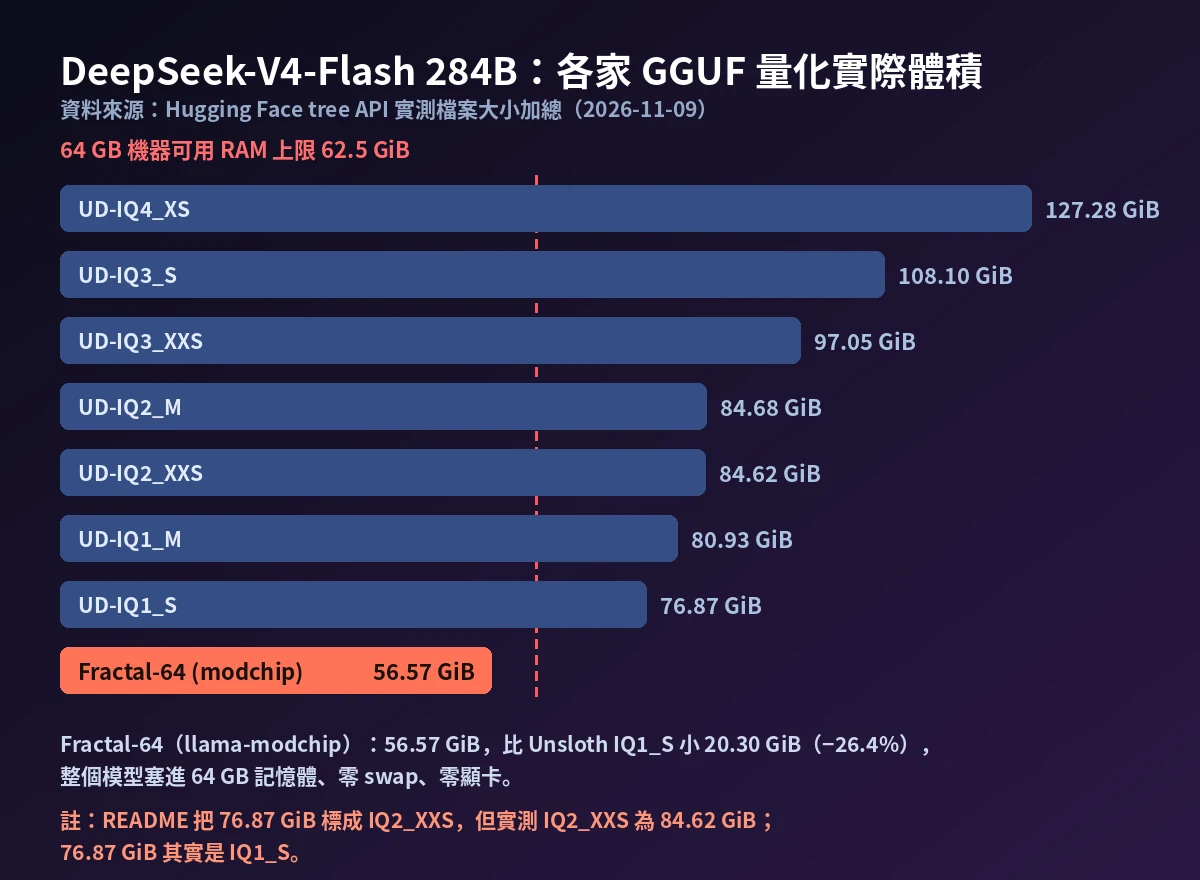
問題的物理起點很直觀。64 GB 的 Linux 機器,扣掉核心保留等開銷後,實際可用 RAM 約 62.5 GiB。而 Unsloth 最小的 UD-IQ1_S 量化是 76.87 GiB——放不下。
放不下會發生什麼?作者在架構文件裡描述得很具體:76.87 GiB 的 GGUF 會在每生成一個 token 時,把約 16 GiB 溢寫到 NVMe page cache,造成 93% 的速度衰退,或者直接被 OOM killer 殺掉。
轉碼器本身是一支獨立的 C 程式(scripts/transcode_dsv4.c),不需要任何校準資料集。主要手段有兩道:
- SwiGLU-H2 二階 Hessian 壓縮(−15.49 GiB)——利用 SiLU 閘門乘上上投影的閉式 Gauss-Newton 對角項,把
ffn_gate_exps依W_up的列範數、ffn_up_exps依W_gate的列範數交叉加權,再壓進IQ1_S(1.5625 bpw)。 - Block-64
Q2_0的 MLA 與稀疏索引器轉碼(−4.82 GiB)——把注意力投影(attn_k_b等)壓到 3.75 bpw,其中attn_k_b從 3.70 GiB 降到 1.62 GiB,而所有密集 MLA 的 Q/V/O 與共享專家維持在Q5_K/Q6_K。
加上第三道純效能層的改動:四層快取分級(ZMM AVX-512BW 暫存器、L1D 32 KB、L2 1 MB、L3 64 MB)的多欄位預填排程,宣稱讓預填速度從 25.0 提升到 44.36 tok/s(+77.1%)。
還有一個容易被忽略但很實用的設計:預設情況下每層 6 個 routed experts 全部照算,不做任何剪枝,相對於未修補的執行期在同一份 checkpoint 上,logit 餘弦相似度為 1.00000、KL 散度為 0.0000、top-1 與 top-3 命中率都是 100%。
三、效能數字:純 CPU、零顯卡、256K 上下文
以一台 AMD Ryzen 9 9955HX(16 核 32 執行緒、Zen 5、64 GB DDR5、0 GPU)為基準:
- 預填:43.16–44.36 tok/s(相較未修補版本 +77.1%)
- 純解碼:9.06–9.95 tok/s(lossless Top-6 預設)
- 搭配 Stockfish-PVS 推測解碼:11.5–14.7 tok/s
- 256K 上下文時 VmRSS:57.61 GiB,零 swap
- KV slot 還原:13.1–32.6 毫秒(40 個工具的 Claude Code prompt),比冷啟動快約 6,800 倍
那個 1.64 MB 的 Stockfish-PVS v2 推測解碼器,是這套設計裡最巧的一環——它不是另一個小型草稿模型,而是把國際象棋引擎 Stockfish 的證據搜尋樹拿來當 n-gram 預測器,靠 L2/L3 快取裡的 Zobrist 雜湊做路徑預測。
社群跑分榜的跨平台數據也相當完整:Threadripper PRO 7985WX(64 核、256 MB L3)解碼可達 111.62 tok/s;Apple M4 Max(64 GB 統一記憶體)49.2–57.7 tok/s;AWS Graviton3 m7g.2xlarge(ARM64)44.97 tok/s;而一台只有 AVX2、沒有 AVX-512 的老 EPYC 7402P 則是 27.29 tok/s。
同一套工具鏈也支援較小的模型:NVIDIA Nemotron-3.5-30B-A3B 轉成 Fractal-64 後只要 14.35 GiB,解碼 25.02 tok/s,並且在專案自訂的 100 分品質門檻(Quality Gate)上拿下 100.0/100.0。
四、社群的兩面反應:技術欣賞與「README 是 AI 廢話」
Hacker News 的討論串相當兩極,而兩邊的理由都值得記下。
技術面的肯定來自實際跑過的人。網友 rpdillon 表示自己一直用 2-bit 量化版的 DeepSeek V4 Flash 0731,跑約 15 tok/s,作為程式碼代理裡的「smol model」,覺得很好用;網友 latentsea 則說,多數人看到 2-bit 就生理不適,卻從來沒真的測過它能不能處理自己的任務。網友 kennywinker 算了一筆經濟帳:一台 E5 工作站加上 300 美元記憶體與 100 美元 GPU 就能跑出 100+ tok/s 預填、20 tok/s 輸出,不到 800 美元的組態就有辦法跟不到一年前的 SOTA 打成平手。
批評則集中在兩個地方。
第一是文件品質。網友 intoXbox 說「這是一份非常惱人的 README.md,滿是 AI 廢話」;superkickstart 抱怨「希望有人能把 GitHub README 裡 AI 塞滿的 emoji 清乾淨,可讀性實在很糟」;epihelix 說「拿掉 emoji 對這份 README 的可讀性幫助不大,LLM 味已經開到 11 了」;dofm 則說「這份特別難以閱讀,幾乎沒有人類可讀性,非得靠 LLM 摘要不可」。
第二是數據一致性。網友 adrian17 具體指出 README 把 76.87 GiB 這個數字標示為 IQ2_XXS,但同一頁又說 IQ2_XXS 是 91GB、IQ1_S 才是 82.5GB——所以 76.87 GiB 對應的其實是 IQ1_S。他還懷疑「moe pruning」的意思是本來每層要跑 6 個專家、現在只跑 4 個來省時間。
還有人從量化理論的角度反對。網友 armcat 引用 arXiv 的〈Reliability Scaling Laws for Quantized Large Language Models〉指出,量化是非線性的,size-to-performance 的峰值通常出現在 4-bit;網友 throw10920 則用一句話總結:「2-bit 量化是『看看我能塞多大的模型到這台硬體上』的 in mice。」
Siami 的實測結論:adrian17 抓到的標示錯誤確實存在,但只存在於 ARCHITECTURE.md,README 本身寫對了。
五、真正的關鍵變數:這是一個「量化感知訓練」出來的模型
要判斷 1.71 bpw 到底會不會壞掉,先得知道被壓縮的是什麼。
Unsloth 的官方文件寫得很清楚:DeepSeek-V4-Flash 是量化感知訓練(quantization-aware-trained)出來的模型,官方 checkpoint 直接把 routed experts(佔模型 96%)以 MXFP4 原生儲存,其餘部分則是 FP8 或 BF16。 Unsloth 自己的 UD-Q8_K_XL 量化號稱是全無損的,因為 GGUF 的 MXFP4 正是那個格式,可以位元對位元重新打包,實測 1,328 個張量全部與官方權重位元相同。
這解釋了 llama-modchip 為什麼敢往下壓。回到它的張量配置:43 個 shared experts、密集 L0 層、MLA 的 kv_a/q_a/wkv_b 全部維持在 Q4_K/Q5_K/F32;只有 256 個 routed experts 被壓到 IQ1_S(1.5625 bpw),並且對敏感邊界層另外保留 IQ2_XXS(2.06 bpw)與 IQ1_M(1.75 bpw)。
換句話說,1.71 bpw 是一個混合平均值,不是每個權重都只剩 1.71 bit。真正被推到極限的是那 96% 的 routed experts,而它們恰好是模型原生就以 4-bit 家族格式訓練出來的部分。對一個一般模型來說,1.7 bit 是災難;對這個模型來說,是把它推離舒適區但推得不遠。
另外補一個背景數字:DeepSeek-V4-Flash 於 2026 年 7 月 31 日發布,總參數 284B、激活 13.17B,原生上下文長度 1M,llama-modchip 目前開放的是 256K。
為什麼這件事重要
第一,推理的成本結構正在被從下面掀開。 過去兩年「本地 AI 能不能用」的門檻是顯存:H100 的 80 GB,消費級顯存的 16 GB。現在一個 10 天內從零寫出來的單人專案,把 284B 塞進 64 GB DDR5,並且拿到 43 tok/s 的預填速度。這不代表 GPU 會消失,但它意味著**「沒有 GPU 的人」與「有 GPU 的人」之間的能力落差,正在被工程手段而不是採購預算填平**。台灣的工作室、接案工程師、資訊科老師這類沒有預算買多張 H100 的人,門檻正在往下掉。
第二,真正的護城河從算力轉向記憶體頻寬與核心工程。 這套設計所有效能提升的來源都很具體:記憶體頻寬牆、O(N²) 預填與 TLB 牆、L3 快取被冷專家權重逐出的問題、非時域載入指令(_MM_HINT_NTA)的 L3 隔離。這些是讀懂硬體微架構的人才做得出來的事。
第三,也是最容易被忽略的一點:模型訓練方式決定了部署難度。 DeepSeek 把 96% 的權重以 MXFP4 原生訓練,等於提前把「壓縮後還能撐多久」算進了模型的能力預算裡。這是一種模型設計與部署工程共同設計的新典範——未來能跑進 64 GB 的模型,會是那些一開始就朝著「要能跑進消費級硬體」去訓練的模型,而不是事後才拿量化去硬壓的模型。
數據解讀與質疑
「1.71 bpw」是混合平均值,不該被解讀成「整個模型只有 1.71 bit」。 這個數字是把 Q4_K/Q5_K/F32 的高精密度部分與 IQ1_S 的專家權重攤平後的結果。真正承受壓力的是 256 個 routed experts(1.5625 bpw)。網友 throw10920 的「in mice」批評雖然刻薄,卻指出了正確的誤讀方向。
那組漂亮的 1.00000 logit 相似度,量的是核心修補的忠實度,不是量化的保真度。 這是最需要澄清的一點。README 的原文是「相對於同一份 checkpoint 上未修補的執行期」,也就是說:這是在同一個 56.56 GiB 的檔案上比對 AVX-512 修補版與參考實作,證明核心改寫沒有算錯。它沒有證明這份 56.56 GiB 的檔案與原始 FP8/MXFP4 官方權重之間的差距有多大。adrian17 那句「最終的 gguf 只有 Unsloth IQ1_S 的 75% 大小,光看這點就知道品質是什麼樣子」,正是指這個未被量化的缺口。專案自己也公開了對照數據——同樣的 56.56 GiB 檔案,在未修補執行期上 decode 僅 5.91 tok/s,修補後為 9.06–9.95 tok/s——但那是速度的對照,不是品質對原始權重的對照。
作者其實有誠實列出代價,這點值得記一筆。 表格顯示預設的 lossless Top-6 模式 logit 相似度 1.00000、KL 為 0;但切到 Top-5 + L2 正交時相似度降到 0.99714、KL 0.0042 nats(困惑度 +0.42%)、top-1 命中率 95.8%;再切到 Top-4 Turbo 模式則是相似度 0.99126、KL 0.0281–0.0694 nats。預設值設定在 lossless 那一欄,而不是在效能最好的那一欄,這個取捨是站得住腳的。
arXiv 那篇量化可靠性論文不能直接套用在這個案例上。 〈Reliability Scaling Laws for Quantized Large Language Models〉(TUM,2026 年 7 月 12 日)確實指出可靠性在 4-bit 達峰、且呈非線性關係,但論文本身明確把量化感知訓練列為範圍之外。Hacker News 網友 Youden 抓到了這一點:「它明確說 QAT 不在範圍內,可能會顯示出不同的趨勢,也可能在極低量化下展現出潛力。」而 QAT 正是本例的前提。 所以「1.71 bpw 一定壞掉」與「bit-exact 所以一定沒問題」這兩個結論,都下得太快。
採用度仍然非常小。 Hugging Face 上 Synchopate 發布的兩個模型,下載數分別是 234 與 347 次。416 顆星很好看,但離「有人在生產環境天天跑」還有距離。社群跑分榜的 30 多人,多半是業餘愛好者的一次性測試。
「0 GPU」不等於「不需要成本」。 這條路徑需要 AVX-512BW(Zen 4/Zen 5)或走 AVX2 的相容模式,需要 64 GB DDR5,而且預填速度高度依賴實體核心數——同樣 64 GB 的機器,一台 16 核 Ryzen 9 9950X 只有 20.78 tok/s 解碼,一台沒有 AVX-512 的 EPYC 7402P 是 27.29 tok/s 解碼但 TTFT 高達 567 毫秒。
Siami 觀點
這件事最值得台灣讀者帶走的,不是「本地 AI 贏了雲端」這種結論——10 tok/s 的解碼速度,要跟 Opus 5.5 或 Astra 級別的模型比聰明程度,差距是本質性的,網友 gavinray 說得很直白:「拿能跑在那種硬體上的模型,去跟前沿模型比較,是很 silly 的。」
真正有價值的是兩個判斷。
第一,QAT 重新定義了「低精度」的門檻。 DeepSeek 在訓練階段就把 96% 的權重放進 MXFP4,等於模型的能力預算裡已經預留了量化損失。這意味著未來的模型競爭,除了參數量與訓練資料,還要拚「原生量化友好度」。一個設計良好的 284B QAT 模型,在 64 GB 機器上的實用性,可能高於一個更大的非 QAT 模型——這是一個跟「模型大小競賽」完全不同的指標。
第二,這條路徑的瓶頸不在技術,而在上游審查速度。 網友 SillyUsername 指出,llama.cpp 的 PR 積壓已經到 1.9K,而他們一天建置多次,只有幾個志願者審查。Bonsai 的 Qwen 3.8 支援從建立到被審超過三週,之後還有 bug 是下游修好後直接放棄推回上游的。llama-modchip 本身也是 ggml 的 fork 與修補集。這是開源 AI 生態真正的結構性瓶頸:算力可以靠錢買,維護者時間不能。 如果這套 AVX-512 修補與 Fractal-64 格式能進到上游 llama.cpp,價值會遠大於現在;反之,它就只是又一個需要自己維護的分叉。
至於 README 被罵得那麼慘,說實話,這對讀者反而是好事。它逼著人把技術主張拆開來自己驗——adrian17 正是因為讀得不順才去比對 Unsloth 的實際檔案大小,才抓到那個標示錯誤。能讓社群用「你這個數字對不對」而不是「讚嘆」的方式討論的專案,通常技術底子比較紮實。
延伸閱讀
- llama-modchip 官方 repo|核心專案,含 ARCHITECTURE.md 技術白皮書與社群跑分榜
- Hacker News 討論串(292 分/104 則回覆)|adrian17 的量化標示質疑、armcat 的量化可靠性引用、kennywinker 的成本試算
- antirez〈deepseek-v4-gguf〉討論區第 24 篇|作者於 2026-11-05 發布的原始技術貼,含完整的轉碼三步驟說明
- Synchopate/DeepSeek-V4-Flash-0731-Fractal-64GB-CPU-GGUF|56.57 GiB 的 3 分片權重與可直接執行的二進位檔
- Unsloth〈DeepSeek-V4: How to Run Locally〉|說明 DeepSeek-V4-Flash 為量化感知訓練模型、96% routed experts 原生 MXFP4
- Unsloth/DeepSeek-V4-Flash-0731-GGUF|各家 UD-IQ 量化基準,Siami 實測體積對照的資料來源
- arXiv〈Reliability Scaling Laws for Quantized Large Language Models〉|TUM 研究團隊,2026-07-12,指出量化可靠性在 4-bit 達峰
- arXiv〈Four Over Six: More Accurate NVFP4 Quantization with Adaptive Block Scaling〉|NVIDIA 自適應區塊縮放,量化誤差改進的另一條路線
- David Hendrickson(@TeksEdge)的 X 貼文|開發者社群對此專案的即時反應
- antirez(@antirez)的 X 貼文|Redis 作者談 DwarfStar 以 SSD streaming 方式跑 DeepSeek-V4.1-Flash
影音補充:上影片由第三方頻道 Codacus 製作,內容為 Colibri 與 llama.cpp 兩種路線在純 CPU 上執行 DeepSeek V4 284B 的對比實測,並非 llama-modchip 官方頻道。Hacker News 討論串中亦有網友指出,Colibri 這類專案早於 llama-modchip 就已在處理相同的硬體挑戰,兩者可對照閱讀。
網友熱門留言 (6)