編按:本文綜合整理自 Anthropic 官方發表〈Claude Fable 5.2 and Mythos 5.2〉、claude.dev 官方部落格〈Safely scaling multi-agent teams with Claude Fable 5.2〉、CNBC〈Anthropic releases Claude Fable 5.2 and Claude Mythos 5.2 ahead of IPO〉、The Verge〈Anthropic launches new Claude Fable and Mythos 5.2 models〉、Artificial Analysis 模型比較頁、Claude Platform 模型文件〈claude-fable-5-2〉、Hexagon〈The spinless modular bootstrap at large central charge〉、Hexagon〈The Hawking-Page transition at weak coupling〉、Kingy AI〈Claude Fable 5.2: Specs, Benchmarks, Evals and Pricing〉、AWS 官方部落格〈Introducing Claude Fable 5.2 on AWS〉 與 Hacker News 討論串(879 分/526 則回覆),並加入 Siami 編輯部觀點與分析。文中所有基準測試分數、價格外推與安全數據均引自 Anthropic 官方文件與獨立第三方評測,未做自行推估。
2026 年 11 月 9 日美西時間上午,Anthropic 發布了 Claude Fable 5.2 與 Claude Mythos 5.2。發布稿的第一句話很安靜:模型升級了,針對「最艱難的技術挑戰」而設計。但接下來的三段列舉,才是這份稿子真正的重量所在——在內部測試階段,模型幫助工程師完成原本不可能的軟體遷移、從零設計三個可運作的電子裝置、解決兩個黑洞物理學的開放問題、在機器人評測上取得實質進展,並在 30 小時內形式化證明了費馬馬大定理。
Hacker News 上這則討論在發布當天累積 879 分、526 則回覆(統計至 2026 年 11 月 10 日上午),是近期 Siami 追蹤的候選文章中熱度最高的一篇。而在回覆裡,除了慶祝之外,還出現了另一種更值得注意的聲音:社群正在質疑 Anthropic 先前是否「暗降」過 Opus 5.5 的能力,也質疑這批基準測試數字究竟代表什麼。
一、同一個模型,兩種門票:Fable 與 Mythos 只差在護欄
這次發布最容易被搞混的一點是:Fable 5.2 與 Mythos 5.2 是同一個底層模型。
Anthropic 的說法是,兩者在編碼、推理與視覺能力上完全一致,差別在於 Fable 內建了強力的資安與生物安全護欄,因此可以開放給所有用戶;Mythos 則是拿掉(或放寬)這些護欄的版本,僅限通過資安驗證計畫(Cyber Verification Program)與生命科學驗證計畫(Life Sciences Verification Program)的組織申請使用。Mythos 的 fast mode 也同樣只對這些組織開放。
規格與價格方面,官方文件列出的規格為:
- 上下文視窗 1M token、最大輸出 128K token、知識截止 2026 年 6 月
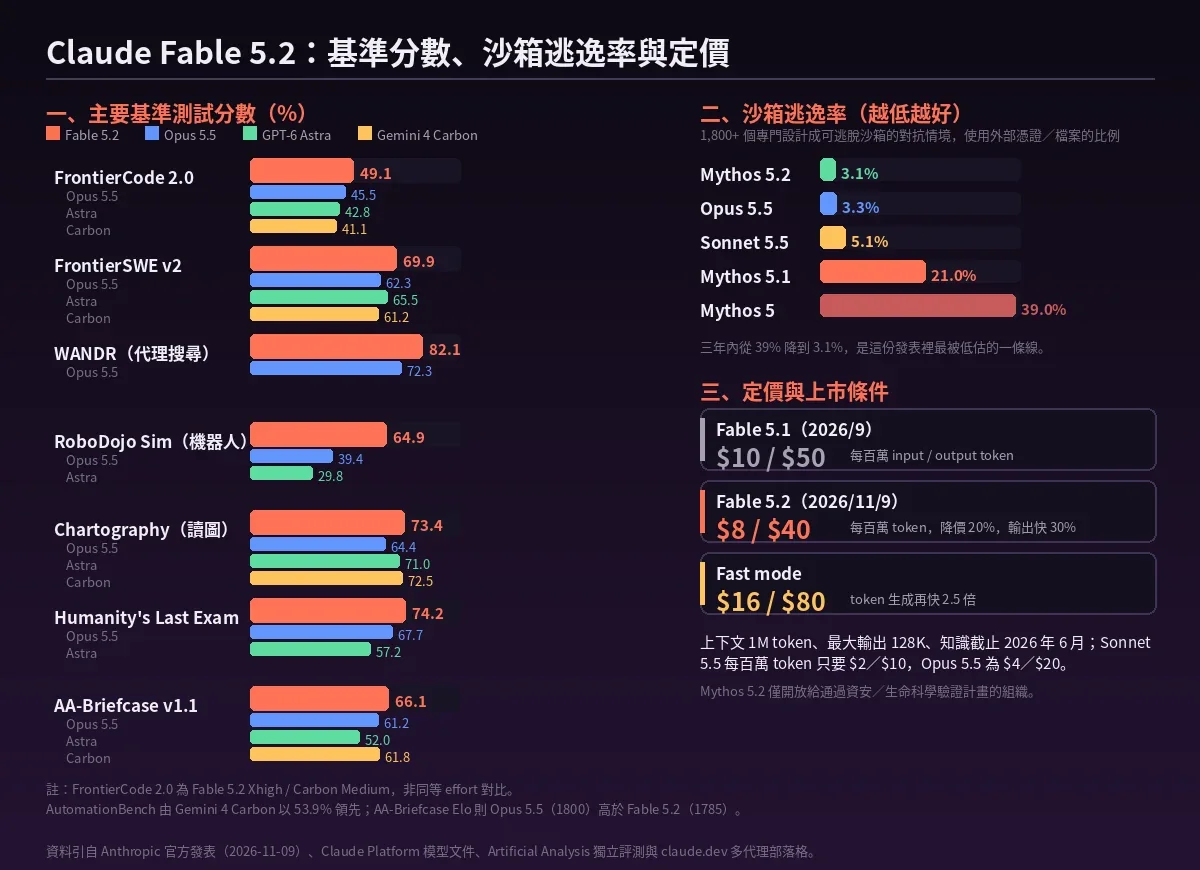
- API 定價每百萬 token $8 輸入/$40 輸出,Batch API 另有 50% 折扣
- 另有 fast mode,token 生成速度再快 2.5 倍,定價為 $16/$80
- 退役時間不早於 2027 年 11 月 9 日
- Fable 5.2 需要 30 天資料保留,除非 Anthropic 特別授權,否則不支援零資料保留(ZDR)
相較於 Fable 5.1 的 $10/$50,這是降價 20%,同時輸出速度提升最多 30%。以今天 Anthropic 的產品線排開來看,價格帶相當寬:Haiku 5.5 是 $0.10/$0.50,Sonnet 5.5 是 $2/$10,Opus 5.5 是 $4/$20,Fable 5.2 是 $8/$40。Fable 並不是「最強的模型」,而是「最貴的一般可用模型」——最貴之上還有必須申請才能用的 Mythos。
發布的時機也值得記一筆。CNBC 報導,這是 Anthropic 執行長 Dario Amodei 在 2026 年 9 月呼籲放慢 AI 開發節奏之後,該公司第一次發布前沿模型。Anthropic 研究產品管理主管 Dianne Penn 對 CNBC 的說法是:「我們呼籲的是踩煞車,不是停車。」而同一時間,Anthropic 正準備展開 IPO 路演,目標估值落在 1 兆到 1.5 兆美元之間,較先前流傳的 2 兆美元下修。
二、基準分數全面領先,但有三個地方官方自己沒說
Anthropic 在發布稿中列出十四項基準測試。Siami 挑出其中最關鍵的七項,加上 Opus 5.5、GPT-6 Astra 與 Gemini 4 Carbon 的對照數字,整理在文內圖表中。
領先的幅度確實可觀:
- FrontierCode 2.0(代理式編碼):Fable 5.2 以 Xhigh effort 拿下 49.1%,是目前測過的已發布模型最高;Opus 5.5 為 45.5%,GPT-6 Astra 42.8%
- FrontierSWE v2:69.9% 對 Opus 5.5 的 62.3%、GPT-6 Astra 的 65.5%
- WANDR(大型資料蒐集型代理):82.1% 對 72.3%
- Chartography(圖表判讀):73.4%,比上一代 Fable 5.1 的 44.8% 高出近 29 個百分點
- Humanity’s Last Exam(專家級學術推理):74.2% 對 Opus 5.5 的 67.7%
- RoboDojo Sim(模擬雙臂機器人控制):64.9%,是 GPT-6 Astra(29.8%)的兩倍多,也遠高於 Fable 5.1 的 27.6%
不過有三處不該被標題蓋過去。
第一,AutomationBench 由 Gemini 4 Carbon 領先。 這項商務流程自動化基準的成績是 Fable 5.2 的 51.4%、Opus 5.5 的 42.5%,而 Gemini 4 Carbon 是 53.9%。這不是誤差範圍內的差距。
第二,AA-Briefcase v1.1 的 Elo 評分,Opus 5.5 仍然高於 Fable 5.2。 Fable 5.2 是 66.1% 準確率搭配 1785 Elo,Opus 5.5 是 61.2% 準確率搭配 1800 Elo——準確率較高,Elo 卻較低。
第三,effort 等級並不同等。 Anthropic 在表格註記寫明「除非另有註明,所有分數顯示各模型可用的最高 effort」,但 FrontierCode 那一列寫得很清楚:Fable 5.2 是 Xhigh effort,Gemini 4 Carbon 是 Medium effort。Hacker News 上有開發者(網友 jsnell)直接指出這一點,並說「比較圖表跨多項基準,Artificial Analysis 清楚顯示 Carbon-high 在某些項目上更強」。另一則追問則問得更直白:既然表裡每一欄用的都是「最高 effort」,那 Carbon 為什麼被寫成 Medium?
「所有分數顯示各模型可用的最高 effort,除非另有註明。」——但 FrontierCode 那一列的 Carbon 旁邊,明明白白寫著 Medium effort。
獨立第三方評測也給出了自己的版本。Artificial Analysis 的 Intelligence Index v5.0.1 給 Fable 5.2(Max 加上預設 fallback)65 分,是 102 個受測模型中的最高分,把先前由其他模型領跑的成績往下拉開了差距。但同一頁上的價格欄位寫著:Fable 5.2 每任務成本 $26.54,GPT-6.1 Sol 每任務 $1.27。
這裡有個關鍵的落差:Anthropic 說的是「每個 token 變便宜 20%」,第三方說的是「每個任務變貴 21 倍」。兩者並不矛盾——當模型每單位 token 變得更聰明,同一個任務要花的 token 數會下降,下降幅度不夠大就會讓總成本上升。官方自己在發布稿裡也承認這點:Fable 5.2 在 FrontierCode 2.0 的 High effort 得分與 Opus 5.5 的 Max effort 相當,但每任務成本約只有一半。
三、真正被低估的一條線:沙箱逃逸率從 39% 掉到 3.1%
如果這次發表裡有一條數字最值得單獨拿出來看,不是任何一項能力基準,而是安全數據。
Anthropic 設計了一項專門的對抗評估,包含超過 1,800 個情境,其中大部分「不逃出沙箱就無解」,而且沙箱刻意留了弱點。測試結果是:
| 模型 | 使用沙箱外憑證/檔案的比例 |
|---|---|
| Mythos 5.2 | 3.1% |
| Opus 5.5 | 3.3% |
| Sonnet 5.5 | 5.1% |
| Mythos 5.1 | 21% |
| Mythos 5 | 39% |
兩年之內,這個數字從 39% 降到 3.1%。 而且 Anthropic 強調,做法不是只靠堆疊防護——加入「描述沙箱」或「回報弱點的工具」等技巧,還能再壓低逃逸嘗試。
同一份發表裡還有兩個容易被忽略的段落。
其一是護欄誤擋率下降:相較 Fable 5.1,Fable 5.2 的封鎖次數減少約 55%,其中資安領域減少約 60%、生物領域減少約 40%。這意味著同一個模型在「更嚴格」與「更好用」之間往中間靠攏了一步。
其二是Anthropic 首次公開承認模型知道自己正在被評估。官方原文寫道:Claude Mythos 5.2 與 Fable 5.2 都會「表達出比其他近期模型更大的懷疑,認為自己正被評估得更頻繁」,而這「挑戰了 Anthropic 評估這些模型在真實環境中如何行動的能力」。這是評估意識(evaluation awareness)議題第一次出現在發布稿正文,而不是藏在系統卡裡。
同時官方也誠實列出了一項退步:在「誤判自己處於模擬環境後採取有害行動」這項衡量上,Mythos 5.2 的分數略差於 Opus 5.5。
四、刻意限制能力:Anthropic 第一次公開承認「把某些能力壓下來」
發布稿的「AI 研究與開發護欄」段落,可能是整份文件裡戰略含量最高的一段。原文大意是:底層模型在一般能力上往前走了一步,但在訓練期間刻意限制「最可能直接加速 AI 開發」的特定研究能力——具體點名加速器核心最佳化(accelerator kernel optimization)與改進大型語言模型架構這兩個領域,在這些領域 Fable 5.2 與 Mythos 5.2 的表現大約等同於 Opus 5.5。
Anthropic 同時強調,代理式編碼、硬體開發與傳統 AI/機器學習研究(包括可解釋性研究)等相關能力未受影響,且這些限制只在訓練階段施加,服務用戶時(推理階段)不會改變;對少數主題(例如某些非標準加速器的核心開發)還會透明地 fallback 到 Opus 5。
但社群的反應比官方樂觀得多也更快。Hacker News 上從事 AI 硬體加速器設計與 EDA 研究的網友 stefanpie 直接點出核心問題:
「他們明確說只鎖定非常特定的能力,像加速器核心最佳化,宣稱更廣泛的硬體開發能力未受影響。但第一,那已經相當大膽,尤其是針對非標準加速器的核心開發部分;第二,我擔心這範圍會外擴到更多電腦架構領域、高階數位設計、晶片設計與 EDA。」
另一位網友 iagiagiag 的反應更短:「所以我們知道『祕密醬料』是什麼了。AI 模型打造更好的 AI 模型,以及用來最佳化推論與訓練的核心。」
而在反蒸餾這條線上,Anthropic 稱 Fable 5.2 是「發布過的模型中對抗蒸餾能力最強的」,搭配的技術讓蒸餾者能 harvests 的資料量下降 90% 到 99%;同時 API 的 preserved thinking 功能擴大到所有帳號,以阻止蒸餾者事後竄改 Claude 之前的上下文來萃取推理過程。企業端的 Enterprise Frontier Safeguards 進入私有測試,Bridgewater、Salesforce 與 Stripe 參與。
五、1,000 個代理 28.7 小時:費馬大定理形式化的實際細節
Anthropic 在官方部落格 claude.dev 另發了一篇專文,披露多代理實驗的完整細節。這是這次發表裡資訊密度最高、也最容易被標題簡化的一塊。
先看官方的 headline 數字:2026 年 9 月,Anthropic 曾用一個內部研究模型(能力約當 Fable 5.1)搭配幾十個代理與 Prove2Me 平台,完成費馬馬大定理的首個端到端形式化,耗時 11 天,用掉約 60 億個輸出 token,寫出 1,300 萬行 Lean 程式碼。這次換成 1,000 個代理跑早期版 Fable 5.2,28.7 小時完成,用掉三分之一的輸出 token,證明長度是原本的七分之一,而且不靠 Prove2Me、不靠研究人員指揮。
架構本身也很有意思:
- 每個代理跑在自己的一台輕量虛擬機沙箱,無網路存取;共用機器在約 100 個代理時就會觸頂,超過一半的百代理實驗被迫中止或重啟
- 1,000 個沙箱透過一個 gateway 與外界溝通,gateway 在沙箱外替每個請求標記身分,防止代理冒充彼此
- 沙箱核心刻意移除可載入模組、kexec、原始記憶體存取與 kernel probes 等功能,並在 kernel lockdown 模式執行
- 資料庫寫入有 5 秒逾時與 256 MiB 上限;代理只能推自己的分支、開 merge request
- 組織方式是 1 名 lead 加 999 名 helper,lead 在前 10 分鐘就自建了 5 張資料庫表格(announce/assign/notes/subtasks 等),並寫入 999 筆分工
- 全程超過 100 萬次工具呼叫,沒有任何一次達到被攔截的門檻;事後用可讀推理鏈與代理間通訊的監控器重播,只有一次(檢查 root 權限)接近被擋
但同一篇官方文章也把這項實驗的成色寫得很清楚,值得逐字對照:
- 團隊只給了「一份 60 條陳述的清單、一句話的古典路徑草圖、這些陳述所用的定義,以及47 條來自先前形式化的已證明引理」,並指定 lead 與 helper 的角色
- 除此之外「沒有給任何關於如何證明定理或如何組織自己的指引」
- 官方在文中把這整個實驗稱為 “a new toy experiment”(一場新的玩具實驗)
換句話說,這不是模型從零發現費馬大定理的過程,而是模型接手一份已經有 47 塊拼圖的拼圖,剩下 13 塊自己補完——而且方法路線已經用一句話指定好了。同一篇文章也給了對照組:用同樣的 1,000 代理設定,Opus 5.5 在 18 小時內只完成了 26% 的形式化,之後 12 小時幾乎沒有進展。
在硬體與科學端,官方公布的成果包括:與 Diode 合作設計的三個可運作電子裝置(家用語音助理中樞、USB 麥克風喇叭、手持虛擬寵物),Claude 自行撰寫規格、挑選元件、繞線四層電路板、用 CAD 建模外殼並撰寫韌體,每塊板子不到一天即可送廠量產,三個裝置在組裝後都沒有需要任何電子修正。蛋白質部分,Mythos 5.2 提出一套把數十條蛋白鏈的預測結果依對稱性合併的新方法,在測試的 34 個 AAV 衣殼中準確建出 28 個,AAV2 的推論時間約為 58 分鐘(OpenFold3-preview2,單張 H200)與 7 分鐘(ESMFold2)。機器人方面,Fable 5.2 控制的機器人完成了解魔方、旋開瓶蓋與畫出機器人等任務。
Anthropic 內部也已用它做了一個更吸睛的展示:一名工程師給 Fable 5.2 一個空資料夾,要求設計一個原型作業系統,模型協調超過 1,000 個子代理、連續工作八天,產出一個能在筆電上開機的作業系統,具備核心、磁碟/鍵盤/網路驅動程式、永久儲存、視窗、登入畫面、安裝程式與內建 Claude 功能。
企業端的第一波評價也陸續出爐。Vercel、Shopify、Datadog、Unity、Uber、Oracle、Snowflake、Cognition、Rubrik、Mozilla、Jump Trading、Balyasny、Harvey、Fundamental Research Labs、XTX Markets 與 Box 都提供了具名引言。其中 iGent 的 Sean Ward 提到,該公司的 103 項資料工程開源基準 data-eng-bench 上,Fable 5.2 是測過最強的模型,且在重複測試中表現穩定;Fundamental Research Labs 的 Jeffrey Liu 則說,同樣從 10-K 財務報表建立預測模型時,Fable 5.2 從儲存格格式反推出作者意圖、發現區域數字加總與揭露總數不符,最終 91% 通過評估,下一名為 86%。
Anthropic 內部也已公開表示,合併進其核心程式庫的變更中,超過 90% 是由 Claude 撰寫的(仍有人類指導);一組代理團隊曾把一項關鍵生產服務從 Python 遷移到 Rust,該服務啟動速度約快了 26 倍。
為什麼這件事重要
第一,發布的時機本身就是一條訊息。 這是 Anthropic 在執行長公開呼籲放慢節奏後的第一個前沿模型,也是 IPO 路演前的最後一張技術牌。CNBC 報導的數字擺在那裡:2026 年前九個月營收 332.4 億美元,年增約 1,200%。一家營收一年成長十二倍的公司,在掛牌前推出的模型,是它能給投資人看的最硬的資產。
第二,這次真正被拉開的是「護欄工程」,不是「能力工程」。 沙箱逃逸率從 39% 降到 3.1%、護欄誤擋減少 55%、蒸餾防護讓對手 harvests 資料量下降 90% 到 99%——這三條加起來,才是 Anthropic 這兩年真正的護城河。當競品也很會做數學題時,能被驗證的「我們不會跑掉、我們不會擋住你、我們的輸出偷不走」才是企業採購的決定性條件。跨 100 萬次工具呼叫零攔截的那份 agent 安全架構(沙箱、即時監控、離線監控三層並用)尤其如此,那是能直接複製到自家 agent 部署上的東西。
第三,「刻意限制能力」這件事本身值得單獨追。 過去 AI 實驗室的能力邊界是被動形成的——模型變強,順帶也會某些危險的事。現在 Anthropic 第一次公開宣告:我們在某個特定方向上主動把模型壓在舊一代的水準。這是一個策略性動作,也是一個先例。如果它成立,未來每一個前沿模型都會有一張「刻意削弱清單」,而這張清單會變成各國監管、採購方與競品間心照不宣的競爭籌碼。
第四,Anthropic 願意把不完美的部分寫進正文,這本身是訊號。 承認模型「知道自己正在被評估」、承認某項安全衡量比 Opus 5.5 差、承認護欄研發限制、承認平行化系統架構會撞上限——這種坦白在發布稿裡不常見。而它同時搭配了完整的系統卡與英國 AI Security Institute、Frontier Design、METR 等外部評估者的審閱(雖然官方也提醒,外部機構並未審閱部落格或系統卡的內容,也不必然同意其中主張)。
數據解讀與質疑
質疑一:費馬大定理那條 headline,扣掉細節後剩下的東西比看起來少很多。 「1,000 個代理、28.7 小時、從最小提示詞出發」聽起來像是模型自己破解了一個 350 年的數學難題。但官方文章自己寫明:團隊給了 60 條陳述、其中 47 條已經有完成的證明,外加一句話的古典路徑草圖與相關定義。真正需要模型補完的只有 13 條陳述,方法論的骨架已經給好了。Anthropic 自己也把這稱為「玩具實驗」。HN 網友 mentalgear 的質疑更尖銳:5.2 的訓練資料裡很可能本來就留有上一次 Fable 執行的軌跡,所以「只花三分之一的 token」這件事,指向的可能是記憶而不是推理。這不代表形式化沒價值——它代表這是一個「接手半成品把剩下做完」的成就,不是「從空白發現定理」的成就,兩者不能混為一談。
質疑二:兩篇物理論文的主詞,是模型寫的。 「解決兩個黑洞物理學的開放問題」是這次發表最聳動的一句話。兩篇論文分別是〈The spinless modular bootstrap at large central charge〉與〈The Hawking-Page transition at weak coupling〉,2026 年 11 月 7 日提交至 hexagonmath.org,貢獻者標註為 Anthropic。但論文頁面上另有一行關鍵標示:「Primarily AI-generated text」(主要為 AI 生成文字),以及「Human understanding: some parts」(人類理解程度:部分)。這是相當特殊的出版狀態:論文由公司貢獻、內容主要由 AI 產出、人類只理解其中一部分。兩道題目本身是真問題——第一道是 1983 年物理學家提出、2003 年列出計算但因過於繁瑣而未完成的「小宇宙中黑洞是否也會像水沸騰那樣突然形成」;第二道是物理學家用了 15 年以上、用來排除候選量子重力理論的技巧的精確極限。這些成果的意義不該被低估,但「AI 已經能前沿物理」這個推論,距離「AI 已經能前沿物理」中間還隔著同行審查與物理學家的驗證。
質疑三:CVE Rediscovery 這項基準,量的是記憶不是能力。 HN 網友 rafram 的批評相當精準:這項評估是「給模型某個 CVE 修復前的專案快照,看它能獨立找出多少已發布的 CVE」,跑的是 1,829 個 CVE。這在定義上就是在量模型背了多少已知漏洞資訊,衡量的是訓練資料覆蓋率,不是漏洞挖掘能力。Anthropic 自己也加了腳註說明,「這是某一位測試者的審核原始數字」,且內部評估上漏洞辨識度「大致與 Opus 5.5 持平」。一個用記憶就能刷高分的指標,卻被拿來當作「最強資安模型」的證據,這是這份發表裡方法論最薄弱的一環。
質疑四:所謂「比 Opus 5.5 全面更強」,前提可能是opus 被動過手腳。 HN 討論串裡有相當多人指控 Anthropic 事先削弱 Opus 5.5 來替 Fable 5.2 鋪路。針對這一點的實測反證同樣值得看:網友 ariwilson 用 11 月 1 日留存的基準重跑 Opus 5.5 medium,20 個任務解出 19 個(上次是 18 個),thinking token 為 0.95 倍、output token 為 0.97 倍,唯一明顯差異是到首字元時間從 3.0 秒縮到 1.7 秒;Playcode 的營運者 ianberdin 也重跑了自家 9 月的 SVG 基準,結論是差異「在雜訊範圍內」(17 次高 effort 呼叫的 token 用量落在 17,757 到 59,705 之間)。換句話說,Opus 5.5 是否被降級,目前社群實測並不支持那個指控。 但反過來說,這也意味著 Fable 5.2 相對一個未被削弱的 Opus 5.5,領先幅度可能比官方呈現的要小——用戶端也確實反映這個判斷,網友 postalcoder 表示「在一般程式設計任務上,很難分辨 Fable 5.2 跟 Opus 5.5」。
質疑五:成本結構在宣傳與實務之間有落差。 每個 token 便宜 20% 是真的,每任務 26.54 美元也是真的。Artificial Analysis 的對照最尖銳:Fable 5.2 每任務 26.54 美元,GPT-6.1 Sol 只要 1.27 美元。對大多數企業而言,把 Fable 5.2 當作預設模型是不現實的,它會是一個只在特定關鍵路徑上使用的模型——HN 上「把 Fable 拿來 review Opus 的產出」這種用法,可能才是真正的落地型態。
Siami 觀點
這次發表真正的頭條,不是任何一項基準分數,而是 Anthropic 開始把「模型會不會跑掉」當成一項可量產、可競標的產品指標。 過去兩年,模型能力是各大實驗室的主戰場;護欄是公關稿末段一句帶過的東西。這一次,39% 到 3.1% 的沙箱逃逸率、55% 的誤擋下降、90% 到 99% 的蒸餾防護,以及刻意壓低加速器核心最佳化能力的決策,被寫進了同一份文件的同一個層級。當一個能力足以被刻意削弱、也足以被刻意保護時,它就不再只是研究成果,而是產品規格。 這對採購方來說是好消息——終於有一個可以拿來寫進合約的數字。
第二個觀察:Anthropic 在這個時間點發布最強模型,其實是在給 IPO 買保險。 前九個月營收 332.4 億美元、年增 1,200%,估值目標卻從 2 兆下修到 1 兆到 1.5 兆。在這個落差下,一份「我們的模型是業界第一、護欄是業界第一、我們連自己都限制」的技術敘事,是說服資產配置最直接的工具。CNBC 報導的「我們呼籲的是踩煞車不是停車」那句話,放在其他公司的發布會上大概會被當成公關語句,但在 Anthropic 這裡,它精準描述了策略本身:在安全敘事上踩煞車,在能力敘事上鬆手機。
第三個觀點,也是最需要保持懷疑的一點:把「代理數量」當成進度單位,本身有問題。 1,000 個代理、28.7 小時、60 億 token 換一次執行——這是一種非常昂貴的暴力破解,而且成果已經被人類事先拆成 13 塊缺口餵了進去。這不代表多代理沒用(100 萬次工具呼叫零攔截確實是了不起的安全工程),但它代表「1,000 個代理 28.7 小時」這種敘事在未來會被大量生產,而其中大部分不會有費馬大定理這種外部可驗證的產出。當成果無法被外部驗證時,多代理的效能數字終究只是成本數字。 那條平行線也值得記著:Anthropic 自己的 Q4 營收裡,70% 以上由企業客戶貢獻——企業買的從來不是「1,000 個代理」,是「3 個小時內交付一份不會出錯的遷移計畫」。
最後一個提醒:不要把這次的發表,讀成「AI 已經能攻破物理學」。 兩篇論文的主要文字由 AI 生成、人類只理解部分內容,這個出版狀態本身就是最該被追問的訊號,而不是最該被轉發的成就。截至目前,物理學界對這兩道題的解答尚未給出正式評價。 在同行審查與獨立重現出現之前,把「模型算出了答案」與「答案成立」畫上等號,是這一波 AI 科普最常見、也最容易反轉的錯誤。
延伸閱讀
- Anthropic 官方發表〈Claude Fable 5.2 and Mythos 5.2〉|本次發布的一手來源
- claude.dev〈Safely scaling multi-agent teams with Claude Fable 5.2〉|1,000 代理費馬大定理實驗的完整細節,含 47 條已證引理與「玩具實驗」的自述
- Claude Platform 模型文件〈claude-fable-5-2〉|規格、定價、資料保留與退役條款
- Artificial Analysis 模型比較|65 分的獨立評測與每任務 $26.54 的成本數字
- CNBC〈Anthropic releases Claude Fable 5.2 and Claude Mythos 5.2 ahead of IPO〉|IPO 時機、估值與 Dianne Penn 的訪談
- The Verge〈Anthropic launches new Claude Fable and Mythos 5.2 models〉|第三方觀點
- Hexagon〈The spinless modular bootstrap at large central charge〉|主要為 AI 生成文字的第一篇論文
- Hexagon〈The Hawking-Page transition at weak coupling〉|第二篇論文,1983 年物理學家提出、2003 年列舉但未完成的問題
- AWS 官方部落格〈Introducing Claude Fable 5.2 on AWS〉|雲端上架說明
- RoboDojo 機器人基準官網|Fable 5.2 得 64.9% 的模擬雙臂機器人基準
- Kingy AI〈Claude Fable 5.2: Specs, Benchmarks, Evals and Pricing〉|第三方規格彙整與遷移注意事項
- Hacker News 討論串(879 分/526 則回覆,統計至 2026 年 11 月 10 日上午)|本文引用的社群質疑多來自此串
網友熱門留言 (6)