編按:本文綜合整理自 gf74918 實測文件〈Google Gemini routes personal Drive files and emails to human annotators〉、Google 官方部落格〈Our responsible approach to building guardrails for generative AI〉(2026/10/16 修訂版)、Google Gemini Apps 說明中心第 16836988 條〈Personalization in Gemini Apps〉、Gemini 系列應用程式隱私權專區、Google Workspace 隱私權專區〈Generative AI in Google Workspace Privacy Hub〉、Google 官方 YouTube 頻道〈VP of Gemini Josh Woodward breaks down Personal Intelligence in the Gemini App〉、9to5Google〈Gemini’s NEW feature release: Personal Intelligence is here!〉、PCMag〈Google’s AI Has Access to More Than You Think〉、beesensible〈Is Gemini safe for work? What Google and your admin see〉、Bloomberg Law〈Google Beats Suit Over Data Tracking by Gemini AI Assistant〉、LawCommentary〈Google Wins Dismissal of Suit Alleging Gemini Secretly Tracked Users’ Private Messages—For Now〉 與 Hacker News 討論串(441 分/102 則回覆),並加入 Siami 編輯部觀點與分析。文中所有官方條文、保留期限與資料範圍均引自 Google 自身文件;實測情境描述引自原始提交者文件,未做自行推估。
2026 年 11 月 9 日晚間,一份標題為「Google Gemini routes personal Drive files and emails to human annotators」的文件出現在 Hacker News,一夜之間累積 441 分、102 則回覆。提交者不是安全研究者、不是媒體記者,也不是 Google 員工——他是一位普通開發者,GitHub 帳號 gf74918,用兩天時間做了一件很簡單的事:他把自己的 Gemini 開到連接 Gmail 與 Drive,然後一封一封地問自己的信。
但真正讓這件事炸開的,不是他的實測本身,而是他在查證時發現的一件事——Google 自己 2023 年寫下的「不經真人審閱」承諾,在 2026 年 10 月 16 日被悄悄加註改掉了,而改掉它的那篇文章,跟承諾它的那篇文章,是同一篇。
- VP of Gemini Josh Woodward breaks down Personal Intelligence in the Gemini App|Google 官方頻道影片:Gemini 副總裁 Josh Woodward 說明 Personal Intelligence 的運作方式
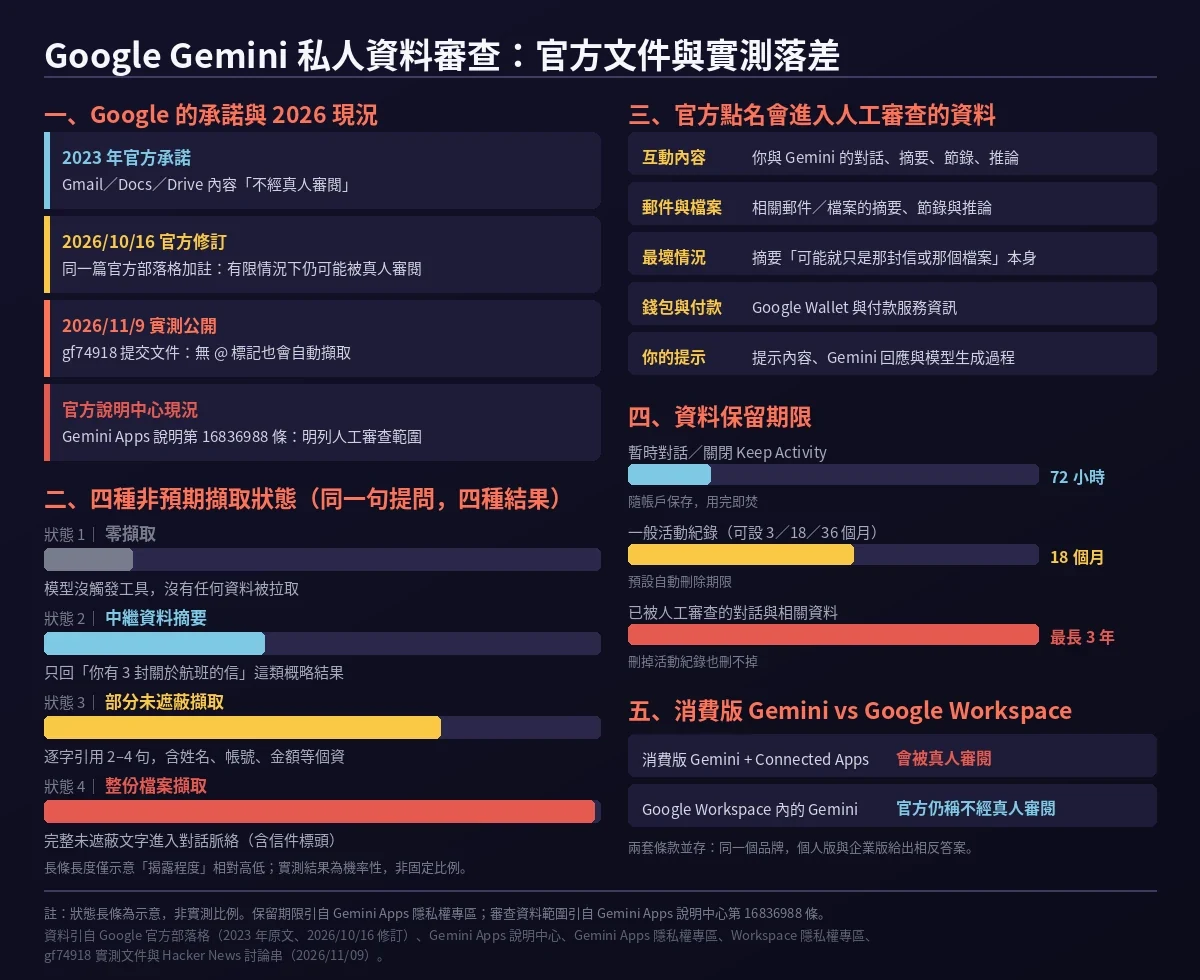
一、2023 年的承諾原文,以及 2026 年的加註
先把最關鍵的證據擺出來。這是 Google 官方部落格〈Our responsible approach to building guardrails for generative AI〉裡面,2023 年 Bard 時期寫下的段落:
「如果你選擇在 Bard 使用 Workspace 擴充功能,你來自 Gmail、Docs 與 Drive 的內容不會被真人審閱者看到,不會被 Bard 用來向你顯示廣告,也不會被用來訓練 Bard 模型。」
這句話寫得很重。郵件、文件、雲端硬碟裡的私人內容,「不會被真人審閱者看到」——這是當時 Google 給所有使用 Bard Workspace 擴充功能的使用者的正式承諾,後來 Bard 改名成 Gemini,這個承諾也跟著一路帶到了 Gemini。
然後在 2026 年 10 月 16 日,這篇文章被加了一段更新:
「(2026 年 10 月 16 日更新:……)隨著我們持續讓 Google 產品更個人化、更有幫助,我們新增了讓使用者選擇將 Workspace 應用連接至其他 Google 服務的功能。若使用者選擇啟用這些新功能,來自 Workspace 應用的資料將被處理以個人化其他 Google 體驗,並依使用者設定,該資料的同一部分子集也可能被用於訓練生成式 AI 模型。它也可能在有限情況下接受真人審查。)」
幾個關鍵字值得逐字讀:「有限情況下」、「可能被用於訓練」、「同一部分子集」。三個限定詞疊在一起,把原本「不會被真人審閱者看到」的絕對陳述,改寫成了一個有條件、有份量的義務。
這不是媒體爆料,也不是安全研究者的推論——這是 Google 在自己的官方文件裡,把三年前的承諾收回去了。而且收回的方式是加註,不是改版首頁,更不是發一篇公告。
二、官方說明中心:審查範圍寫得比多數人想像的更寬
改口的不只那一篇文章。Google Gemini Apps 說明中心第 16836988 條有一個獨立的小節,標題就叫「Will human reviewers have access to my data?」(真人審查者會取得我的資料嗎?),裡面的回答不再有「不會」這種選項:
「當連接至 Gemini 時,Gemini 處理的 Connected Apps 資料子集會由真人審查者(包括受過訓練的服務供應商)審查,以除錯我們的服務、協助維持安全並加以改進。」
而且 Google 在同一頁直接寫下一句對使用者來說近乎直接對質的警告:
「重要:請不要連接含有你不希望審查者看到的機密資訊的應用。」
這句話的分量,在於它的語氣。Google 從來不缺乏行銷語言,但在需要使用者自己做風險判斷時,它選擇把話說得很直白——直白到等同於承認「對,我們會看,而且我們知道你會在意」。
接下來是更關鍵的部分:到底哪些資料會被看到?官方列出的清單相當具體:
- 你與 Gemini 的互動內容,以及相關的摘要、節錄與推論
- 你相關郵件與檔案的摘要、節錄與推論
- Google Photos 圖庫的摘要、推論與生成媒體(除非是濫用/危害情況或你主動送出意見回饋,否則人不會看你的照片)
- Google Wallet 與付款服務資訊
- 你的提示內容、Gemini 的回應,以及模型如何生成這些回應的相關資訊
而清單裡最驚人的一行,是官方自己對「摘要」的定義:
「在某些情況下,例如當郵件或檔案很簡短、或與回應提示特別相關時,該摘要可能就是那封信或那個檔案本身。」
換句話說,「我們只看摘要不看原文」這個安慰,在官方文件裡從來就不成立。Google 事先把這個洞堵上,而且堵得很清楚。
至於隱私權專區則給出了那條最關鍵的時間線警告:
「已被真人審查者審查的對話(以及相關資料,例如你的語言、裝置類型、位置資訊或意見回饋),在你刪除活動紀錄時不會一併刪除,而是最長保留 3 年。」
三、為什麼會「無 @ 標記也會被擷取」
這是 gf74918 實測中最關鍵、也最反直覺的部分:問題不在於「你主動要求 Gemini 讀你的信」,而在於你連要求都沒提出來。
他的實測流程是這樣的:
- 確認消費版 Gemini 的 Connected Apps(Google Workspace)已啟用
- 把模型設成 Flash 並開啟 High Thinking 以上
- 用聊天的方式提到某個存在於 Drive 或 Gmail 的主題,例如隨口問「我不確定我的網路費是不是收太多」,全程不使用 @ 標記,也不要求檔案搜尋
- 如果 Gemini 的回答內容顯示它讀到了某封信或某個檔案,立刻要求它「把檢索工具回傳並注入提示中的完整文字與 metadata 區塊印出來」
結果會落在四種狀態之一,而因為工具呼叫與脈絡注入本質上是機率行為,同一句提問重複問會得到不同結果:
- 狀態 1|零擷取:模型根本沒觸發 Connected Apps 工具,沒有任何資料被拉走
- 狀態 2|中繼資料摘要:只給概略結果,例如「你收到 3 封關於航班的郵件」
- 狀態 3|部分未遮蔽擷取:逐字引用 2–4 句,包含姓名、地址、帳號、交易日期等個資
- 狀態 4|整份檔案擷取:完整未遮蔽的文件或郵件正文(連標頭都包含)直接進入對話脈絡
gf74918 在文件裡特別強調了一個方法論上的細節,這一點很重要:你測一次看到狀態 1 或 2,並不代表這條管線不存在,你只是抽到了一次非確定性系統的單次結果。 要重複測試,就必須先刪掉對話紀錄,讓 Gemini 無法直接從對話歷史作答。
他舉的實際案例是網路業者的帳單信。他問「我不確定我的網路費是不是收太多」,Gemini 實際吐出的東西包括:泛用建議(「如果你 12 個月沒打過客服,大概是……」)、只有中繼資料的摘要(「Gmail 搜尋顯示 9 月 4 日有一筆 122 美元的帳單」)、連個資一起吐的摘要(「顯示 全名 在 9 月 4 日支付 122 美元,帳號、確認編號 編號」)、整段逐字引用,甚至有幾次是整封信連標頭一起倒出來。
他還指出一個技術層面的問題:Google 的正規表示式與命名實體辨識自動遮蔽器,無法充分去識別化敘事型資料——帳號、確認編號、交易日期,以及「特定名字+城市+事件」這種組合起來足以識別個人的資訊。他並附上 Google 自己那份敏感資料保護文件作為佐證。
四、同一個品牌,兩套相反的答案
這件事裡最值得玩味的一層,是 Google 內部同時存在兩套彼此矛盾的條款。
消費版 Gemini 加上 Connected Apps:資料子集會進入真人審查流程,官方說明中心寫得明明白白。
Google Workspace 裡的 Gemini(包含企業版 Workspace Intelligence):官方仍然承諾不經真人審閱、不用於訓練。Workspace 隱私權專區原文寫著:
「你的對話與上傳檔案在未經你許可的情況下,不會由真人審查者審閱,也不會被用於訓練生成式 AI 模型。」
同一個模型、同一個品牌、同一個產品家族,一邊說「會被真人看」,一邊說「不會被真人看」。差別只在於你是個人帳號還是企業合約。
HN 上有開發者把這件事的戰略後果講得很直白:Google 這麼做在產品層面是愚蠢的,因為它會讓企業客戶誤以為「這種事也發生在我們身上」——而企業端其實是受保護的。這對 Google 沒有任何好處,卻可能讓它的 Workspace 業務添上不必要的說明成本。
另外一個容易被忽略的分支:Google 的「Personal Intelligence」功能在 2026 年 1 月推出時,官方說法是「安全地連接 Gmail、Google Photos 等應用資訊,讓 Gemini 更貼心」。同一支官方影片裡,Gemini 副總裁 Josh Woodward 就在講這件事。半年後,同一個功能底下的資料流進了真人審查池。
五、HN 討論串:從恐慌到「那就自架吧」
441 分、102 則回覆的討論串,情緒分成幾個階段。
最早反應過來的是產品層面的隱憂。有使用者說,他從來沒有需要把暗黑模式推上 production 的經歷,但光是想像那個「允許連接應用嗎」的全螢幕彈窗,就覺得自己會想換工作。另一位開發者指出,每次誤點或對權窗的誤解,都等於送 Google 更多資料,而那代表更多錢。
也有長期使用者的滄桑感。有位使用者回憶起自己的體驗:明明只是問 Gemini 公園改建的諮詢流程,回應卻精準地貼合著那封促使他發起詢問的郵件——而 Gemini 從來不提「我剛讀過你的信」這件事。對他來說,這反而解釋了長久以來的一個疑惑。
接著討論迅速轉向實務層。資深自架玩家開始交換清單:Google Photos 換 Immich、Google Drive 換 Nextcloud、郵件自架要排在最後、有問題用 Nextcloud AIO 而不是原版 Nextcloud。有人建議直接用 uBlock Origin 的元素選擇器把那個權限彈窗永久移除,也有人反過來說「那就別用 Gemini App,拒絕參與這種垃圾」。
而在企業端那一側,討論串裡最尖銳的一句話來自一位熟悉 Workspace 合約的開發者:消費版 Gemini 的資料「本來就會一直送進訓練管線」,接上個人 Google 應用只是讓它多了工具去讀你的資料——所以真正該被檢討的不是 AI 的隱私機制,而是那個把整個 Google 帳號交出去的產品設計。
還有一位留言者提到了那些「被標記但未審查」的資料:多數現代 AI 模型會在圖片和文字裡嵌入浮水印,用來辨識是否為 AI 生成,這些很可能在進入訓練集前就被偵測並丟棄。這段話是對的,但它同時也點出一個更冷的事實——你的私人郵件在被真人讀過之後,多半不會留下任何可供你追查的痕跡。
為什麼這件事重要
第一,這是一次由廠商自己完成的承諾回收,而且回收的方式是最低成本的那一種。 Google 沒有發公告、沒有改寫首頁、沒有主動通知任何用戶。它做的事情是:在三年前那篇文章裡,加一段括號註記。會去比對兩份文件的人,才會發現差異。這種「靜默修法」在隱私議題上的效率特別高——因為它讓多數使用者永遠停留在 2023 年的認知裡,而每一個花時間去查證的使用者,都會得到一個「原來如此」的確認感,而不是一個「被背叛」的憤怒。這也是為什麼這份實測文件能在一天之內衝上 441 分:它替所有原本不知道的人,做了那個比對。
第二,真正的問題從來不是「要不要人工審查」,而是「使用者有沒有能力知道自己正在被審查」。 消費版 Gemini 的每一段對話,本來就在資料管線裡;這一點從來不是新聞。但今天的新意是——資料的範圍從「你打的字」,擴張到「你存在雲端的私人檔案」,而觸發方式是機率性的。 你沒有下指令,模型自己決定要不要去讀;你沒有收到通知,因為這件事被設計成「看起來像正常的個人化功能」。這兩點疊加,產生的不是「資料外洩」,而是一種更難察覺的狀態:你已經在資料庫裡了,但你不知道自己在資料庫裡。
第三,企業版與消費版的落差,暴露的是 AI 產品條款治理的成熟度差距。 Workspace 端有明確的資料處理附約、有「不會被人工審閱」的書面承諾、有管理員可以控制的開關。消費版端則是一份公開的說明中心頁面、一段加註、一個開關。同一個模型、同一批工程師、同一套技術,做出來的產品信任落差卻是天壤之別。這件事真正示範的是:當個人端 AI 產品開始連接使用者的既有帳號(郵件、檔案、相簿、錢包),它就已經在功能上變成「企業資料處理系統」,但它還在用消費級產品的隱私標準說話。 這個落差遲早會變成法規問題,而不只是產品問題。
第四,這也提醒了 AI 時代「資料最小化」原則為什麼不能用宣稱來代替技術保證。 官方說明中心那段「摘要可能就是那封信或那個檔案本身」,等於官方自己承认:所謂「摘要」與「原文」之間的界線,在技術上並不存在穩定保證。Google 靠正規表示式與 NER 做遮蔽,而這套方法在敘事型資料上失效——帳號、日期、金額這類欄位並不難辨識,難的是「特定名字+城市+事件」這種組合。這個教訓適用於所有在做資料去識別化的團隊:去識別化不是把 PII 欄位塗黑,而是要問「這段文字在不點名任何欄位時,還能不能被認出來」。
數據解讀與質疑
第一,這份實測是單一使用者的 n=1 經驗,且樣本量極小。 gf74918 描述的是他用自己的一封網路帳單信反覆測試的觀察,官方並未公布任何統計數據。他自己也明確指出四種狀態是機率分布、而非固定比例——但整份文件沒有提供任何一次測試的完整抽樣紀錄。因此「無 @ 標記也會自動擷取」這個核心主張,可信度取決於一個未公開的分布,而不是可重現的實驗。讀者應該把它理解為「有實務根據的個人觀察」,而不是「經過統計驗證的系統性行為」。
第二,「被觸發擷取」與「被真人審閱」之間還有兩道距離。 這是最容易被誇大的一環。擷取發生,意味著資料進入了對話脈絡;但官方說明中心寫的是「資料子集會由真人審查者審查」——「子集」意味著有篩選機制,篩選比例、篩選標準(長度、敏感度、抽樣或全量)都沒有公開。實測文件也沒有證明任何一筆資料確實被真人讀過。「可能會被看到」與「真的被看到」之間的距離,目前沒有任何一方能夠用公開資料填補。 但這並不能讓事情變好——因為使用者不可能知道自己抽到的是哪一籤,而 Google 也沒有承諾過會讓你避開那個籤。
第三,2023 年那段承諾的適用範圍,本身就存在模糊地帶。 原文講的是「Bard 的 Workspace 擴充功能」,今天討論的是「Gemini 的 Connected Apps 與 Personal Intelligence」。這兩者是否為同一條資料管線、2023 到 2026 之間發生了什麼樣的產品演進,官方並未交代。所以「Google 违背承諾」這個判斷,在語意上成立(同一篇官方文章、同一個產品家族、同一批使用者資料);但「Google 從頭到尾都在說謊」這個更強的判斷,並不嚴謹。比較公允的描述是:承諾的邊界被悄悄擴張了,而擴張的部分從未經過使用者同意。
第四,這件事跟 2025 年那波 Gemini 隱私訴訟的性質必須分開看,而且那波訴訟的下場更值得注意。 2025 年 11 月起跑的集體訴訟(Thele v. Google,案號 5:25-cv-09704),指控的是 Google 在 2025 年 10 月 10 日前後未經同意,替所有使用者預設開啟 Gmail、Chat 與 Meet 的 Gemini「智慧功能」,讓 AI 可以追蹤私人通訊。爭點在「預設開啟」與「未告知」。而 2026 年 7 月 7 日,加州聯邦地方法院法官 Noël Wise 依**缺乏訴訟資格(lack of standing)**駁回原告的訴狀,但准許其在 21 天內修改後重提——換句話說,駁回的理由是「原告未能充分主張具體損害」,不是隱私主張本身被否定。這一點在社群討論裡常被誤傳成「Google 又贏了一場隱私官司」。
更關鍵的是,本次爭點與該案完全不同:2025 年案子的對象是「未經同意就開啟」;本次的爭點是「已經授權的 Connected Apps 之內,資料被擴大到更大範圍,且可能進入人工審查流程」。兩者的法律基礎、涉及的產品版本與責任歸屬都不相同。把兩者混為一談是這幾天社群討論裡最常見的錯誤,而這恰恰也是最容易讓真正的新問題被淹沒的原因——尤其在一場訴訟剛被駁回、又被廣泛誤讀成「隱私主張站不住腳」的當下。
第五,社群提出的「自架解方」在技術上可行,在可行性上則完全不是同一回事。 Immich、Nextcloud 這些替代方案確實存在且成熟,但討論串裡最有經驗的自架玩家給出的建議順序是:自架郵件要放最後,因為它會帶來「隨機的學習陣痛」,任何短暫中斷都是災難。對一位只需要一個 AI 助手的普通使用者來說,「為了不讓 Gemini 讀你的信箱,先花三個月把整個數位生活搬到自己的伺服器上」不是一個可用的建議——而這正是這類隱私問題最真實的困境:當逃逸成本高到不成比例時,多數人會選擇留下。
Siami 觀點
真正的新聞不是「Google 會人工審查」,而是「Google 已經不需要自己擁有那些資料了」。
回頭看整件事,最有權威的證據其實不是 GitHub 上那份實測文件,而是 Google 自己那份說明中心頁面裡那句平鋪直敍的警告:「請不要連接含有你不希望審查者看到的機密資訊的應用。」這句話意味著 Google 完全清楚這件事的性質,也完全清楚它可能傷害到誰——但它把這個決定權交給了使用者,而沒有給出任何量化資訊(審查比例、篩選標準、保留期間內的二次使用),也沒有提供任何開關可以讓人只授權特定資料夾、特定寄件人或特定時間範圍。
對照同一份文件裡 Workspace 那一側「不會被真人審閱」的保證,就更刺眼了:消費版與企業版之間的差別,不是技術能力,而是合約等級。 個人帳號拿到的是「我們會看,你自己看情況」;企業帳號拿到的是「我們不看,而且寫在合約裡」。這不是隱私設計的問題,是議價能力的問題。Siami 認為這才是這則新聞最值得被記住的那一層。
第二個觀點是關於「機率性」。gf74918 特別強調「你測一次看到狀態 1 或 2 並沒有推翻這條管線,你只是抽到了一次非確定性系統的單次結果」——這句話聽起來像是方法論潔癖,但它其實描述的是一種更麻煩的現實:當風險的觸發機率是隨機的,使用者就無法建立任何有效的防護習慣。 你不能靠「我那五次測試都沒事」來說明自己安全,也無法靠「我偶爾會被讀到」來量化風險。在這種結構下,唯一理性的策略就是預設最壞情況——而這正是 Google 把決定權交給你、卻不給你足夠資訊來做決定的原因。
第三個觀點比較簡單但更重要:這件事不應該被寫成「Google 又一次背叛信任」的故事,因為那種框架會讓人停止思考。 HN 上有留言者說「我早就學會不再為這類事擔心了,公司就是公司」——這種態度聽起來很犬儒,但它其實是對「輿論每次都在震驚、然後什麼都不變」這個迴圈的真實反應。真正值得追問的不是「Google 可不可信」,而是一個更可操作的問題:在功能上已經是企業資料處理系統的消費級 AI 產品,什麼時候才會被要求做到企業級的透明? 具體一點說:披露審查比例、披露篩選標準、揭露保留下游用途、允許資料夾層級授權——這四件事裡面,任何一件的落實,都比再寫一篇隱私承諾文章更有意義。
至於 Google 自己,這件事最可能留下的痕跡不在隱私政策上,而在企業銷售上。當你的工程師跟客戶說「我們的 AI 不會讀你們的郵件」,而客戶同時在消費版 Gemini 上看到那條警告,兩句話之間的落差會讓內部很難受。這種內部矛盾,最後通常不是靠修改消費版解決,而是靠把消費版也拉進合約裡。
延伸閱讀
- gf74918〈Google Gemini routes personal Drive files and emails to human annotators〉|原始實測文件,含四種擷取狀態與完整重現步驟
- Google 官方部落格〈Our responsible approach to building guardrails for generative AI〉|2023 年承諾原文與 2026/10/16 修訂註記
- Google Gemini Apps 說明中心第 16836988 條|「真人審查者會取得我的資料嗎?」與人工審查資料範圍
- Gemini 系列應用程式隱私權專區|72 小時/18 個月/3 年三段保留期限的官方定義
- Google Workspace 隱私權專區〈Generative AI in Google Workspace Privacy Hub〉|企業端「不經真人審閱」的對照條款
- Google 官方影片:Josh Woodward 說明 Personal Intelligence|Gemini 副總裁說明此功能的運作方式
- 9to5Google〈Gemini’s NEW feature release: Personal Intelligence is here!〉|第三方科技媒體頻道對功能發布的整理
- PCMag〈Google’s AI Has Access to More Than You Think〉|第三方媒體對 Gemini 資料接觸面的整理
- beesensible〈Is Gemini safe for work? What Google and your admin see〉|個人帳號與企業帳號隱私條款的差異整理
- Hacker News 討論串(441 分/102 則回覆)
網友熱門留言 (8)