2026 年 11 月 9 日美西時間上午,Meta Superintelligence Labs 官方部落格刊出一篇四分鐘的短文,標題是「我們最小、最有效率的模型:Muse Ember」。如果只看標題,很容易把它當成又一次「Meta 又發模型」的例行公告。但這次真正值得看的不是模型本身,而是官方主動把成本寫進標題裡的做法——同一篇公告裡,Meta 直接拿每個任務的美元成本跟 Claude Haiku 5.5、GPT-6 Luna 對標。
Artificial Analysis 的獨立評測給出的數字是:Muse Ember 在 Intelligence Index v5.0.1 上拿下 36 分,與 Claude Haiku 5.5(max)並列,但每個任務的平均成本只有 0.14 美元,約是 Haiku 的三分之一。而官方在同一份評測報告裡也點名,Muse Ember 的 36 分是在 Artificial Analysis 同樣的基準上取得的。
這是 Meta 第一次把「便宜」本身當成主要賣點來打,而不是拿著新模型去比擬頂級能力。
一、Muse 家族的分工:Ember 是那把每天重複劈柴的刀
Meta 在公告裡把 Muse 家族的定位講得很清楚。Muse Wonder 處理最難的問題,Muse Spark 負責編碼與 agent 流程,而 Muse Ember 專門負責「agent 每天重複執行的工作」——工具呼叫、編碼子任務、路由、資訊抽取與長文件解析。
「Muse Wonder 負責規劃,Muse Ember 負責處理量。」
這句話是整篇公告的策略核心。它意味著 Ember 從來不是要取代頂級模型,而是要在代理工作流裡當那個被呼叫上萬次、成本必須接近零的底層執行單元。
「agents can read screenshots, charts, and scanned documents, or work from voice memos, meeting recordings, and video without a separate model.」
Ember 原生處理文字、圖片、音訊與影片,不需要為了讀截圖或會議錄音另外接一個模型。上下文視窗 100 萬 token,單次最多可輸出 51.2 萬 token——一整份程式碼庫或文件集可以在一次呼叫裡放進去。
Ember 是 Meta 第四款 Muse 家族模型:4 月的中量級 Spark、8 月 Spark 的開放權重雙胞胎 Glimmer、10 月的前沿 Wonder,然後是 11 月 9 日的 Ember。Meta 也特別說明,Ember 是第一個「用 Muse Wonder Full 訓練出來」的模型——先有最強的老師,再往下蒸出最便宜的學生。
二、定價才是主戲:每任務 0.14 美元
官方公布的價格是每百萬 token 輸入 0.10 美元、快取輸入 0.004 美元、輸出 0.50 美元。超過 20 萬 token 的長輸入則漲到輸入 0.30、輸出 1.50 美元。
幾個關鍵比對(全部來自 Artificial Analysis 實測):
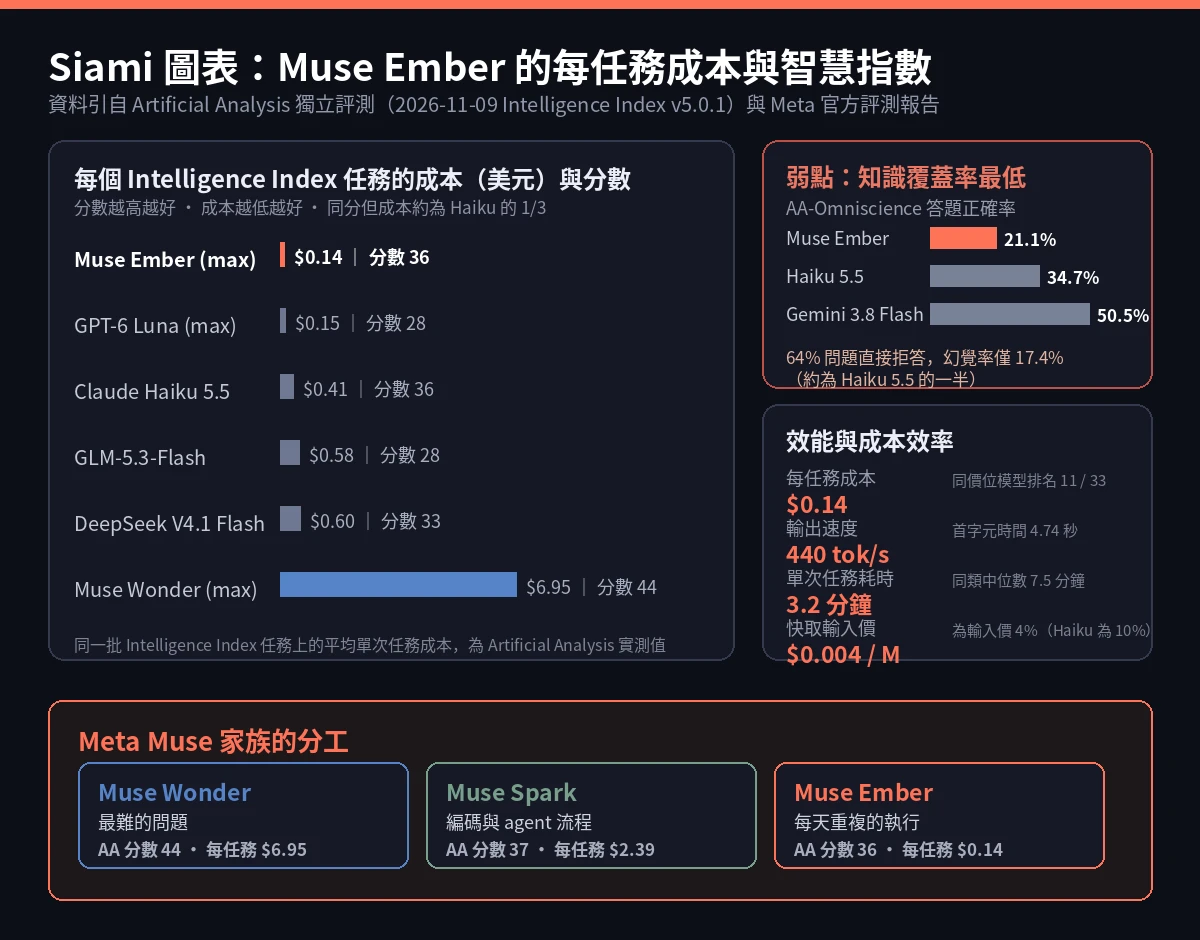
- Muse Ember(max):36 分,每任務 0.14 美元
- Claude Haiku 5.5(max):36 分,每任務 0.41 美元
- GPT-6 Luna(max):28 分,每任務 0.15 美元
- Muse Wonder(max):44 分,每任務 6.95 美元
也就是說,Ember 與 Haiku 拿到相同分數,成本約為其三分之一;而比 Muse Wonder 少 8 分的成本,只有 Wonder 的五十分之一左右。xhigh 推理強度下更便宜:34 分、每任務 0.12 美元。
成本差距不只來自牌價。Artificial Analysis 指出兩件事:Ember 的快取輸入比 Haiku 與 Luna 便宜約 60%,而快取輸入正是代理型評測裡最大宗的成本;此外 Ember 產出的 output token 大約只有 Haiku(max)的三分之一。在代理工作流裡,token 用量比牌價更能決定帳單。
同族對照也很有意思。Muse Spark 1.3 的 Intelligence Index 是 37 分,每任務要 2.39 美元,牌價是輸入 1.25、輸出 4.25 美元。Ember 用幾乎相同的分數,價格只有它的十幾分之一——但輸出上限只有 51.2 萬 token,Spark 也沒有那麼高的上限。
三、跑分結構:代理與編碼是強項,知識是硬傷
Meta 官方表格裡 Muse Ember(max)的成績如下,同時列出 Haiku 5.5(max)與 GPT-6 Luna(max):
- AutomationBench-AA(模擬 SaaS 應用內的商業流程任務):37.8 | 13.9 | 20.2
- Agents’ Last Exam(Linux 虛擬機上的端到端專業任務):61.6 | 57.0 | 57.1
- Personal Superintelligence Index(Meta 內部八項綜合指標):46.8 | 36.1 | 37.0
- Terminal-Bench 4.0:40.9% | 39.2% | 16.4%
- Coding Agent Index-AA:46 | 37 | 31
- FrontierCode 2.0-AA:27.2% | 34.9% | 25.2%
- GDP.pdf-AA(長 PDF 專業工作):22.8% | 20.8% | 22.8%
- OSWorld 2.1(桌面電腦操作):69.5% | 68.9% | 50.5%
- PerceptionBench(視覺感知):80.6 | 78.6 | 62.8
代理與多模態兩條線幾乎全面領先,但知識這條線塌得很明顯。Artificial Analysis 的 AA-Omniscience 答題正確率只有 21.1%,是同智慧等级模型裡最低的——Haiku 5.5 是 34.7%,Gemini 3.8 Flash(high)是 50.5%。原因不在答錯,而在64% 的問題它直接拒答。
這帶來一個有趣的反效果:因為大量拒答,它的幻覺率只有 17.4%,大約是 Haiku 5.5 的一半。對需要模型「寧可說不知道也不要亂編」的場景來說,這反而是優點;但對需要知識覆蓋率的場景,21.1% 就是不及格。Artificial Analysis 的 AA-Briefcase 專案裡也同樣落後,Elo 1521 對 Haiku 的 1574。
四、它其實已經在線上:Crouton Alpha 的真身
有個插曲值得記在這裡。Hacker News 討論串裡有用戶 open-paren 指出,OpenRouter 上先前以「Crouton Alpha」名義出現的隱身模型,應該就是 Muse Ember 的早期版本——依據是上下文視窗大小、推理強度層級、最大輸出量、知識截止日與受限國家清單都完全一致。隨後 shlewis 貼出 OpenRouter 的說明確認:Crouton Alpha 確實是 Meta 的隱身模型,現已公開為 Muse Ember。
換句話說,Ember 在正式發表前,就已經以「Crouton Alpha」的名義在 OpenRouter 上被大量呼叫過了一段時間。這也解釋了為什麼官方文章要附一份完整的評測方法報告——一份把每個基準的任務來源、評分方式、拒答如何計分、哪些任務被排除都寫清楚的報告。
目前 Muse Ember 已上架 Meta Model API 與 Muse Code(模型名 muse-ember-1.0),支援 Responses API,並已上架 Google Cloud 與 Oracle Cloud,Vercel AI Gateway 也同步開放。
初期合作夥伴的評價集中在延遲與 token 效率。Cloudflare 的 CTO Dane Knecht 說,Ember 在他們的測試中完成每一道編碼任務的延遲最低,p95 達 2.2 秒,比領先的開放權重模型快 4 到 13 倍,output token 也少了 36% 到 48%。Oracle 的 SVP Konstantinos Papamiltiadis 則提到,Ember 在長尾情境下最多快 30%。
五、社群的冷水與熱水
Hacker News 這則討論串累積了 294 分、118 則回覆,是當天 AI 議題裡頗受關注的一篇。Simon Willison 用他的鵝 SVG 測試跑了六個推理強度層級,得到一個反直覺的結論:以往「思考越多、畫得越好」的相關性第一次被打斷——多給推理 token 並不會明顯產生更好的 SVG。討論串裡因此有多人認為 minimal 層級(只有 10 個推理 token)畫出來的最好看。
反對的聲音同樣清楚。djacksondev 的評論是這則討論裡最直接的怀疑:Muse 系列在 benchmark 卡片上看起來很前沿,拿到真實工作流裡卻不怎麼實用,他甚至延伸批評 Muse Agent 這項產品本身的模型品質仍明顯落後。
doodlesdev 則指出官方表格裡一個容易被忽略的細節:Muse Ember 最好的編碼成績其實不是跑在 Meta 自家的 agent harness 上,而是 mini-swe-agent——官方評測報告也寫明,Terminal-Bench 4.0 使用 mini-swe-agent 跑 Ember、用 Claude Code 跑 Haiku、用 Codex 跑 Luna,三者並非同樣條件。
system2 的評論帶著情緒但也點到一個價格事實:批次定價比 Haiku 還便宜兩倍。creativeSlumber 則直接說,在 OpenRouter 的美國 ZDR 供應商上,DeepSeek v4.1 flash 1017 還比 Muse Ember 更便宜——這是本次發布裡 Meta 沒有回應的部分。
最值得注意的是 ProblemExplorer 那則把 Vals 系列拆開算的評論:拿 GPT-6.1 Terra 對比,Finance Agent v2.1 是 63.83% 對 55.96%、每次測試 0.06 美元對 1.92 美元;Legal Research Bench 是 49.04% 對 25.96%、0.06 美元對 3.22 美元。但兩者的 Vals Index 總分幾乎一樣(60.48% 對 60.54%),Terra 在 Terminal-Bench 4.0 反而更高(49.49% 對 39.39%)。他的結論是:廣泛基準適合篩選,選型必須靠自建、貼近自己工作負載的評測。
- Meta Muse Ember: Tiny Cost, Big Test on Images, Excel and Circuits|第三方頻道 Fahd Mirza 對 Muse Ember 的實測影片(非 Meta 官方頻道),涵蓋圖片理解、Excel 操作與電路題等面向
為什麼這件事重要
真正會被改變的不是「哪個模型最強」,而是代理的經濟結構。
代理工作流的成本從來不是由最聰明的那一顆模型決定,而是由被呼叫上萬次的那一顆決定。在一次客服代理的處理過程裡,重型模型可能只負責建立規則,剩下的判斷要交給輕量模型跑上萬筆案例——這種架構下,模型每單價的差距會被呼叫次數直接乘上。
Ember 把每任務成本壓到 0.14 美元,等於讓「一個代理人每天處理上萬次子任務」這種過去不成立的經濟模型變成可能。這也是 Meta 這次最核心的訊息:前沿能力的價格必須低到可以出現在每一個產品裡,而不是只有最貴的那幾個。
而 64% 拒答這件事,是同一枚硬幣的另一面。一個會大量說「不知道」的小模型,適合做分流、抽取、路由這種需要判斷邊界的步驟——判斷「這個問題不該由我處理」本身就是價值。但它絕不適合單獨承擔需要世界知識的回答。Artificial Analysis 把這項差異講得很清楚:知識覆蓋率最低,幻覺率卻也只有一半。選型的人必須先知道自己要的是哪一個。
對開發者而言,還有一個容易被忽略的現實:這批模型把代理的單位成本壓到接近零之後,真正的瓶頸會從「模型會不會」轉成「流程設計得對不對」。成本不再是護城河,怎麼把工作切成 agent 適合的步驟才是。
數據解讀與質疑
第一,官方與第三方的 AutomationBench-AA 數字差了將近一倍。Meta 官方文章列的是 Muse Ember(max)37.8%、Haiku 5.5 13.9%、Luna 20.2%;但 Artificial Analysis 自己的文章寫的是 Muse Ember(max)68.1%,並稱與 Muse Wonder(max)持平。官方評測報告註明該項結果來源就是 Artificial Analysis,但兩份文件給出不同數字,合理的推測是基準版本或計算口徑在兩次發布之間更新過。在沒有澄清之前,這一項不適合拿來做結論。
第二,Terminal-Bench 4.0 的比較前提並不同等。官方報告寫得很坦白:Ember 的成績是 Artificial Analysis 用 mini-swe-agent 跑出來的,Haiku 用的是 Anthropic 自己公布的 Claude Code 結果,Luna 用的是 Codex 在官方排行榜上的結果。Artificial Analysis 自己重跑 Haiku 得到的是 32.8%,低於 Anthropic 自報的 39.2%。也就是說「Ember 40.9% 勝過 Haiku 39.2%」這個說法,其實是不同 harness 對不同模型的成績拼在同一張表上——這是 agent 時代 benchmark 難以避免的結構性問題,也是這類比較最需要被打上問號的地方。官方評測報告在每一項基準下都標註了 harness 差異,這點值得肯定。
第三,「三分之一成本」有前提條件。牌價是輸入 0.10、輸出 0.50 美元,與 Haiku 5.5 相同;成本差距主要來自快取輸入便宜 60%,以及 output token 用量只有三分之一。這代表差距是在「代理反覆讀取大量相同上下文」的工作型態下才成立。若是每次呼叫都是全新短輸入、沒有快取命中,成本比例會更接近牌價。
第四,降本不包含批次折扣。system2 在討論串裡指出 Haiku 的批次定價是牌價的一半,而 Ember 的公告裡沒有對應的批次價格。對真正跑到百萬次呼叫的生產環境而言,批次定價往往比牌價更關鍵。
第五,官方的成本數字混用了兩種口徑。Meta 官方圖表裡標註「Muse Ember costs are estimates at proposed pricing」,而 Artificial Analysis 用的是實際牌價測算。Meta 自己列出的 0.116 美元(33.9 分)與 0.136 美元(35.8 分)就與 AA 的 0.14 美元(36 分)略有差異。引用時需要標明來源,兩組數字不能混用。
最後,與中國模型的價位戰仍未結束。Artificial Analysis 的數據裡,DeepSeek V4.1 Flash 1017(max)33 分、每任務 0.60 美元,GLM-5.3-Flash 28 分、0.58 美元;Ember 領先的幅度沒有想像中大,而社群已指出在部分供應商管道上還能拿到更便宜的選項。Meta 這次的優勢是「同分便宜」而不是「碾壓」,這個位置隨時可能被更便宜的同類模型替換。
Siami 觀點
第一個值得拉出來的角度是:Meta 這次公開的其實是一份「代理成本地層」的設計圖,而不是一份模型發表。
從 Muse Wonder 到 Muse Ember 的這條線,透露的是 Meta 對未來 agent 產品形態的判斷:前端會有一顆很貴、很強的模型負責「想清楚」,後端會有一整片很便宜、很專注的模型負責「做很多次」。前者一個月可能呼叫幾十次,後者一天可能呼叫幾十萬次。這兩者之間的比例,才決定了一個 agent 產品到底是賺錢還是燒錢。
Meta 把 Ember 的成本做成發布主標題,而不是把 benchmark 做成主標題,說明他們已經很清楚地知道:2026 年下半年模型能力差距的縮小速度,快過了市場對能力的需求。當兩顆模型都是 36 分,差別就是那 0.27 美元乘上呼叫次數。這個乘法之後,能力排序會被成本排序取代。
第二個角度則有關那 64% 的拒答。這個數字看起來像缺陷,但把它放進代理架構裡看,意義完全不同。
一個什麼都敢答的小模型,是代理工作流裡最危險的元件——因為它會安靜地把錯誤結論寫進下游系統。而一個會明確說「這個我不處理」的模型,等於在流程裡自帶了一道分流閘門。Ember 的 17.4% 幻覺率(Haiku 的一半)正是這個設計的副產品。
所以真正該問的問題不是「Ember 的知識覆蓋率為什麼這麼低」,而是「在你的系統裡,哪些步驟需要知識覆蓋率、哪些步驟需要低幻覺率」。前者交給 Haiku 5.5,後者交給 Ember,這才是這次發布真正的用法。Meta 官方表格裡那個 Terminal-Bench 40.9% 勝 39.2% 的說法可以慢慢吵,但「難題用 Wonder、雜事用 Ember」這句話,已經是 2026 年代理架構的通行寫法了。
第三個角度留給那個被公開的隱身模型 Crouton Alpha。它的存在提醒了兩件事:第一,Meta 的發布流程裡,模型會先以隱身模型的身分在第三方平台上被真實流量測試一段時間,這是常態而不是意外;第二,當 OpenRouter 這類平台開始被拿來反推模型身分時,模型本身的隱藏性其實早就失效了——HN 社群靠著上下文視窗、推理層級、知識截止日這些 metadata 的指紋,就把 Crouton Alpha 和 Muse Ember 對上了。
真正值得注意的是 Meta 這次附上完整評測方法報告的動作。在一個模型發表普遍省略 harness 細節、把不同產品的成績拼成美觀表格的年代,願意把「拒答計零分、哪些任務被排除、每個模型跑在哪個 agent 裡」全部寫出來,是相對少見的誠實。報告裡甚至明說內部跑的對手模型結果是「盡力而為」:prompt、工具與執行環境未必對專有模型最佳化。這句話,等於主動承認自家表格裡對手的成績有下限——這份自曝,反而讓整份比較的可信度提高。
延伸閱讀
- Meta AI Research 官方部落格〈Introducing Our Smallest, Most Efficient Model: Muse Ember〉|一手來源,本次發布全文,含定價、上下文規格、合作夥伴評價與安全評估說明
- Meta 官方評測報告《Muse Ember Evaluation Methodology》PDF|官方完整評測方法說明,逐項交代每個基準的任務來源、harness 差異、拒答計分與排除項目
- Artificial Analysis〈Meta’s Muse Ember is the cheapest model scoring 36 on the Intelligence Index〉|第三方獨立評測,包含每任務成本、快取價差與知識弱點的完整分析
- Artificial Analysis 模型頁:Muse Ember (Max)|延遲、輸出速度、每任務耗時與同價位模型排名等效能數據
- TechCrunch〈Meta releases Muse Ember, a new lightweight model for agent execution〉|主流科技媒體視角的發布整理,含 Muse 家族四款模型的產品線脈絡
- OpenRouter 模型頁:Muse Ember|第三方模型供應商頁面,附 Crouton Alpha 隱身模型轉正的說明
- Meta Model API 官方文件總覽|接入方式、模型清單與 Responses API 說明
- Vercel AI Gateway:Muse Ember now available|平台端上架公告
- Artificial Analysis 官方 X 貼文|評測機構第一手公布
- Hacker News 討論串(294 分/118 則回覆)
網友熱門留言 (6)