編按:本文綜合整理自 Strands Agents 官方部落格〈Amazon saves millions by replacing Sonnet 4.6 with Strands Decider〉(2026-11-09,作者 Carr Onstott、Mehul Jaiswal 與 Strands Agents 團隊)、Strands Agents 官方部落格〈Introducing Strands Decider 2B〉(2026-10-01)、AWS Builder Center〈Benchmarking Strands Decider, LLM Classifiers and Bedrock Routing for Model Routing〉(2026-10-09,作者 Vivek Raja P S)、Marc Brooker 個人部落格〈Strands Decider: Why Not an Encoder?〉(2026-10-04)、AWS 官方部落格〈ICYMI: What landed for AI builders in September 2026〉、Hugging Face 模型權重頁 StrandsAgents/strands-decider-2B-hobson-v19、AWS 首席傳播長 Marc Brooker 的 X 貼文 與 Hacker News 討論串(297 分/102 則回覆),並加入 Siami 編輯部觀點與分析。文中所有成本、延遲與 token 數字均引自官方原文與第三方實測,未做自行推估;唯一例外是官方在單價換算中已明確標註為「列表價、未計入 Lambda」的部分,已於內文逐項標註。
2026 年 11 月 9 日,Strands Agents 官方部落格出現一篇寫得很節制的工程記錄,標題是〈Amazon saves millions by replacing Sonnet 4.6 with Strands Decider〉。署名的是 Amazon 工程師 Carr Onstott 與 Mehul Jaiswal,內容則來自他們每天都在維護的那套內部工單系統。
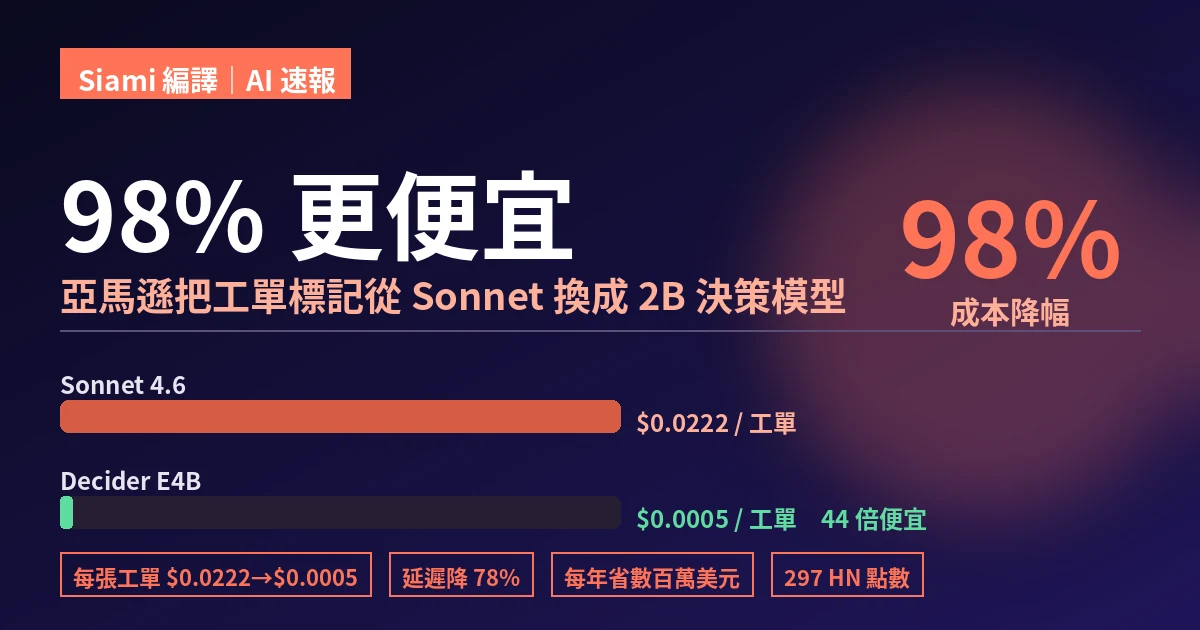
這件事的表面結論聽起來像一句廣告詞:「換模型省下 98% 成本」。但實際內容遠比這句話有價值的地方,在於它揭露了一個在整個 AI 產業還沒被好好處理的問題——當一個任務其實是封閉式的選擇題時,用會寫小說的語言模型去做,等於是每個月燒掉一筆沒有人會去追問的錢。
一、20 個標籤,其實是一道選擇題
亞馬遜內部這套工單系統的規模,用官方說法是「世界上最大的內部工單系統之一」。進到系統的工單種類非常雜:客戶客訴升級、容量請求、自動化告警、安全發現,或公司裡任何需要被歸到 20 個類別之一的東西。
原本的做法是讓 Claude Sonnet 4.6 處理。每一張工單都會附上一段很長的系統提示詞,讓模型輸出 JSON 並附帶推理過程,最後從那 20 個標籤裡挑一個出來。
團隊後來換上的東西叫 Strands Decider。這個模型的關鍵差異在於它不能生成任何文字。官方對這類模型的定義是「system one model」——給它一個狀態、一個問題跟一組選項,它回傳每個選項的機率以及一個信心分數,就結束了。用在工單標記上,狀態就是工單本身,選項集合就是那份 20 個標籤的目錄。
模型本身是開源的,2026 年 10 月 1 日由 Strands Labs 釋出。技術上它是拿預訓練的 Qwen3.5-2B 當骨架,把原本的 LM head 拆掉,換成一個 pointer head——換句話說,它保留了語言模型的閱讀能力,卻丟掉了「接下來該寫什麼字」的能力。這條線的設計出處,是 TypeSafe AI 在 2026 年 9 月底推出的 Jev 模型。
第一版用的是原始的 Strands Decider 2B,測試後換成官方稱為 E4B 的 Gemma 4 版本,效果明顯較好。運行環境是 SageMaker 上的 ml.g5.xlarge 實例,一台配一張 A10G(24 GB),模型實際佔用約 19 GiB,單次請求約 640 毫秒。
二、三段式開關:先雙軌跑,再決定要不要關掉 Sonnet
官方在這篇文章裡反覆提到同一件事——他們不想「翻一下開關就祈禱」。標記用的 Lambda 每次處理訊息時,都會從 AWS AppConfig 讀取一個三段式設定:
- BEDROCK:每一張工單都由 Sonnet 標記,Strands Decider 完全不被呼叫
- DUAL:兩個模型同時被呼叫,Sonnet 的結果會實際套用到工單上,並與 Decider 的結果逐一比對
- DECIDER:每一張工單都由 Strands Decider 標記,Bedrock 不再被呼叫
DUAL 模式是整個方案裡最值得學的部分。官方團隊的說法是,讓兩個模型跑真實流量、然後逐一判讀每一次分歧,比任何離線評測都更能告訴他們真相。而在 Siami 觀點之外,這也意味著回退成本極低——官方明說,回到舊路徑是一次 45 秒的設定變更。
整套流程除了工單 API 之外全是標準 AWS 服務:工單事件進 SQS 佇列、觸發 Lambda、Lambda 讀取工單資料後呼叫 SageMaker AI Endpoint 上的決策模型;AppConfig 負責開關,CloudWatch 承載日誌、指標與告警,基礎設施定義則用 CDK 管理,部署階段分為 Beta、Gamma 與 Prod 三段。
三、帳單:$0.0222 變成 $0.0005
官方的逐項對照數字如下,每張工單在兩條路徑上各跑一次:
| 項目 | Claude Sonnet 4.6 | Strands Decider E4B | 變化 |
|---|---|---|---|
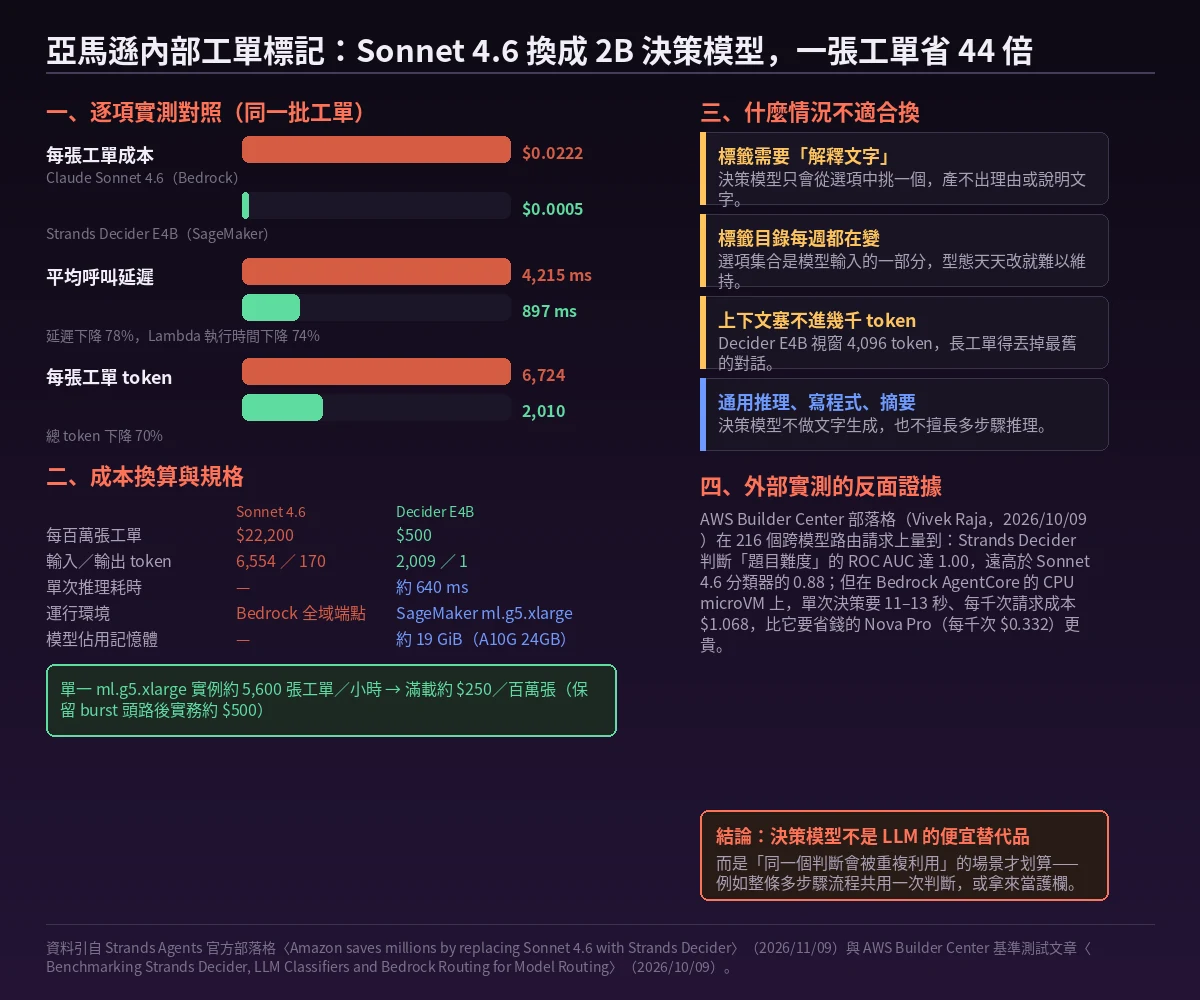
| 平均每次呼叫延遲 | 4,215 ms | 897 ms | ↓78% |
| 每張工單輸入 token | 6,554 | 2,009 | ↓69% |
| 每張工單輸出 token | 170 | 1 | ↓99% |
| 每張工單總 token | 6,724 | 2,010 | ↓70% |
| 每張工單成本 | $0.0222 | 約 $0.0005 | ↓98% |
| 每百萬張工單 | 約 $22,200 | 約 $500 | 44 倍差距 |
token 能夠大幅下降有兩個來源,而且都跟「輸出什麼」有關。第一個是結構性的:決策模型只吐出一個選項,而 Sonnet 要吐出一整段 JSON。第二個來自團隊自己的改寫——生產環境的標籤說明文字本身,就比 Strands Decider 的 4,096 token 視窗還長,所以他們把 20 條標籤全部改寫成一到兩句的準則,並以單一選擇題的選項形式送進去,另外加上一個「none」選項。
單價換算用的是美東 1 區的公開牌價:Sonnet 4.6 在 Bedrock 全域端點是每百萬輸入 token $3.00、輸出 $15.00;Decider E4B 則是每 instance-hour $1.408。以 640 毫秒單次請求計算,一台實例每小時可處理約 5,600 張工單,滿載約合每百萬張 $250;團隊保留了一段 burst 頭路,實務上落在每百萬張約 $500。
這裡有兩個必須講清楚的保留。第一,$500 這個數字已經是實務值而非理論值,因為亞馬遜沒有讓實例跑滿。第二,官方在文末主動註明:這些是公開列表價,而且沒有計入 Lambda 的費用——而 Lambda 因為執行時間縮短,也跟著變便宜了。所以「44 倍」是對 token 與推論成本而言的倍數,不是對整體總支出而言的倍數。Siami 對此的處理是照原樣揭露,不做延伸推估。
另外一組容易被忽略的數字:官方在關掉 Sonnet 用量的當天畫了 Lambda 執行時間的圖表,平均 Lambda 執行時間下降 74%。這個數字說明省下來的錢不只在模型 API 那一層。
四、JSON 鍵順序會改變答案
官方在這篇文章裡特別標出一個最讓人意外的觀察:
送出同樣的內容但把鍵的順序換掉,會讓輸出機率偏移最多 0.19。
這不是模型改進的細節,而是任何打算把決策模型放在 API 後面的人必須自己先驗一遍的東西。團隊的做法很直接:現在每一個請求都改用排序過的鍵送出。官方的建議是——「如果你把決策模型放在 API 後面提供服務,在比較兩次執行結果之前先檢查這件事。」
這條觀察在 Hacker News 討論串裡也立刻被挑出來,有人直呼這是「很基本的 LLM 知識」,也有人反問那麼為什麼還要特別寫出來。Siami 的看法偏向後者:一個 0.19 的機率偏移,在決策模型被拿來當護欄(agent 要不要繼續、要不要呼叫工具)時,是足以改變行為的量級。官方願意把這種細節寫出來,本身就是一種工程成熟度的訊號。
五、官方明講的三個不適用情境
Strands Agents 團隊在文章結尾直接列出了這套做法不適用的條件,這段大概是全文最實用的部分:
- 標籤需要「解釋文字」——決策模型只會從選項中挑一個,它產不出理由或說明文字
- 標籤目錄每週都在變——選項集合是模型輸入的一部分,型態天天改就難以維持
- 有效上下文塞不進幾千 token——Decider E4B 視窗是 4,096 token,長工單還得把最舊的對話丟掉才塞得下
而它之所以在亞馬遜這個案例成立,官方歸結成三個條件同時滿足:任務是從已知目錄中做的封閉選擇、量體夠大、舊路徑的延遲本來就有實質意義。
為什麼這件事重要
這是「LLM 過度使用」第一次被大型使用者用真實成本帳講清楚。
過去兩年,業界的敘事是模型越強越好、代理(agent)越通用越好。但每一次呼叫都要付 token 這件事,直到最近才開始被放進決策表格裡看。亞馬遜這次的案例提供了一個罕見的參照點:這不是一個新創公司的 toy 系統,而是世界最大規模的內部工單系統之一,每天幾十萬張工單,每一張都要被分類。
更重要的是,這個案例裡被替換掉的是 Claude Sonnet 4.6——當前市場上公認能力與性價比最平衡的模型之一。換掉它不是因為它不夠好,而是因為這個任務根本不需要它會的那些東西:多步驟推理、生成說明文字、處理模糊情境。一個不能生成文字的模型,在這裡反而表現得更好。
第二層意義在於「決策模型」這個類別被正式推到了主流。過去三年,機器學習的分工其實很健康——分類器處理分類、神經網路處理影像、語言模型處理語言。但 2022 年之後的行銷效果讓絕大多數消費者只看得見 LLM,傳統模型退到背景裡。Hacker News 討論串裡有網友用一個很精準的比喻回應:說這個領域「被壓縮成只有 LLM」,就像說內燃機的領域被壓縮成只有轎車——卡車、收割機、發電機還都在,只是躲在沒有人看得見的地方。
決策模型做的事情,本質就是把那些一直在背景裡的分類器重新端上桌,而且用一種開發者熟悉的介面。Strands Decider 2B 的權重、訓練資料與訓練腳本全部開放在 Hugging Face 上,亞馬遜工程師 Marc Brooker 還另外寫了一篇專門探討「為什麼不用 encoder 而要用 decoder」的技術分析,比較了 T5Gemma 上的 encoder-decoder 與 encoder-only 變體,結論是 encoder-only 的延遲中位數約 35 毫秒,明顯優於 v19 的 65 毫秒,但隨著輸入變長優勢就會被二次注意力成本吃掉。
數據解讀與質疑
第一,44 倍這個倍數要放在正確的位置上。 官方自己已經註明這是列表價且未計 Lambda,實務值又是因為保留 burst 頭路而從理論的每百萬張 $250 上升到 $500。把這些還原之後,98% 這個數字依然非常驚人,但它描述的是「token 與推論成本」這個局部,而不是亞馬遜的整體 IT 支出。把它寫成「亞馬遜省了 98% 的 AI 成本」是誤導。
第二,這個案例最耐人尋味的漏洞是:他們沒有用最便宜的那個選項。 Hacker News 討論串裡有人直接問,既然目標是把成本壓到最低,為什麼不直接換成 Claude Haiku?同樣是 Anthropic 的模型、同样是既有服務端點、換過去的成本近乎零,改動幅度大概是一行程式碼。這條質疑沒有被官方回答,但它指向一個真實的問題:這個案例證明的是「決策模型在特定任務上遠優於 LLM」,而不是「決策模型是最佳化模型路由的通解」。至於另一個可能的解讀——亞馬遜有足夠的內部基礎設施,自己訓練或微調一個專用分類器同樣可行——官方也沒有正面交代。
第三,「準確率不輸 Sonnet」這句話需要一個框架才能被正確解讀。 團隊的測試方式是:在測試集上比較,在另一批工單上確認 E4B 打贏過生產環境的 Sonnet。這是針對「把工單歸進 20 個類別」這個單一任務的比較,不是通用能力比較。Strands Decider 官方文件本身就寫明,決策模型在複雜問題上的表現顯著不如推理模型,也不適合寫程式、聊天機器人、文件摘要這些常見 LLM 任務——它放棄的就是這些能力。
第四,也是最需要被寫下來的一條:同一份 AWS 官方發表裡,就有另一組數字指向相反結論。 AWS Builder Center 在 2026 年 10 月 9 日刊出一篇基準測試,作者是 AWS Hero 與資深解決方案架構師 Vivek Raja P S。他用 216 個跨模型路由請求比較 Strands Decider、五種 LLM 分類器、Bedrock Intelligent Prompt Routing 與 Bedrock Advanced Prompt Optimization:
- 判斷「這個請求需要多步驟推理嗎」這件事,Strands Decider 的 ROC AUC 達 1.00,Claude Sonnet 4.6 分類器是 0.88,Haiku 4.5 是 0.78,Nova Micro 只有 0.60
- 但在 Bedrock AgentCore 的 CPU microVM 上跑,單次決策要 11 到 13 秒、每千次請求成本 $1.068
- 作為對照,他測試中的 Nova Pro 平均每次回答成本是 $0.00033,也就是決策本身比它想省下的答案還貴;Nova Pro 的每千次成本是 $0.332,遠低於 Decider 的 $1.068
這兩組數字並不矛盾,但拼在一起才是完整的畫面。亞馬遜的案例之所以成立,是因為它有專屬的 GPU 實例可以承接大量流量、把每次決策壓到 640 毫秒;同一個模型搬到 CPU microVM 上,故事就完全變樣。Raja 的結論很精準:決策模型是「請求某個屬性」時最可信的裁判,但它要在同一個判斷會被重複利用的地方才划得來——例如跨一整條多步驟流程共用一次判斷,或是拿來當護欄。
第五,Hacker News 討論串 297 分/102 則回覆的分佈,本身就是一則數據。 討論裡最尖銳的問題不是「這個技術好不好」,而是「為什麼不選更簡單的做法」——對應到決策模型在什麼條件下才划算、決策模型在 CPU 上慢到會反噬。換句話說,社群已經在用「什麼時候不該用」的框架檢視這項技術,這比單純的技術驚嘆成熟得多。
Siami 觀點
有兩個角度值得從這則案例裡拉出來。
第一個角度是**「模型選擇」這件事,正在從能力競賽轉成本質問題**。過去兩年,開發者面對模型時的問題是「哪個最聰明」;這篇文章展示的問題則是「這件事到底需不需要聰明」。亞馬遜的工單標記是一道 20 選項的選擇題,把語言模型放進去,本質上是讓一台能寫小說的機器去填選擇卡。這不是工程師懶得優化,而是長期被「模型越強越好」的敘事洗腦之後,終於有人認真算了一次帳。真正值得關注的訊號不是亞馬遜省了多少钱,而是同一天裡,社群已經開始討論「什麼情況下別這麼做」——這是產業成熟的第一個跡象。
第二個角度則更尖銳:這篇文章真正的價值,在於它把「拒絕使用 AI」變成了一件可以被量化的專業決定。 過去兩年,技術主管在會議上要嘛被迫承認用了 LLM、要嘛被迫承認沒用,兩邊都有點尷尬——因為「用 LLM」預設等於「負擔得起」。亞馬遜的做法提供了一種新的談話方式:先把任務拆解成「這需要多強的模型」,如果是封閉選擇題就用決策模型,如果不是就用推理模型,成本差 44 倍。這個拆解動作,比任何一份 AI 採用指南都更有實用價值。
而 Siami 最想提醒的是第三個角度:這是一個特定條件下的成功,不是一個可以被複製的範本。 亞馬遜有專屬的 GPU 實例可以承接每天幾十萬張工單、有內部工程團隊可以改寫 20 條標籤說明、有能力養一台 SageMaker 端點集群。一般公司沒有這些條件——在同一篇 AWS 官方基準測試裡,同一個決策模型在 CPU microVM 上要 11 到 13 秒,成本反而比它要省下的模型答案更高。看到「98%」這個數字就立刻照抄的人,很可能會得到完全相反的結果。 這篇文章值得學的不是「決策模型很便宜」,而是「先算清楚你的任務是選擇題還是生成題」這個方法本身。
延伸閱讀
- Strands Agents 官方部落格〈Amazon saves millions by replacing Sonnet 4.6 with Strands Decider〉|一手來源,本文主要依據,含完整成本表、三段式開關說明與 JSON 鍵順序警訊
- Strands Agents 官方部落格〈Introducing Strands Decider 2B〉|2026-10-01 決策模型發布文,說明「system one model」定義、Qwen3.5-2B 骨架換 pointer head 的架構,以及信心分數這項 LLM 推論 API 拿不到的能力
- AWS Builder Center〈Benchmarking Strands Decider, LLM Classifiers and Bedrock Routing for Model Routing〉|2026-10-09 官方第三方實測,本文「數據解讀與質疑」一節的反面證據來源,含 216 請求完整基準表與 CPU microVM 11 至 13 秒的量測
- Marc Brooker 部落格〈Strands Decider: Why Not an Encoder?〉|2026-10-04 技術分析,比較 encoder-only 與 decoder 架構在延遲與長度上的取捨
- AWS 官方部落格〈ICYMI: What landed for AI builders in September 2026〉|AWS 官方對 Strands Decider 2B 的定位說明
- Hugging Face:StrandsAgents/strands-decider-2B-hobson-v19|開源模型權重、訓練資料與訓練腳本
- Marc Brooker 的 X 貼文|AWS 首席傳播長整理的每張工單成本對照:$0.022 降到 $0.0005
- Hacker News 討論串(297 分/102 則回覆)|社群討論焦點集中在「為何不直接換 Haiku」、決策模型的適用邊界,以及 AI 產業繞了一圈回到分類器的循環史
網友熱門留言 (10)