編按:本文綜合整理自 Pietro Miotti 個人部落格〈My AI Agents Found an Unmapped Maya Site〉、TechRadar〈Google researcher discovers unmapped Maya site in Mexico using 48 AI agents〉、CellCog〈AI Agents Find Unmapped Maya Site: What Is Confirmed〉、Estrada-Belli 等人 2025 年論文〈New regional-scale Classic Maya population density estimates and settlement distribution models through airborne lidar scanning〉、Tulane 大學新聞稿 與 Hacker News 討論串,並加入 Siami 編輯部觀點與分析。文中所有數字與引述均引自上述一手來源。
「你可以就是去做事。我不是考古學家,所以我不知道這件事應該要這麼難。我只是挑了一個老問題,試了最直覺的方法,然後丟一堆算力進去。」 —— Pietro Miotti,Google Research(蘇黎世)
「憑空想像出一座未經記載的瑪雅城市」這種說法,在 2026 年之前聽起來像是 AI 時代的都市傳說。但把時間倒回 10 月 18 日,這件事的開端平淡得近乎無聊:一個人在秘魯旅途中無聊地跟聊天機器人閒聊,然後回到飯店就睡覺,隔天早上起床看到了一份讓他忍不住罵髒口的報告。
差別在於,這一次「讀完照片並判斷那是人造結構還是小土丘」的不是人,也不是專門訓練的遙測分類器,而是一群照著一份人寫好的指南、一張一張把圖片看完的 AI 代理。而他們的雇主——如果說得精確一點、他們的委託人——是一名自稱「不是考古學家」的 Google 研究員。
一、三天之內:從秘魯的一個念頭到 INAH 的回信
Miotti 在部落格裡把這段經歷寫成日誌,因為時間軸本身就是最精彩的部分。完整流程只有四天、跨越兩個國境、卻幾乎沒有花到什麼錢。
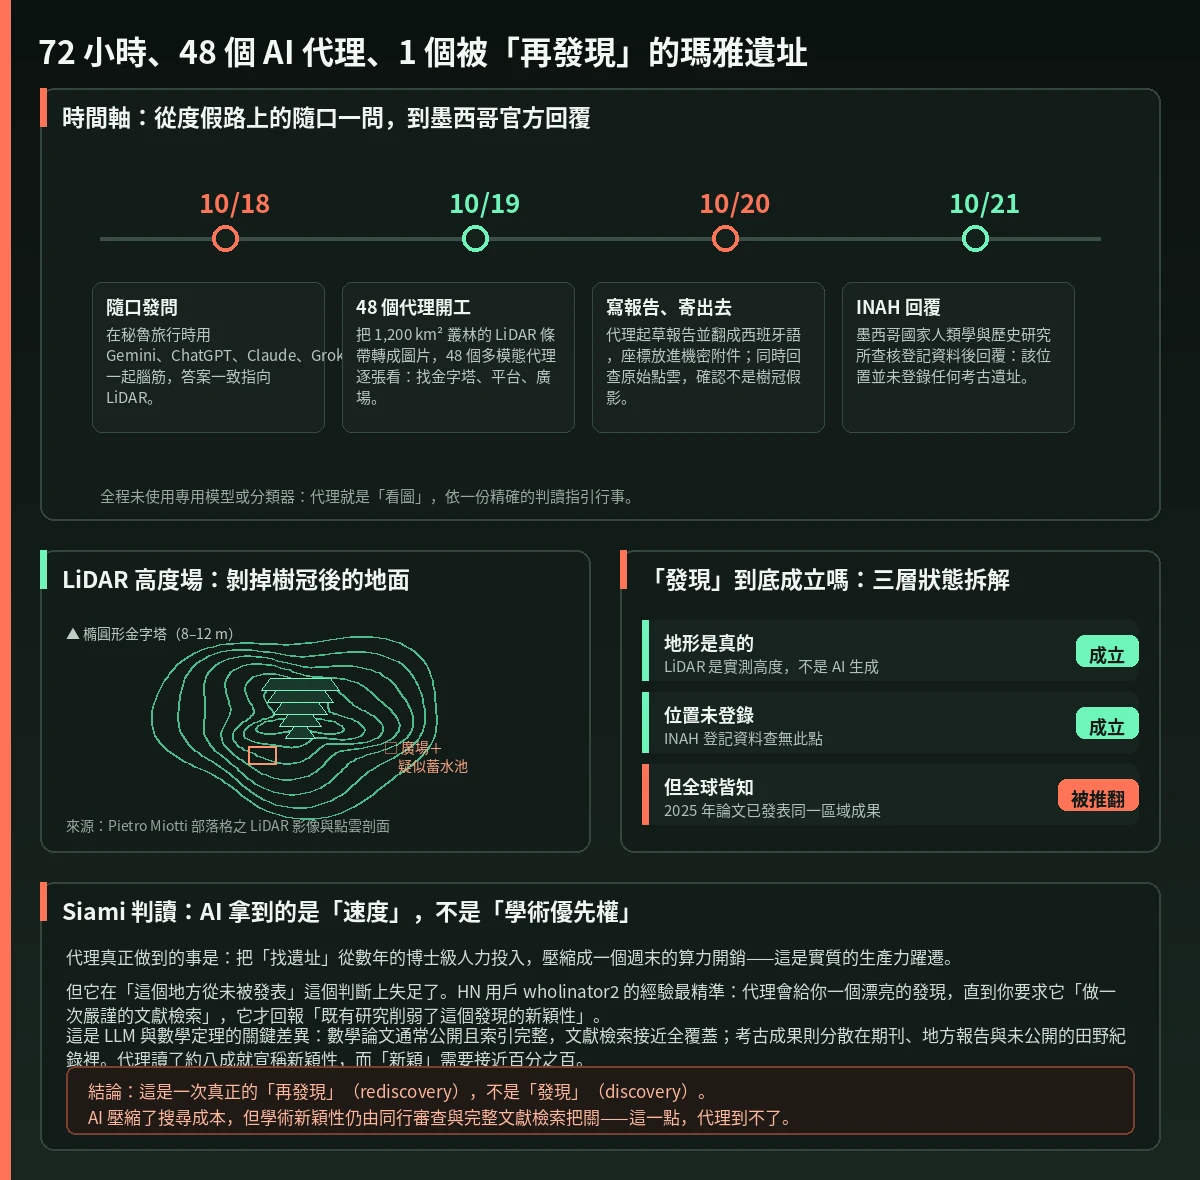
10 月 18 日,秘魯。 他在旅途中用 Gemini 聊到當地的歷史,講到 1911 年那位「發現」馬丘比丘的美國探險家 Hiram Bingham。Miotti 當時的想法是:Bingham 找到馬丘比丘,靠的是山谷下的農夫指路;換成今天有工具的人,會怎麼做?他把這個問題丟給 Gemini、ChatGPT、Claude 與 Grok,四個模型的答案完全一致:LiDAR。理由很直觀——從空中看,叢林裡的遺跡就是一堆樹;雷達則是把雷射脈衝打進樹冠縫隙,直接量測地面。秘魯的公開雷達覆蓋不足,委託專業survey又要許可、費用與流程,他於是轉念:那瑪雅地區呢?公開資料的覆蓋好得多。那天晚上他讓代理開始跑就去睡了。
10 月 19 日。 早上起床看報告,代理找出一大批「看起來像建築或房屋的規則形狀」。接著他追加了一個關鍵指令:「請檢查哪些聚落還沒被發現過,文獻跟檔案都查。」幾個小時後,代理回覆:一個主要聚落似乎沒有登錄過。
10 月 20 日。 代理同時完成了四件事:確認要聯絡誰(墨西哥國家考古與歷史研究院 INAH)、說明通報流程與信箱、把報告寫出來、翻譯成西班牙文。Miotti 特別註明自己不會西班牙文,那一段只能靠代理。他也讓代理回頭檢查原始點雲,確認那些形狀真的落在地面上,不是樹冠製造出來的假影——當地林冠高度 10 到 17 公尺,點雲切面裡棕色(地面)確實描出了廣場、金字塔與庭院的輪廓。報告寄出,確切座標寫在機密附件裡。
10 月 21 日。 INAH 回覆了。Miotti 貼出的原文,關鍵句被標黃:「在您報告所指的座標位置,未發現已登錄的考古遺址。」
整段敘事裡,最反直覺的部分是:代理做的不是「看圖找金字塔」而已,而是把整個科研流程的前段補齊了——從資料取得、文獻查核、報告撰寫、跨語言溝通到對外正式通報。這正是 HN 討論串引發最激烈分歧的地方。
二、1,200 平方公里的雷達條帶,48 個代理逐一檢視
方法本身比想像中簡單,也因此更值得懷疑。
- 資料:NASA 資料庫中的雷達條帶,覆蓋約 1,200 平方公里的叢林。
- 轉換:條帶被轉成圖片(另一位 HN 網友自行換算,約是 834 張 1200×1200 影像)。
- 執行:48 個代理逐張檢視,尋找金字塔、平台與廣場,同時排除天然山丘、天坑與道路。
- 沒有專用模型:Miotti 寫得很明確——「過程中沒有任何特殊模型或分類器:代理就是照著一份精確的指南,看著圖片而已。」
- 報告:48 個代理涵蓋的時間遠少於 48 × 72 小時;Miotti 每晚都是「交代完就去睡」,實際上多數時間是人睡著了、代理在跑。
這種做法的好處是門檻極低:公開資料、免費的通用模型、一份寫好的判讀指南,湊到一點運算量就成立。壞處同樣明顯,而且是結構性的:判讀標準完全取決於那份指南怎麼寫。指南裡若漏了某種遺址型態,代理就看不見;指南裡若對「天然山丘」的容錯太寬,就會大量誤報。代理並不知道自己在考古學上對什麼有把握、對什麼其實在猜——那個「考古遺址」的判斷,最後是從一張林下高度圖上讀出來的。
值得留意的是,這條路徑並非前所未有。Miotti 自己就引用了 NASA G-LiHT 儀器的運作方式(Cook 等人 2013)、環境研究用途雷達如何被考古學再利用(Golden 等人 2016)、2024 年考古學家如何用同樣方式在墨西哥找到一整座瑪雅城市(Auld-Thomas 等人 2024),以及 2025 年用雷達估算瑪雅低地人口的研究(Estrada-Belli 等人 2025)。真正新的部分不是「用雷達找遺址」,而是「讓代理來看」。
三、他們找到的到底是什麼:四種解讀,沒有一種被證實
依 Miotti 與代理的描述,那是一處位於懸崖邊緣、林木之下的台地。之所以值得注意,是因為它有「直邊與尖角」——自然造不出直線。放大後可見:
- 一處平整的廣場
- 一個至少 8 至 12 公尺高的橢圓形土堆(讀作金字塔)
- 與其相連的高台庭院
- 一個平底凹地(可能是蓄水池,也「可能只是一個洞」)
- 周圍三座平台(推測為房舍)
Miotti 自己給的年代判讀是:古典期(約公元 250 至 900 年)的一處小型瑪雅市政中心,本質上是地方菁英的「市中心」——廣場是聚會、儀式,也可能是市集;金字塔是神廟;高台庭院可能住了地方統治者;凹地是渡過旱季所需的雨水蓄水池。
他對這段判讀的標註相當誠實:「這部分是推測,來自與代理的一場漫長對話。」對那個凹地,他寫得更直白:「或者它就只是一個洞。」
但這裡要分清楚兩件事。第一,地形判讀與年代判讀是不同等級的命題。雷達高度圖上「有一塊 8 到 12 公尺高、橢圓形、邊緣筆直的土堆」是量測事實;「這是古典期的神廟」是詮釋。HN 討論串裡最尖銳的質疑正卡在這裡。第二,沒有人到過現場。零挖掘、零地面調查、零獨立第三方複驗。全部證據鏈都停在「雷達影像 → 代理判讀 → 主人轉述」這一層。
四、11 月 11 日的翻案:這是「再發現」,不是「發現」
故事在 11 月 11 日出現了轉折,而且轉折來自作者自己。
Miotti 在 X 上發文後,Bluesky 使用者 @indyfromspace 指出,這個遺址早就被圖出來了——它出現在 Estrada-Belli 等人 2025 年 10 月發表於《Journal of Archaeological Science: Reports》的〈New regional-scale Classic Maya population density estimates and settlement distribution models through airborne lidar scanning〉(DOI: 10.1016/j.jasrep.2025.105288)第 14 頁。那篇論文正是瑪雅低地史上最大規模的雷達普查之一,涵蓋約 95,000 平方公里的掃描,作者群包括 Francisco Estrada-Belli、Marcello A. Canuto、Ivan Šprajc 與 Juan Carlos Fernandez-Diaz;同一批研究把瑪雅低地的人口估計從舊數字上修到 950 萬至 1,600 萬之間。
Miotti 當晚就更新了自己的部落格,留言區也由本人回覆:代理漏掉了它,我也漏掉了,而 INAH 的登錄資料庫裡沒有它——所以這是一次「再發現」(rediscovery),不是「發現」(discovery)。他並補了一句:「故事的其他部分仍然成立,vibe-考古還有大量可以挖的東西。」
這段更新把整件事從「AI 找到了人類漏掉的東西」改寫成「AI 找到了一個學術界已經知道、但官方登記系統與作者自己的文獻檢索都沒接上的東西」。CellCog 的逐條查核把四個標題說法列成表格並指出落差:地形為真、位置未登錄,這兩項成立;但「人類從未知道」這項,被 2025 年的論文直接推翻。HN 網友 strix_varius 說得更直接:「既然我們都能在已發表的論文裡看到那座金字塔,這篇的標題『找到未繪製的瑪雅金字塔』似乎就不對了。」
值得注意的是,這個翻案之所以會發生,恰恰是因為代理「讀文獻」這一步做得不夠好,而不是因為地形判讀出了錯。代理確實照做了文獻檢索——只是搜尋策略沒能命中那篇區域尺度的普查論文。一個足以撐起「重大發現」敘事的遺址,與一份涵蓋 95,000 平方公里的既有普查之間的落差,只隔著一個關鍵詞的關係。
五、代理還做了什麼:報告、翻譯、通報流程,以及那封回信
把視角從「找到什麼」拉回「怎麼做到」,這件事的真正價值反而更清楚。
代理承擔的工作清單,是一個人在三天內不熟悉的領域裡最花時間的部分:
- 判讀:依指南逐一檢視影像,篩出候選結構
- 查核:搜尋文獻與檔案,判斷是否已登錄
- 驗證:回到原始點雲,確認形狀不是林冠假影
- 寫作:起草正式通報報告
- 翻譯:轉成西班牙文(Claude 建議的做法)
- 行政:查出該向哪個機構、哪個流程、用哪個信箱通報
其中「無人監督的一夜」是最關鍵的一環。Miotti 睡前丟出指令、醒來看結果,這個工作流本質上是把「非同步的專案執行」交給代理系統,而不是把代理當成對話框裡的工具。
但同一個特性也帶來了風險。HN 網友 pelzatessa 的追問很準:「我真心希望作者不是直接讓 AI 生成報告、然後就寄到那個信箱。」Miotti 自己在文章裡也寫了,他不會西班牙文,所以那一段只能相信代理——他沒有能力驗證報告內容的西班牙文是否得體、是否準確。而 INAH 收到的是一份由 AI 起草、非專業人士翻譯、來自境外個人的正式考古通報,這份通報本身有可能構成風險,因為它把一個未經實地查核的座標放進了官方流程。HN 網友 kspacewalk2 順著文章描述推敲,甚至用 Claude 定位出附近有大型牧場、距離道路約 250 公尺。
為什麼這件事重要
這樁事件值得認真對待,不是因為「AI 挖到古文明」聽起來很壯觀,而是因為它把 AI 代理在科研流程裡的位置,從「輔助寫程式」往外推了一大段,而且是用一種非常低成本、完全沒有專用模型的方式推出去的。
真正被驗證的技術能力只有一項:大規模影像判讀的吞吐量。48 個代理在沒有人類考古學家在旁的情況下,把 1,200 平方公里的雷達資料看完並篩出數十處候選,其中至少一處的判讀後來被學術界既有的普查論文證實是對的。這個命中率還算不錯——即使統計母體是「數十個候選中一個真的」。
但真正讓這套流程跑得通的,是代理做的那些「行政與流程」工作:查文獻、寫報告、翻譯、找到對口機構並走完通報流程。這些才是把一個個人興趣變成一個正式案例的關鍵。過去這些事情的成本,主要不在錢,而在「一個外行要在一個陌生國家、一個有嚴格准入規則的領域裡,問對問題、找對人、把話說對」。代理把這一段的啟動成本壓到近乎為零。
所以真正的教訓是:門檻降低之後,瓶頸就會整個搬到下游。找遺址變便宜了,接下來是考古學家有沒有時間、有沒有經費、有沒有法律授權去挖。HN 網友 TSiege 把這層講得很清楚:找出發現的難度,跟当初做出那份雷達測繪的難度是一樣的;如果一天之內冒出幾十上百個遺址,那會超出考古學界能挖掘、能保護的產能,而且盜掘者不會管地層。另一邊,HN 網友 hanoz 提醒這件事在英國早就在發生——他做的線上雷達地圖 lidarmap.uk,多年來已經帶出數十處未知遺址,包括羅馬別墅、堡壘與環形石陣,而英國到處都是這種東西。
換句話說,Miotti 做的不是特例,是把一件早就存在、只是先前成本太高而沒人做的工作,做成了日常。
數據解讀與質疑
先把數字攤開來看,哪些站得住、哪些站不住。
「72 小時」是什麼的 72 小時? 這是最容易被誤解的一項。原文寫的是「從旅途中的隨口一想,到墨西哥政府的正式回覆,不到 72 小時」——那是日曆上的三天,中間大部分時間是 Miotti 睡覺、等郵件往返。代理真正執行工作的時間遠少於此,更不用說 48 個代理 × 72 小時。HN 網友 agnosticmantis 把原文的日誌體逐段貼出來指出了同一點:標題與內文在時間量級上有落差。
「48 個代理」是什麼意思? 原文沒有說明代理的編排方式、用了哪個模型、彼此是否共享狀態。HN 網友 reedf1 直接問「為什麼是 48 個?一個代理若能平行化分析,是否等於只是原始的並行?」另有 sporkland 指出,這類代理群的效果究竟來自並行度、還是把同一個提示詞餵給多個不同溫度,公開資料裡完全沒有答案——而這恰恰決定了它能不能被複製。
「金字塔」這個詞有多確定? 雷達高度圖上的是一個 8 至 12 公尺高、橢圓形的規則土堆,讀作金字塔是合理推測;「古典期神廟」則是推測之上的推測。作者本人標註了這一點(Miotti 也用 Gemini 生成了公元 700 年該遺址想像圖,但那是他餵給模型的重建,不是考古重建)。同樣地,挖出遺址與判定年代是兩回事,而後者目前完全沒有證據。
「Google 研究員」是事實嗎? 這點需要分層看。Miotti 的部落格只寫「AI 研究員」,未列雇主;他的 X 個人檔寫的是「Research @Google, Zurich, Switzerland」,TechRadar 也以「Google researcher」稱呼他。CellCog 的查核則明確指出:「原文並未提及雇主。」所以他是 Google 研究員這件事有本人社群帳號背書,但並不是從文章本身得知的。
INAH 的回信到底證明了什麼? 這是最容易被過度延伸的一環。回信原文只說「在您報告所指的座標位置,未發現已登錄的考古遺址」——這是關於登記系統的陳述,不是關於該地不存在遺址的判斷,更不是對該遺址的確認。HN 網友 sam1r 的質疑相當合理:對一個從遠方憑空指出的座標,專業機構給出「查無此地」的回覆,既是合理的行政答覆,也不能推論出任何肯定性結論。同一篇討論裡另有估計該遺址位置已在 2025 年論文中被繪製(詳見上一節),等於連「未曾被記載」都不成立。
最要命的一點是文獻檢索這一關。 代理確實執行了文獻搜尋,而且正是這次搜尋的結果讓整件事一度成立為「發現」。它失敗的原因不是搜尋工具不夠強,而是關鍵文獻是一篇區域尺度的普查論文,搜尋策略沒有命中。wholinator2 的留言總結了這個模式的普遍性:代理可以給出一份漂亮、完整、說服力極強的發現報告,直到要求它做一次嚴謹的文獻檢索,它才會回來說「既有研究降低了這個發現的新穎性」,並找到能輕鬆解釋那些發現的論文。octocop 的一則短評更直接:「這篇文章最後成了一個對 LLM 代理盲目信任的完美案例。」
Siami 觀點
這件事最有價值的地方,可能不在遺址本身,而在它把「AI 做科研」這件事從一個樂觀敘事,拉回到一個可以逐條檢驗的狀態。
把它拆開來看,鏈上有四種不同等級的東西,而且這四種等級的成色差異極大:
- 量測層(成立):NASA 的公開雷達資料確實能看見林下的地形;1,200 平方公里的資料量確實能被代理批次看完;那個台地的形狀確實不像自然地貌。這一層沒有問題。
- 判讀層(部分成立、有已知失效模式):代理依指南辨識人造結構這件事可行,但指南就是判準本身,且已知在這次的案例中漏掉了關鍵文獻。失效模式不是隨機雜訊,而是系統性的——它會安靜地漏掉「這件事早就有人做過」這整類資訊。
- 推論層(未經檢驗):年代、用途、功能配置(神廟、市集、蓄水池、房舍)全部來自與代理的一場對話,作者本人標註為推測。這一層目前沒有任何獨立驗證。
- 流程層(成立、且是最被低估的一項):代理能把一個外行從「隨口一想」推到「正式寫信給國家考古機構」,並在三天內走完。這一項才是這樁事件真正的技術增量。
其中第四項最值得留意。過去幾年 AI 代理的示範多半集中在「生成一個東西」——一段程式、一張圖、一份報告。而這次展示的是「推進一段有外部依賴的真實工作流程」,包含查詢外部系統、判斷外部事實、承擔對外溝通的後果。代理開始需要為對第三方機構發出的訊息負責,這是一個質變。
但同一個案例也示範了風險的形狀。最刺眼的一組對照是:代理替一個不會西班牙文的人,用 AI 寫了西班牙文的正式考古通報信,交給一個自己都說不清語言品質的機構——而這份通報如果被當真,可能帶來實際的現場壓力。這不是「AI 犯錯」,這是「AI 承擔了不屬於它的權威性」。作者自己在文章開頭就寫下「我不是考古學家」,這份坦誠值得肯定;但坦白並不能自動補上專業資格。
至於 11 月 11 日那次自我更正,是整個事件裡最健康的一個環節。作者可以在 11 月 10 日的版本裡繼續維持「AI 找到未記載遺址」的敘述,流量會好得多,標題也會更有爆點。他沒有。CellCog 的查核文章裡有一張表格,把四個標題說法逐一對照原始記錄並標出哪些成立、哪些被推翻;這種「把自家敘事拆開來檢查」的寫作方式,恰好是 Siami 一直想示範的東西——不是轉貼發現,而是追問這個發現到底站在什麼上面。
最後一個更長的視角:Miotti 說「我們大概應該把整個地球雷達掃一遍,讓代理去發現剩下的東西」。這句話在 2026 年聽起來像是個好主意,但它的瓶頸從來不在掃描,而在後續——考古學家的時間、法律授權、現場保護、盜掘風險,以及誰來為一份由代理起草的通報負責。技術把發現的成本壓到接近零的同時,也把「消化發現」的成本變成了唯一的瓶頸。一個領域會被新技術改造多少,取決於瓶頸移走之後,剩下的那個瓶頸有多硬。
延伸閱讀
- Pietro Miotti 個人部落格〈My AI Agents Found an Unmapped Maya Site〉|本次事件的一手來源,含完整日誌、四個日期的時間軸、雷達影像與點雲切面、INAH 回覆原文截圖,以及 11 月 11 日作者自行加上的「再發現」更正
- TechRadar〈Google researcher discovers unmapped Maya site in Mexico using 48 AI agents〉|主流科技媒體的獨立報導,確認代理查閱 NASA 雷達資料庫、代寫西文通報信與 INAH 介入調查等細節
- CellCog〈AI Agents Find Unmapped Maya Site: What Is Confirmed〉|逐條查核原文與四個標題說法的落差,並列出「目前仍未知」的五件事;作者已主動聲明自家利益關係(賣 AI 研究助理),這種聲明本身值得一讀
- Estrada-Belli 等人〈New regional-scale Classic Maya population density estimates and settlement distribution models through airborne lidar scanning〉|《Journal of Archaeological Science: Reports》第 66 卷,2025 年 10 月;本次「再發現」對象的原始出處,遺址圖繪見第 14 頁
- Tulane 大學新聞稿〈Ancient Maya population may have topped 16 million, Tulane research shows〉|Estrada-Belli 研究的機構端說明,低地人口估計從舊值上修至 950 萬至 1,600 萬
- Hacker News 討論串(853 分、313 則回覆)|本文留言的主要來源,含作者本人 miotts 的更正留言、wholinator2 關於「文獻檢索才會戳破幻象」的實務經驗,以及 TSiege 對考古產能與盜掘風險的提醒
- Pietro Miotti 的 X 貼文|原始發表,CellCog 記錄其在 11 月 11 日 14:09 UTC 已累積約 102.5 萬次瀏覽
- 第三方頻道 Howtown:The forest was full of cities we couldn’t see|以雷達考古為題的科普帶讀,可作為理解「雷達如何看穿樹冠」的背景
- 第三方頻道 David Pompeani:Hidden Cities of the Maya — 95,000 km² of Lidar with Francisco Estrada-Belli|訪談本次遺址的原始繪圖者 Estrada-Belli,說明區域尺度雷達普查的樣貌與研究分工
- 英國線上雷達地圖 lidarmap.uk|HN 網友 hanoz 製作,說明「用公開雷達找未知遺址」在歐洲早已是日常作業
網友熱門留言 (10)