編按:本文綜合整理自 Google 官方部落格〈Gemini Decisions API: Fast, calibrated multimodal decisions〉、Google AI Studio 官方文件〈Decisions API〉、Google AI Studio 官方文件〈Gemini Decision 1〉、MarkTechPost〈Google Launches Gemini Decisions API With Gemini Decision 1 at $0.10/M Tokens〉、Simon Willison〈Gemini Decisions API〉(附實際測試輸出)、The Decoder〈Google joins the decision-model wave with Gemini Decision 1〉、InfoWorld〈Google’s Gemini Decisions API to handle up to 1,000 questions per request〉、Flavio Copes〈How to use the Gemini Decisions API〉、Google for Developers 官方 X 貼文 與 Hacker News 討論串(549 分/157 則回覆),並加入 Siami 編輯部觀點與分析。文中所有基準數字皆為 Google 官方自測結果,文中所有引用回覆皆引自該 Hacker News 討論串。
「Jev 和 OpenAI 對是非題都會回傳 1.0 或 0.0,但 Gemini 堅持不要那麼絕對。」 —— 引述自 Simon Willison 實測 Gemini Decision 1 判斷影片內容的輸出
2026 年 11 月 11 日,Google 釋出一個新的 API 端點,以及一個新的模型:Gemini Decisions API 與 Gemini Decision 1。
這件事的意義不在「Google 又發了一個模型」,而在於它代表 AI 應用架構的一次轉向——從「讓模型寫一段話,你的程式再把那句話解析成判斷」,變成「讓模型直接回傳一個機率,你的程式直接拿數字去分支」。
Google 官方部落格的說法是:生成式模型是寫給人看的文字,而當你的程式需要一個判斷來決定走哪條路時,讓模型生成文字再解析,會同時浪費延遲並製造脆弱的解析邏輯。Gemini Decision 1 就是為了拿掉這一步而生的。
一、它到底是什麼:一個只回傳機率的模型
Gemini Decision 1 是一個專為封閉式決策打造的多模態模型,掛在 Gemini Developer API(v1beta)上,可以直接在 Google AI Studio 拿金鑰試用。
一次請求由三個部分組成:
- model:固定是
gemini-decision-1 - input:一份共享輸入,可以是文字、JSON、圖片、音訊、影片、PDF,上限 262,144 tokens
- questions:一個問題映射表,最多 1,000 個彼此獨立的問題
關鍵在於「不打 token」這件事。標準模型是一個字一個字解碼出來的,你得寫提示詞、要求它吐 JSON、再解析、再祈祷它真的給了你列舉的其中一個值。Gemini Decision 1 完全跳過這段:它在單次前向傳播中直接為你的候選選項打分,回傳機率與信心值,輸出 token 永遠是 0。
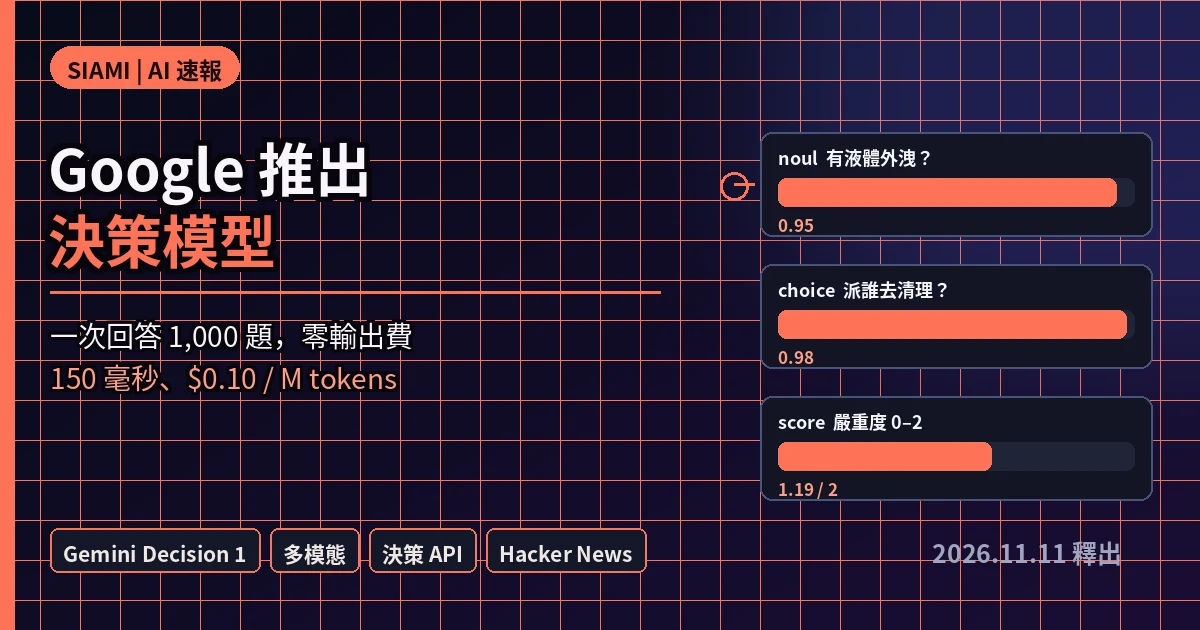
官方公布的效能數字是:模型本身的計算時間中位數 50 至 100 毫秒,端到端 150 至 250 毫秒;輸入上下文在 16K tokens 以內時這個數字幾乎不變,而且從問 1 題到問 100 題,延遲幾乎持平。
計價是輸入每百萬 tokens 0.10 美元、輸出 0 美元。共享輸入在一次請求中只計費一次,不管你問幾題,每題只額外加上它自己的指令與判準 tokens。官方並強調:沒有輸出 token 費用、沒有思考 token 的浮動計費、也沒有另外收音訊轉錄或 OCR 的錢。
二、三種題型:是非、選項、量表
Decisions API 定義了三種問題類型,每題都會附上一個 0 到 1 之間的信心值,讓程式可以決定自動執行還是轉人工。
- noul(是非題):回傳「是」的機率,官方文件標示範圍落在 0.01 到 0.99 之間。可以附上判定為真或為假的描述條件。
- choice(選擇題):從 2 到 255 個選項中挑一個,回傳勝出者以及每一個候選的標準化機率。
- score(量表評分):依序的評分等第(2 到 255 階),回傳加權後的分數與每一階的機率。
官方文件裡的三個設計原則寫得很直白:平行且互相隔離的評分(每題都對同一份共享輸入單獨打分,題目看不到彼此)、值加上信心值(答案告訴你該做什麼,信心值告訴你能不能放心自動做)、以及原子化的檢查、在程式裡組合(每題都問得窄一點,再用一般的 if 與權重把它們組合起來)。
官方舉的範例很生活化:一張茶水間吧台的照片加上一句文字備註,用同一次請求問「有沒有液體外洩」(noul)、「該採取哪種清理動作」(choice,選項包含用布擦、派清潔員、可以開會了)、「嚴重度幾分」(score),三種題型一次回。
三、真正的賣點不是準確率,是多模態
這次發表最被低估的一點,是這是第一個能原生吃音訊、影片與 PDF 的決策模型。
在此之前的決策模型賽道裡:
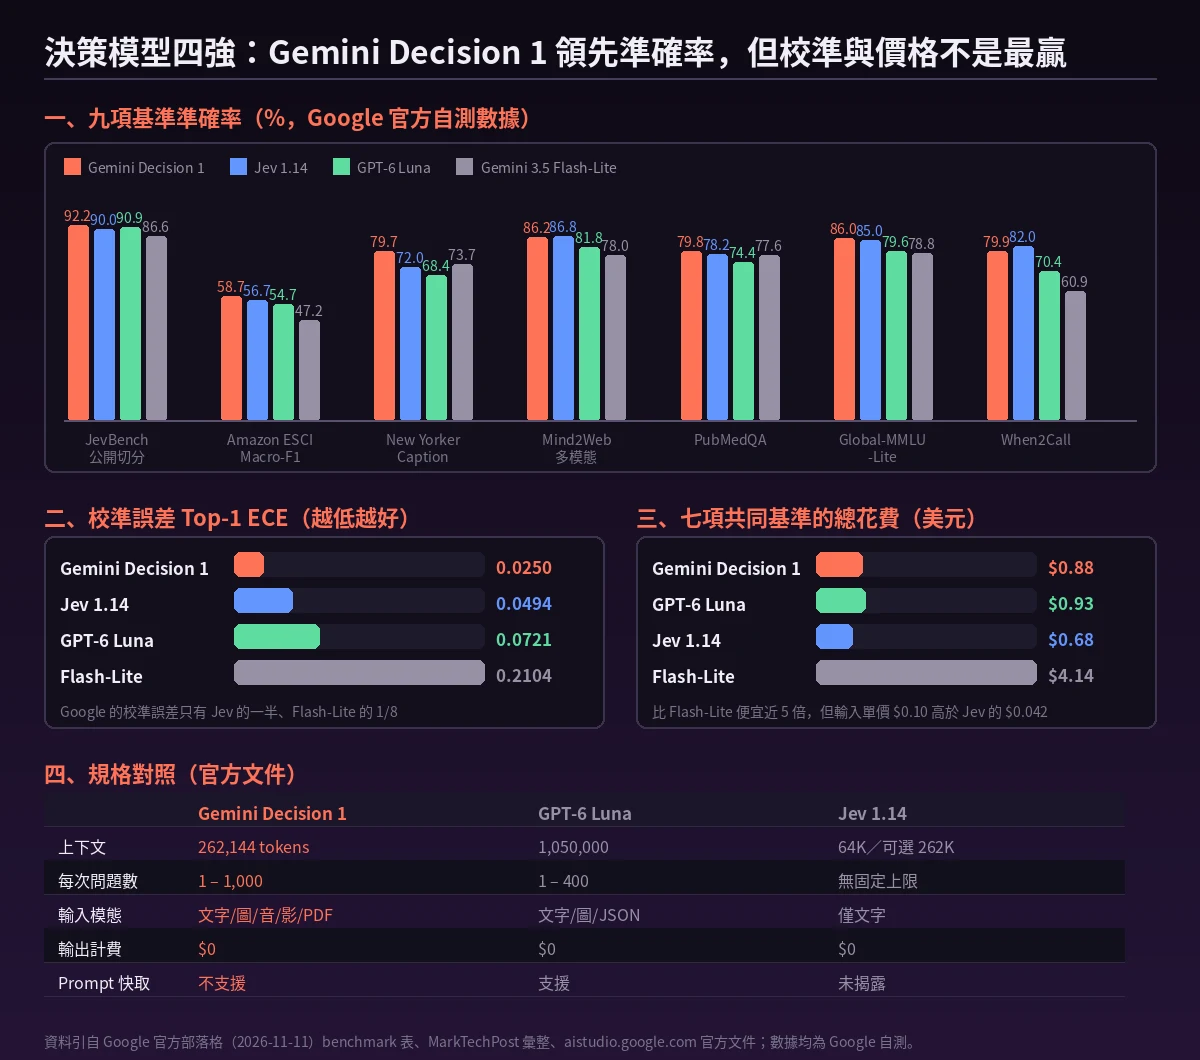
- TypeSafe Jev 1.14:只吃文字與文件,上下文每次請求 64K(加一個特殊 header 可拉到 262K),沒有固定的問題數上限,輸入單價每百萬 tokens 0.042 美元,是三者中最便宜的。
- OpenAI GPT-6 Luna(OpenAI Decisions):支援文字、圖片與 JSON,上下文 1,050,000 tokens,每次請求最多 400 題,輸入單價 0.10 美元,支援 prompt caching。
- Google Gemini Decision 1:文字、圖片、音訊、影片、PDF 全吃,上下文 262,144 tokens,每次請求最多 1,000 題,輸入單價 0.10 美元,目前不支援 prompt caching。
也就是說,在「拿一份 PDF 或一段客服錄音去判斷」這件事上,Google 這一步是真的補上了缺口。Hacker News 上有網友直言,這件事 Google 自己宣傳得太少,行銷又把球掉了。
另一個容易被忽略但很實際的優勢是校準。Google 公布的 Top-1 ECE(期望校準誤差,越低代表機率數字越可信):
| 模型 | Top-1 ECE |
|---|---|
| Gemini Decision 1 | 0.0250 |
| Jev 1.14 | 0.0494 |
| GPT-6 Luna | 0.0721 |
| Gemini 3.5 Flash-Lite | 0.2104 |
Gemini 的校準誤差只有 Jev 的一半、Flash-Lite 的八分之一。這在實務上的意義是:你把信心值設成 0.8 當門檻,Google 這個模型說 0.8 的時候,它真的大約有 80% 的時候是對的。Simon Willison 的實測也印證了這點——他拿自己拍的機器人影片去問「畫面裡有龍嗎」「有機器人嗎」「是在法國嗎」「是在美國嗎」,Jev 與 OpenAI 對是非題一律回 1.0 或 0.0,Gemini 給的是機器人 0.923、法國 0.083、美國 0.923、有龍 0.050。
最後那個數字特別值得看:它沒有對「畫面裡有龍」回傳 0.0。它在說「大概有百分之五的機率」,而不是「絕對沒有」。這種數字拿來做自動路由,才是真的能拿來用的。
影片為第三方頻道 Fahd Mirza 對 Gemini Decision 1 的實測與批評,非 Google 官方頻道。
四、基準測試:領先,但沒有全面領先
Google 官方公布的九項基準數據如下(拒答與安全攔截一律算錯):
| 基準 | Gemini Decision 1 | Jev 1.14 | GPT-6 Luna | Flash-Lite |
|---|---|---|---|---|
| JevBench(公開切分) | 92.2% | 90.0% | 90.9% | 86.6% |
| Amazon ESCI(Macro-F1) | 58.7% | 56.7% | 54.7% | 47.2% |
| New Yorker Caption | 79.7% | 72.0% | 68.4% | 73.7% |
| Mind2Web 多模態 | 86.2% | 86.8% | 81.8% | 78.0% |
| PubMedQA | 79.8% | 78.2% | 74.4% | 77.6% |
| Global-MMLU-Lite(非英文) | 86.0% | 85.0% | 79.6% | 78.8% |
| When2Call | 79.9% | 82.0% | 70.4% | 60.9% |
| MMAU(音訊) | 71.8% | 未公布 | 未公布 | 67.7% |
| Video-MME(無字幕) | 69.1% | 未公布 | 未公布 | 63.3% |
九項裡領先七項,Mind2Web 輸給 Jev 1.14,When2Call 也輸給 Jev 1.14。
價格面,七項共同基準的總花費是:Gemini Decision 1 0.88 美元、GPT-6 Luna 0.93 美元、Jev 1.14 0.68 美元、Gemini 3.5 Flash-Lite 4.14 美元。官方說比 Flash-Lite 便宜近 5 倍,這是真的;但單看輸入單價,0.10 美元仍比 Jev 的 0.042 美元貴上一倍多。
五、Google 已經在自己產品裡用了
這部分通常比 benchmark 更值得看,因為它代表 Google 內部真的相信這條路線:
- Gemini Notebook 動態模型路由:用 Decisions API 當即時路由器,把進來的問題即時導向最合適的模型層級與思考深度。官方說一般查詢的延遲最多降低 40%,複雜問題才留給深度推理模型。
- Stitch rapid canvas:新的快速畫布實驗,用 Decisions API 在幾秒內產出可操作的產品流程線框,並把語音或點擊的修改幾乎即時套用上去;流程 OK 之後再一鍵交給完整的 Stitch 流程做細部打磨。
- Google Labs CC:從 200 多個表情符號中挑出正確的回覆表情,讓回應即時出現而不增加延遲。
- Google Search 的安全層:用 Decision API 在延遲預算內偵測 MCP 工具的對抗性行為與內容。
這些應用有個共同特徵:每一個都是「大量、重複、單純、但需要判斷」的場景。這也說明 Google 對這條路線的定位——不是取代通用模型,而是當作通用模型前面的一層分流器。
六、生態、落地與兩個容易被忽略的條款
技術上要接的東西不難:google-genai SDK 3.2 以上,apiVersion 設成 v1beta,然後 client.decisions.create()。整合正在往 OpenRouter、LangChain、Vercel AI SDK、LiteLLM、Pydantic AI、Pipecat、LiveKit、OpenCode 鋪,Gemini in Google Cloud 則是「coming soon」。Google AI Studio 有免費層可以原型測試。
兩個容易被忽略、但會直接影響上線決策的條款:
- 免費層的資料條款:免費層是每分鐘 200 次、每天 10,000 次請求,額度不算小。但免費層上你的資料會被拿去改進 Google 的產品,付費層才不會。Flavio Copes 在他的實測文章裡特別標出這一條,理由很明顯:如果你要處理的是客服錄音、PDF 合約或使用者上傳的內容,這條得先看清楚。
- 不支援 prompt caching:這在 agent 場特別痛。你的系統如果每一輪都把同一份長上下文重新送一次,費用就是完整的。但同樣地,也可以反過來利用「共享輸入只計費一次、每題只加自己的指令與判準 tokens」這個特性,把大量檢查塞進同一次請求。
七、決策模型賽道:三家已經到齊
這件事其實不是 Google 單方面推出的一個新品,而是決策模型這條賽道在兩個月內連續補位完成。
時間線大致是這樣:
- 新創公司 TypeSafe 先推出 Jev,主打封閉式決策與校準。
- OpenAI 跟進,推出 Decisions API 與 GPT-6 Luna。
- Cloudflare 與 Microsoft 隨後也推出類似產品。
- Google 在 2026 年 11 月 11 日補上最後一塊,而且是唯一一個原生支援音訊與影片的。
Hacker News 討論串拿下 549 分、157 則回覆,討論品質相當高,大致沿著四條線打:
第一條線是「這東西到底是新東西嗎」。 有開發者說,這看起來就是 Google 自己版本的 Jev,而且連「noul」這個非標準命名都直接沿用。Simon Willison 也點出同樣的觀察:三者的 API 幾乎一模一樣,連 Jev 的術語都照抄了。
第二條線是 Jev 這家公司 disappearing 的方式。 有網友直接說,Google 沿用 Jev 的術語卻完全不提 Jev 的名字,對一家小很多的競爭對手不承認影響來源,這手不厚道。另一派則認為這很正常:Google 落後幾個月根本不重要,它的客戶是企業,企業不會急著搶最新。
第三條線是「這需求一直都在,只是以前沒人給便宜的解」。 有開發者說,他從 2023 年初開始就送過兩千兩百萬到三千萬次請求給 OpenAI 的 completions API,全部拿來做文字分類,覺得 OpenAI 只是沒有動機提供一個比較便宜的版本來做同樣的事。
第四條線是校準與透明度的老問題。 有開發者回憶自己參與過 outlines 函式庫(做替代抽樣與受限輸出的工具),說當時就很清楚校準是個大問題——你把類別設成高/中/低,模型真正想說的詞可能根本不在你的類別裡;有開發者則追問,決策模型跟一般 LLM 在「說不出理由」這件事上的差別到底在哪。
為什麼這件事重要
第一,AI 應用的成本結構正在從「每次呼叫都寫一段話」轉向「每次呼叫只出一個分數」。 一個典型的 agent 迴圈裡,模型被呼叫的次數遠多於最終產出文字的次數:路由、工具選擇、安全檢查、內容分級、格式驗證,這些全部都是「問一句、拿一個判斷」。過去這些全部用生成式模型硬做,意味著每一次判斷都在付輸出 token 的錢、都在等 token 解碼的時間、都在承擔解析失敗的風險。Gemini Decision 1 把輸出 token 直接歸零、延遲壓到 250 毫秒以內、同一份輸入可以一次問一千題,這三件事一起發生,會讓大量「以前覺得不值得做」的判斷功能變得划算。
第二,決策模型是一個新的產品類別,而且已經是三巨頭全到齊。 兩個月內 TypeSafe、OpenAI、Cloudflare、Microsoft、Google 依序進場,這在 Siami 過去追蹤的 AI 發展史裡不算常見。上一個類別級的轉移是 agent 與工具呼叫,再往前是長上下文與多模態。決策模型的邏輯跟那些不同——它不是「更強的模型」,而是「一種用途更窄、成本結構完全不同、可以跟通用模型並存」的模型層。值得注意的是它的定價結構:輸出費為零。這意味著決策模型在架構裡的位置很清楚——它是分流器,不是終點。
第三,Google 內部四個產品同時採用,代表的訊號比任何 benchmark 都強。 當一個模型被拿來做 Gemini Notebook 的即時路由、做 Stitch 的秒級線框、做 CC 的表情選擇、做 Search 的安全層,這些都是低延遲、高併發、真實流量、錯了就有使用者受影響的場景。官方說一般查詢延遲最多降 40%,這是從真實產品裡抽出來的數字,不是 lab 裡的數字。
數據解讀與質疑
質疑一:所有數字都是 Google 自己測的。 九項基準、校準誤差、延遲、便宜五倍,全部出自 Google 官方部落格的表格,沒有第三方複現。表裡「拒答與安全攔截一律算錯」的計分規則是 Google 定的,而對決模型來說,拒答率高低直接影響分數,這個規則的寬嚴由被評者決定。
質疑二:比較基準選得很微妙。 對照組是 Jev 1.14、GPT-6 Luna 與 Gemini 3.5 Flash-Lite——Jev 是這條賽道的開創者,被拿來當第一基準;Flash-Lite 則是自家最便宜的通用模型。表裡沒有列出 Cloudflare 與 Microsoft 的對應產品,也沒有列出任何真正做分類的專用小模型(例如實際做大量內容審核的廠商常用的那些輕量分類器)。Flavio Copes 的實測也提醒,真正在意成本的人可能早就用更小的專用模型在做同一件事——HN 上就有網友說,他們通常使用更小、更專門的模型來做類似工作,成本便宜得多。
質疑三:宣傳沒講的事,數據裡看得到。 第一,不支援 prompt caching,這在 agent 場是實質成本。第二,When2Call 輸給 Jev 1.14(79.9% 對 82.0%)——這是「該不該呼叫工具」這類實際生產環境最在意的指標之一。第三,MMAU 與 Video-MME 上 Jev 與 GPT-6 Luna 都沒公布數字,只有 Flash-Lite 有,所以那兩列的「領先」是在一個對手缺席的比較裡拿到的。第四,Amazon ESCI 的 58.7% 絕對值其實偏低,這是一個商品型錄比對任務,58.7% 的 Macro-F1 代表四成的判斷是錯的——這對「要不要自動執行」來說是很嚴肅的數字。
質疑四:0.10 美元的單價在實際工作負載下未必便宜。 決策模型的典型用法是把同一份長輸入重複送 lots of times 去做不同檢查,而 Google 不支援 prompt caching,共享輸入雖然單次請求只計費一次,但跨請求不會重用。以每秒數百次判斷的規模來算,輸入 token 會是主要成本,而 0.10 美元對比 Jev 的 0.042 美元,差距會被放大成倍數。
質疑五:免費層的資料使用條款。 拿客服錄音、PDF 合約、使用者上傳內容去做決策測試的團隊,如果沒有先確認免費層的資料流向就開始跑,等於把自己的資料交出去了。
Siami 觀點
決策模型這條線,會不會是又一個「看起來重要、實際用不到兩年就併回通用模型」的短期分支?目前看起來不會,理由跟當年 function calling 的情況一樣,但更明確:輸出 token 為零這件事,改變的是經濟結構而不是能力結構。 Function calling 讓模型「可以」輸出結構化資料,但模型還是要先解碼出那些 token;決策模型連解碼都跳過了。當一個判斷的邊際成本從「一次生成 + 一次解析 + 一次機率崩潰的風險」降到「近乎免費的數字」,很多本來不划算的自動化就開始划算。這種變化一旦發生就很難回頭。
但真正值得留意的是這場競爭的結構,而不是誰的 benchmark 高兩百分點。Google 這次的選擇很明顯:多模態、1,000 題、零輸出費、校準誤差砍半——每一項都是瞄準「企業內部大量重複判斷」這個真實痛點,而不是 demo。Jev 走的是最便宜、純文字的窄路徑;OpenAI 走的是上下文最大(105 萬 tokens)、支援快取的路徑。三家沒有正面重疊,這表示還沒有人認輸,也還沒有人把整個市場的形狀定下來。
比較有訊息量的是 Google 內部四個產品的採用方式:全部都是「放在通用模型前面做分流」,而不是「取代通用模型」。這跟 Siami 之前看過的 agent 架構演化是同一個方向——未來的應用程式不是一個模型包辦,而是一層層專門的、便宜的、快的小模型堆在前面,把真正困難的少數請求留給後面的通用模型。決策模型就是這條堆疊裡最新的一層。
至於 Google 沒提 Jev 這件事,在產業裡其實不算罕見——多半是法務而不是傲慢。但它提醒了一件事:決策模型這個類別的技術路線,最早是被一家小公司想出來的。當大公司開始沿用小公司的 API 術語卻不寫在出處裡,代表這個類別的設計語言已經被接受了,而最初的定義者被吸收得毫無聲息。這個循環,在 AI 產業裡大概還會再上演很多次。
延伸閱讀
- Google 官方部落格〈Gemini Decisions API: Fast, calibrated multimodal decisions〉|一手發表文,含官方 benchmark 表、四種內部應用案例與定價說明
- Google AI Studio 官方文件〈Decisions API〉|三種題型的完整定義、信心值語義與最佳實務
- Google AI Studio 官方文件〈Gemini Decision 1〉|模型頁:262,144 tokens 上下文、1,000 題上限、零輸出 token
- MarkTechPost〈Google Launches Gemini Decisions API With Gemini Decision 1 at $0.10/M Tokens〉|九項基準完整表格與三家規格對照表
- Simon Willison〈Gemini Decisions API〉|實際拿影片測試的機率輸出,顯示三個模型在是非題上的行為差異
- Flavio Copes〈How to use the Gemini Decisions API〉|Node.js 呼叫範例、免費層額度與資料使用條款提醒
- The Decoder〈Google joins the decision-model wave with Gemini Decision 1〉|決策模型賽道的競品背景整理(Jev、OpenAI、Cloudflare、Microsoft)
- InfoWorld〈Google’s Gemini Decisions API to handle up to 1,000 questions per request〉|企業觀點,說明共享輸入只計費一次的實際成本影響
- Google for Developers 官方 X 貼文|官方第一手公告
- Hacker News 討論串(549 分/157 則回覆)|校準問題、免費模型分類的既有替代方案、以及決策模型與 LLM 的差別之辯
- YouTube:Fahd Mirza〈Google’s Gemini Decision 1: Fast, Cheap, Not Perfect〉|第三方頻道對 Gemini Decision 1 的實測與批評
- YouTube:深度价值前沿〈Google’s Gemini Decisions API: 150ms〉|第三方中文頻道對延遲與零輸出費的解析
網友熱門留言 (7)