編按:本文綜合整理自 Unemployment Labs《Checkpoint Forensics》鑑識報告、報告公開的驗證程式碼(github.com/macrogrants/checkpoint-forensics)、作者 Will DePue 的 X 貼文、Fortune〈How Megaspeed built a network in Southeast Asia to move $7.5 billion of Nvidia chips to Chinese companies〉、CNBC〈What is Megaspeed? Nvidia customer in spotlight after DOJ probe〉、Federal Register〈Revision to License Review Policy for Advanced Computing Commodities〉、BIS 2026-05-31 指引 與 Hacker News 討論串(281 分/82 則回覆),並加入 Siami 編輯部觀點與分析。文中所有 σ 值、SM 數與 GPU 數量均引述自該鑑識報告;報告本身對部分估算明確聲明信心有限,讀者應留意其自述的邊界條件。
AI 模型的權重裡,其實藏著一張看不見的硬體身分證。
2026 年 11 月 12 日,研究機構 Unemployment Labs 發表一份鑑識報告,方法是一種純數值分析:從廠商公開釋出的模型權重,反推出這個模型「初始化」時跑在哪一類 GPU 上。結論是,DeepSeek、Moonshot AI、MiniMax 與螞蟻集團四家中國實驗室最新釋出的六個模型,都留下了 NVIDIA Blackwell 世代的指紋——而 Blackwell 對中國出口需要美國政府許可,報告稱至今沒有任何一筆已回報的許可。
這份報告的份量不在於「又有媒體爆料中國偷晶片」,而在於它不需要任何內部消息或機密文件:證據全部來自廠商自己公開的權重,任何人都能下載重跑。
一、方法:從一顆亂數種子反推整座機房
整個鑑識的起點,是一個聽起來很普通、實際上極度關鍵的實作細節。
模型在訓練開始前,權重必須先有初始值。這些初始值由偽亂數生成器產生,主流框架 PyTorch 透過 NVIDIA 的 cuRAND 函式庫呼叫 Philox 演算法。Philox 是確定性的:給定同一個「種子」(seed)與同一組設定,就會產生完全相同的數字序列。
關鍵在於,PyTorch 為了把數十億個權重快速填滿,會把 Philox 的工作分攤給 GPU 上的數千個平行「執行緒」。每個執行緒負責自己那批位置,而執行緒總數取決於晶片上的串流多處理器(SM)數量。換句話說,同一顆種子撒在不同規模的晶片上,數字會落在不同的位置。
報告用一個簡化例子說明:48 執行緒時,thread 0 填入第 1、49、97 個位置;換成 40 執行緒,同樣的數字序列就改填第 1、41、81 個位置,數字本身完全相同,位置卻整個錯開。整個矩陣只剩 6% 吻合。
在真實晶片上,這幾組參數是這樣的:
- Hopper H100 SXM/H200/H800:132 個 SM,270,336 個執行緒
- Blackwell B200/B300:148 個 SM,303,104 個執行緒
- Blackwell GB200/GB300(Grace Blackwell 機櫃級):152 個 SM,311,296 個執行緒
而訓練並不會完全抹掉這些痕跡。有些權重(例如從未在訓練中出現過的詞彙或符號對應項)幾乎原封不動地保留了初始值,可以直接比對;其他權重則會保留微弱的統計痕跡——數十萬個權重加總後,起始值較高者最終值仍傾向較高(報告在 DeepSeek-V4-Flash 上量到 r = 0.066、57σ)。
研究者拿著模型權重,去窮舉「種子 × 版面配置」的組合,看哪一組能把發布出來的權重原樣重建回來。
二、六個模型對上 Blackwell,四個還是機櫃級
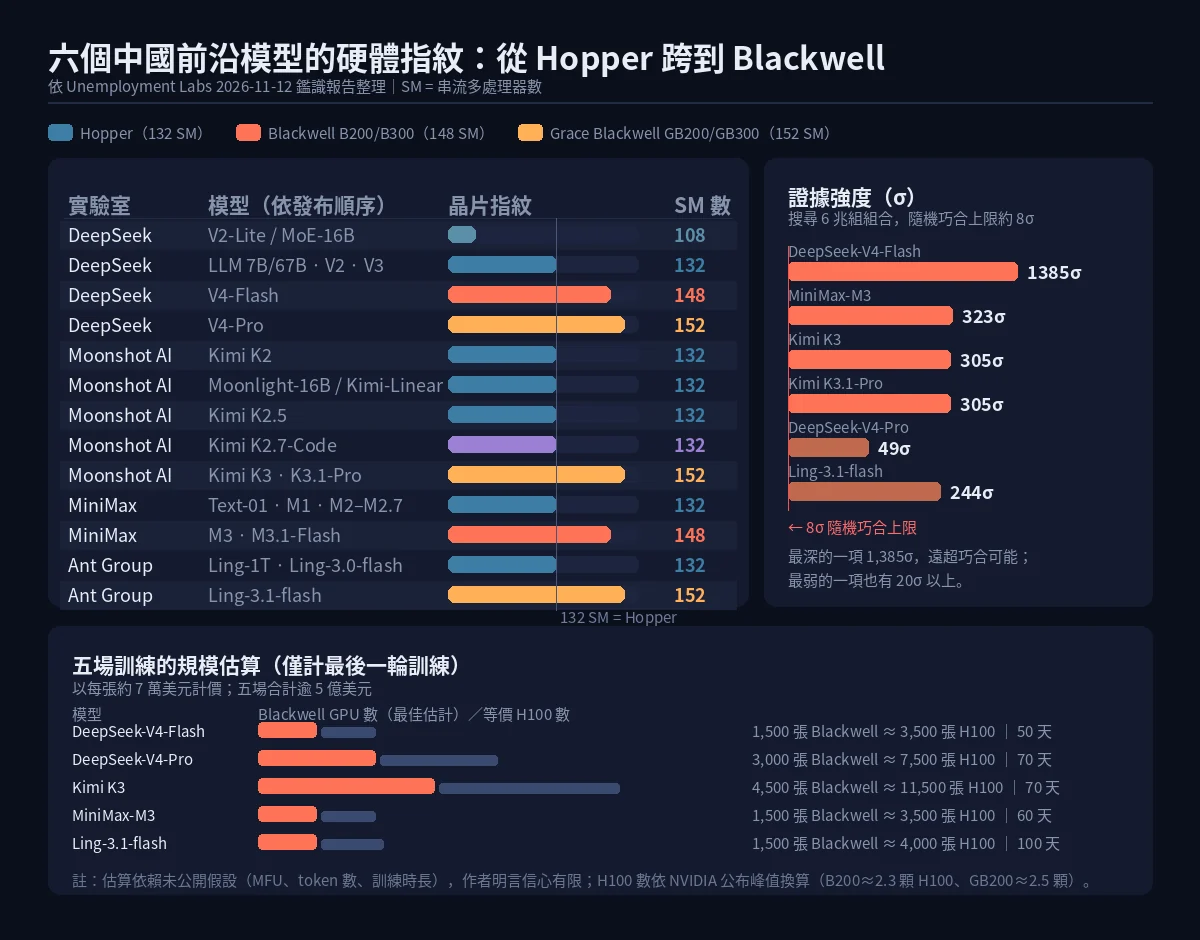
搜尋結果相當乾脆。報告列出六個讀起來像 Blackwell 訓練的模型:
| 實驗室 | 模型 | 發布 | 對應硬體 | 證據強度 |
|---|---|---|---|---|
| DeepSeek | V4-Flash | 2026-04 | Blackwell B200/B300(148 SM) | 1,385σ |
| DeepSeek | V4-Pro | 2026-04 | Grace Blackwell GB200/GB300(152 SM) | 49σ |
| Moonshot AI | Kimi K3 | 2026-07 | Grace Blackwell GB200/GB300(152 SM) | 305σ |
| Moonshot AI | Kimi K3.1-Pro | 2026-11 | Grace Blackwell GB200/GB300(152 SM) | 305σ |
| MiniMax | M3 | 2026-06 | Blackwell B200/B300(148 SM) | 323σ |
| 螞蟻集團 | Ling-3.1-flash | 2026-10 | Grace Blackwell GB200/GB300(152 SM) | 244σ |
其中四個指向 GB200/GB300——也就是 NVIDIA 旗艦級液冷機櫃系統的 Grace Blackwell 版本,不是單卡層級的東西。
統計門檻這關值得單獨說明。研究者一共搜尋約 6 兆組種子與版面組合;在這種規模的搜尋裡,即使候選完全錯誤,純粹巧合也可能達到約 8σ(八個標準差)。他們先在一組權重上選出種子與配置,再拿到完全沒參與選取的另一組權重上驗證,結果六個模型落在 49σ 到 1,385σ 之間,最弱的一項單獨測試也有 20σ 以上。報告並附上「已知答案」的 24 個案例作為方法校準:Meta 的 Llama 3.1 系列讀出 132(開發者已聲明用 H100)、EleutherAI 八個 Pythia 模型讀出 108(A100),NVIDIA 自家的 Nemotron-3 Ultra 技術報告寫明某階段用 GB200,方法讀出的正是 152。
實機重現的部分最硬。作者在實體 B300 上跑未經修改的 PyTorch,用 DeepSeek 的種子 953049583,重現了 V4-Flash 469 個受選列中的 461 列(其中 445 列逐位元完全相同);同一顆種子放到 H100 上,則逐位元重現了 DeepSeek-V3 的全部 57,344 個保留值。租來的 GB200 同樣用 Moonshot 的種子 20256586 重現了 Kimi K3 的全部 13 個保留列。種子數字只要差一,兩台機器上就一個吻合的列都沒有。
三、指紋時間軸:什麼時候換的卡
把每家實驗室的模型按發布時間排開,畫出的軌跡相當一致——轉折點集中在 2026 年:
- DeepSeek:V2-Lite/MoE-16B(108 SM,A100/A800)→ V3 系列(132 SM,Hopper)→ V4-Flash 與 V4-Pro(2026-04 一次跳到 Blackwell)
- Moonshot AI:Kimi K2(2025-07)→ Kimi-Linear(2025-10)→ K2.5(2026-01)→ K2.7-Code(2026-06)→ K3(2026-07)跳到 Grace Blackwell
- MiniMax:Text-01 到 M2.7 都是 Hopper → M3(2026-06)跳到 B200/B300
- 螞蟻集團:Ling-3.0-flash(2026-08)仍是 Hopper → Ling-3.1-flash(2026-10)跳到 GB200/GB300
Kimi K2.7-Code 是個有趣的中间态:它建立在 Hopper 時代的權重上,但其中一小塊(去掉 132 SM 部分後 254 列)符合 B200/B300 的 148 SM 版面,達 246σ。像是一次正在進行中的換卡。
但不是所有中國實驗室都換了。報告實測阿里巴巴(Qwen)、智譜(GLM)、騰訊、小米與 StepFun 的最新模型,全部仍讀為 Hopper;美團則表示 LongCat-2.0 完全在「AI ASIC 超級叢集」上訓練,權重裡也找不到任何 NVIDIA 指紋。
四、規模估算:這不是借兩張卡
這裡有一個必須標明「是估算」的部分。報告從模型規模與訓練 token 數反推每一場訓練需要多少張卡:
- Kimi K3:約 4,500 張 Blackwell(等價 11,500 張 H100),推估 70 天
- DeepSeek-V4-Pro:約 3,000 張(等價 7,500 張 H100),70 天
- DeepSeek-V4-Flash/MiniMax-M3/Ling-3.1-flash:各約 1,500 張
- 五場合計:約 12,000 張 Blackwell,等價 30,000 張 H100
以每張約 7 萬美元計價(這個單價來自《華爾街日報》報導的「約 36,000 張 Blackwell 晶片裝在馬來西亞供字節跳動使用,成本超過 25 億美元」),最大的一個叢集落在 2 億到 3 億美元,五個加起來超過 5 億美元。
報告同時相當坦白地列出這個估算有多不可靠:模型效率(MFU)沒人公開過、token 數多數是他們自己估的、訓練時長沒有任何一家說過,而且整個推算建立在「訓練全程都在初始化那批硬體上」這個前提。報告還特別註明,第一版(11 月 12 日修訂前)估的是最大兩場各 2,000 到 3,000 張、單一叢集 1.5 億到 2 億美元;新版因為假設 GPU 運作效率低於 NVIDIA 官方 benchmark 而上修。
五、AMD 替代解釋,以及它為什麼被排除
任何指紋鑑識方法,第一個問題都是:會不會有別的東西碰巧長得一樣?
報告逐一排除了幾種可能:
- 舊世代 NVIDIA 卡:軟體可以用掉一張晶片的一部分處理單元,但不可能給它比實體更多的,因此無法產生 148 或 152 SM 的版面。中國市場版 Blackwell 顯示卡每個 SM 的執行緒數不同,兩種版面都產生不出來。
- AMD MI300X:這是最像的替代解釋。MI300X 平常用 304 個運算單元,但可以切成兩組 152 個,或設定成只用 148 個,而且它的亂數軟體能產生與 NVIDIA 相同的底層序列。作者在實體 MI300X 上確認了這點。
- 排除方式:NVIDIA 與 AMD 在亂數生成過程中有一步計算略有差異。在實體 MI300X 上比對 DeepSeek-V4-Flash 的保留權重,兩家結果不同的 377 個值裡,發布的權重有 363 個符合 NVIDIA、符合 AMD 的是 0 個。這就排除了 AMD。但同樣的測試對其餘五個模型無法定案,報告只說「認為非常不可能」。
作者也明說了方法的失效邊界:需要公開權重,閉源模型查不到;百度用 PaddlePaddle 訓練的 ERNIE-5.5 框架不留下這種特徵(種子 2760 找得到,硬體卻認不出);阿里巴巴幾個 Qwen3 模型是在一般 CPU 上初始化的,因此不留任何 GPU 痕跡;DeepSeek-V4.1-Flash 也找不到指紋。
還有幾個「方法認證不成立」的情況,報告都主動列出來了。
為什麼這件事重要
第一,這是第一次有「可重現的硬體證據」取代情報與傳聞。 過去兩年關於中國取得 NVIDIA 晶片的說法,全部建立在官員放話、供應鏈傳聞或匿名消息上。US officials and press reports 早就指稱 DeepSeek 與 Moonshot 在用 Blackwell,卻從未公布技術證據。這份報告改變的是證據的種類:它從廠商自己開源的權重裡讀出答案,任何人都能下載模型、在 GPU 上重跑、並且連那個公開的驗證程式碼都一併附上。作者本人說得很清楚:「這不是基於內部資訊或機密外洩,而是基於廠商自己發布的模型權重所做的鑑識分析。」
第二,時間點把整件事推到最高音量。 這份報告出現在 11 月 12 日——黃仁勳辭去輝達 CEO 職務的第二天,也緊接在《紐約時報》報導美國正調查 Megaspeed(該公司自稱輝達「核心業務夥伴」,在新加坡與馬來西亞的機房把晶片租給中國客戶)之後。輝達市值在這段時間裡失守 4 兆美元。一份關於「出口管制可能失效」的技術報告,落在一家剛被內部醜聞與司法調查纏身的公司身上,時機自然會被放大解讀。
第三,它觸及了一個真實的、還沒有人解決的政策漏洞。 美國的出口管制管的是「晶片能不能進中國」,不是「中國公司能不能用」。CNBC 與 Fortune 的報導都指出,Megaspeed 在東南亞機房出租輝達算力給中國客戶的做法,本身不違反現行規定;而 2026 年 1 月 15 日生效的 BIS 規則把部分 AI 晶片的審查從「推定拒絕」改為「逐案審查」,5 月 31 日的指引又進一步收緊了對中國企業境外實體的規範。也就是說,物理位置、租用關係與最終使用者之間的縫隙,正是這些規則正在處理的東西——而這份報告用模型權重,證明了縫隙確實被使用了。
第四,規模數字會改變讀者的直覺。 如果只是「某個模型用了幾張高階卡」,那只是個技術新聞。但當五場訓練加總約 12,000 張 Blackwell、超過 5 億美元,且橫跨四家中國前沿實驗室,這就不再是零星取得,而是產業級的算力取得能力。
數據解讀與質疑
質疑一:這份報告不是學術論文,作者本人有明確立場。 HN 上有人直接點名:作者 Will DePue 是「從 OpenAI 轉出來的反對派意見領袖」,也是出口管制的主要倡議者之一;文章雖做成論文外觀,但沒有任何同儕審查,發表當下也沒有連到程式碼(後來才補上)。這不代表方法有錯——事實上,方法的強項恰恰在於可重現性,社群也確實複現了——但讀者應該把「誰說的」和「說得對不對」分開評估,就像讀任何一份有利益立場的產業分析一樣。
質疑二:報告自己反覆強調,指紋只能證明「硬體取得」,不能證明「違法」。 這是整份報告最被低估、也最重要的一段自我限制。它證明的是:這些模型的初始化發生在 Blackwell 上。它不能證明晶片在中國境內、不能證明取得途徑、也不能證明違反了出口管制。HN 上有人把這點講得很精準:「他們只是沒有揭露用的是哪些晶片。」而報告自己也承認,一個實驗室完全可以在 A 系統初始化權重、再移到 B 系統訓練——混合叢集同樣會留下這種指紋。反過來說,報告提到的其他公開證據(美國官員的說法、螞蟻集團公開程式碼裡的 GB300 benchmark 結果)也都只是間接佐證。
質疑三:GPU 數量估算的每一個前提都未經證實。 報告自己列了四項:MFU 沒人公開、token 數多數是自估、訓練時長無人透露、以及「訓練全程用同一批硬體」這個假設。報告甚至引用了微軟與 Mistral 兩個已知案例來說明同一硬體上的效率落差可以極大(Mistral Large 4 用 3,800 張 Grace Blackwell,微軟 MAI-Base-2 用 16,000 張跑 38 天),並指出若採微軟的節奏,最大兩場訓練會需要 8,000 到 9,000 張。這是估算的估算,不是查到的數字。 唯一相對可靠的是「量級」:這是資料中心等級的集群,不是借卡。
質疑四:這種方法本身可以被武器化。 一份能從權重反推硬體的技術,理論上也能被用來驗證「某個模型是不是在受限硬體上訓練」——包括美國本土模型。Kimi K2.7-Code 那種「混合叢集」的結果(132 SM 為主、混入一塊 148 SM 區塊)說明,這套方法未來可以變成常規的出口管制稽核工具。報告作者本人就是出口管制的倡議者,這把雙刃劍的另一面也因此更清楚。
質疑五:σ 值不是「真相的機率」。 1,385σ 聽起來驚人,但它的意思是「這個吻合極不可能由隨機巧合產生」,前提是統計模型正確描述了資料中的隨機變異。它描述的是「權重排列與某組硬體配置的吻合強度」,不是「這家公司違規的機率是 1,385 倍」。
Siami 觀點
這份報告最值得注意的地方,可能不在結論,而在它示範了一種新的查核方式。
過去談 AI 硬體取得能力,本質上是一場情報戰:雙方都持有對方看不到的資訊,然後各自選擇相信有利的那一邊。管制方說「他們在偷」,被管制方說自家手上有合法替代品,而公眾只能二選一。這份報告把其中一個變數變成了公開可驗證的事實:晶片型號可以從權重裡讀出來。
而且這件事的成本低到有點諷刺。整個方法的基礎設施,就是模型廠商為了讓大家下載而公開的權重檔案。任何一個有 GPU 的人,幾秒就能跑完作者附上的腳本。這跟情報機構動員線人的成本,是兩個數量級的東西。能被驗證的監管,不需要靠間諜。
但同一個特質也讓人保持距離。這份報告由一位有明確政策立場的人撰寫,發布時機緊接著輝達的一連串風暴,而它的證據鏈最容易被斷掉的地方,恰好也是最關鍵的地方:硬體取得 ≠ 違反管制。報告在這點上非常誠實,誠實到標題本身並沒有說「中國違反出口管制」——它只說「四家中國實驗室取得了 Blackwell 硬體」。這個差別不是文字遊戲。
Hacker News 上最尖銳的一則留言說:「這反而讓我更相信出口管制沒用,那為什麼還要管制?」這句話裡藏著整個政策辯論的核心張力——證明管制有效,需要證明受管制方沒拿到東西;而證明管制無效,只需要證明受管制方拿到了東西。 這是一個結構性不對稱,也解釋了為什麼雙方都會偏好自己那一邊的證據。
不過還有一層較少被談到的:即使「在境外租用算力」完全合法,這種租用關係本身也構成了一種依賴。中國的 AI 前沿能力有一個關鍵零件卡在別人的意志上——今天非正式地開著,明天可能就關上。對一個把 AI 視為國家級戰略的政府而言,這種依賴的代價,或許比取得晶片本身更值得在意。
而在 Siami 看來,這份報告真正示範的事情是:「誰在用什麼硬體」這個問題,未來可以被持續監控,而且成本近乎為零。 從出口管制的角度,這是好事——稽核變得便宜且客觀。從技術圈的角度,這也意味著廠商對「訓練用什麼卡」這件事的隱私,實質上已經不存在了。權重是公開的,指紋是公開的,方法也是公開的。
延伸閱讀
- Unemployment Labs《Checkpoint Forensics》完整鑑識報告|一手來源:方法說明、13 個模型的完整指紋表、GPU 規模估算表與全部自我限制說明
- 公開驗證程式碼 github.com/macrogrants/checkpoint-forensics|作者附上的重現腳本,可在筆電上跑完,或用未經修改的 PyTorch 在 GPU 上重現
- 作者 Will DePue 的 X 貼文|研究摘要與關鍵數字的原始說明(2026-11-12)
- Fortune〈How Megaspeed built a network in Southeast Asia to move $7.5 billion of Nvidia chips to Chinese companies〉|東南亞算力租賃網絡的規模與結構
- CNBC〈What is Megaspeed? Nvidia customer in spotlight after DOJ probe〉|Megaspeed 的商業模式與司法調查背景
- Federal Register〈Revision to License Review Policy for Advanced Computing Commodities〉(2026-01-15 生效)|BIS 將部分 AI 晶片審查改為逐案審查的正式規則原文
- BIS 指引文件(2026-05-31)|收緊中國企業境外實體取得美國 AI 晶片的官方文件
- Hacker News 討論串(281 分/82 則回覆)|關於合法性、作者立場、出口管制有效性與方法邊界的完整辯證
- YouTube:CBS News〈Inside Nvidia’s ties to Megaspeed, company led by alleged Chinese spy〉|CBS News 官方頻道對輝達與 Megaspeed 關係的專訪
- YouTube:ByteMonk〈How China Is Getting NVIDIA GPUs Despite the Ban: The Megaspeed Files〉|第三方頻道對 Megaspeed 晶片流向的整理
網友熱門留言 (6)