編按:本文綜合整理自 CNN Business〈Microsoft outage live updates〉、BBC News〈Microsoft outage updates: Schools, GPs and businesses hit〉、IT之家〈微软 365 核心服务全球性大规模瘫痪〉、SecurityWeek〈Microsoft 365 Outage Disrupts Outlook, Exchange Online and Teams〉、Microsoft 365 Status 官方公告、Downdetector 官方統計貼文、Microsoft 服務狀態中心、Hacker News 討論串(296 分/195 則回覆) 與 Reuters〈Microsoft scrambles to restore services as major outage hits〉,並加入 Siami 編輯部觀點與分析。文中所有時間點、服務代碼與 SLA 條款均引述自上述一手來源;截至發稿,Microsoft 尚未公布事故根因報告。
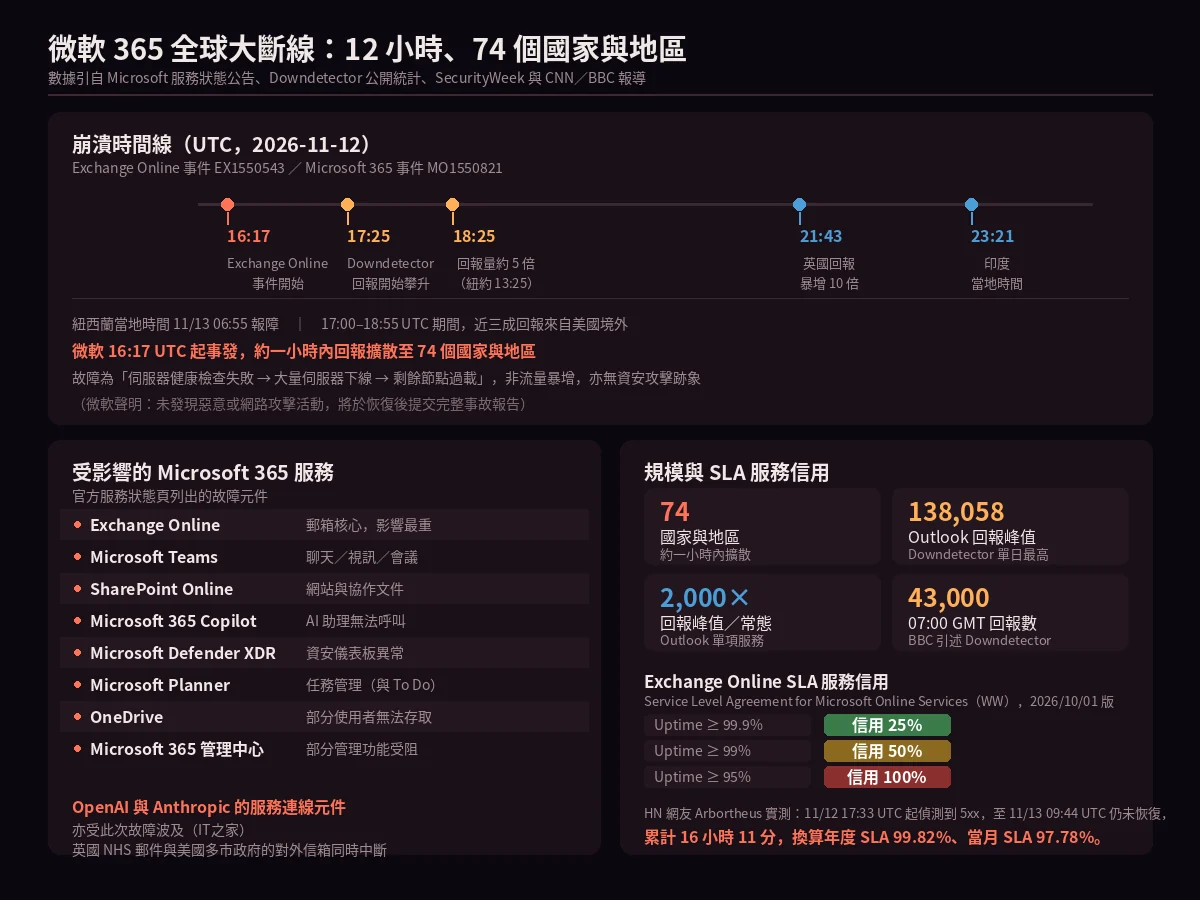
2026 年 11 月 12 日,台北時間凌晨 0:17,一個多數人還在睡覺的時刻,全世界三分之一以上的高階白領工作用視窗同時熄滅了。微軟的 Exchange Online 出現異常,官方服務狀態中心登錄為事件 EX1550543,隨後擴大為整個 Microsoft 365 的 MO1550821。Outlooks 收不到信、Teams 開不了會、OneDrive 傳不了檔、Copilot 叫不動。Downdetector 的統計顯示,這場災難在大約一個小時內就擴散到 74 個國家與地區,Outlook 的回報峰值來到 138,058 筆,是平時的約 2,000 倍。這不是資安攻擊——微軟執行長 Charles Lamanna 與澳洲內政部長 Tony Burke 都明確確認沒有惡意活動的跡象。這是一場更基礎、更無趣、也更難修的東西:伺服器自己壞掉了。
一、不是被駭,是伺服器自己下線微軟最初對外的說法是「基礎設施出現異常高負載」。這個說法聽起來平淡無奇,但 SecurityWeek 的報導補上了關鍵細節:問題不是整體流量突然暴增,而是大量伺服器意外變成不可用,剩下來的伺服器被迫承接原本不該由它們扛的流量。
更關鍵的是「為什麼會變成不可用」。微軟的說法是:部分伺服器沒有通過自動執行的健康檢查,因此被系統判定為離線。這是一個很微妙的故障型態——不是機器燒掉,不是程式崩潰,而是監控機制自己說「這個節點沒問題」之前的那個環節先壞了,導致一批其實仍然活著的伺服器被整批踢出輪替。剩下來的節點吃下全部流量,於是雪崩。微軟接著承認部分近期的配置變更可能與故障有關,並開始回滾一段與故障起始時間點吻合的網路配置變更。同時暫停所有部署與配置變更、重啟受影響伺服器、重新分配全球基礎設施的連線流量。SecurityWeek 引述微軟的說法:一個負責建立安全連線的處理程序過載,導致受影響的伺服器停止處理請求。到 11 月 13 日上午,微軟先說修補「邊際成功」(marginal success),半小時後又說「流量最佳化動作帶來了服務穩定性與容量的正面結果」。這兩個句子聽起來像好消息,但對照後續發展就很明顯——這是一個還沒收尾的案子。
二、74 個國家,一小時之內
Downdetector 的官方統計是這場災難最清楚的時間軸:
- 16:17 UTC:Exchange Online 事件正式起算
- 17:25 UTC(紐約 12:25):Outlook 的用戶回報開始攀升
- 18:25 UTC:回報量約為五倍
- 21:43 UTC(倫敦 17:43):英國回報暴增十倍
- 23:21(印度當地時間):印度開始回報
- 11/13 06:55(紐西蘭當地時間):最遠端的紐西蘭也開始回報
Downdetector 特別指出,17:00 到 18:55 UTC 之間,接近三成的回報來自美國境外。微軟一開始說故障發生在「美洲地區」,這個說法在幾個小時內就站不住了。具體到服務層面,微軟狀態頁列出的受影響元件包括:Exchange Online、Microsoft Teams、SharePoint Online、Microsoft 365 Copilot、Microsoft Defender XDR、Microsoft Planner、Microsoft To Do,以及部分使用者的 OneDrive;部分管理員連 Microsoft 365 管理中心都進不去。IT之家則指出,這次宕機連帶波及 OpenAI 與 Anthropic 人工智慧服務所使用的連線元件——兩個 AI 服務商的後端連線,同一天掛在同一家基礎設施供應商身上。相較之下,Google 系服務大致正常:Gmail、Google Docs、Google Meet 運作無礙。有人在 Instagram 上拍下自己躺著、头顶浮現「Outlook」字樣;另一支影片裡則是坐在桌前用筆電、头顶浮現「Gmail」。Threads、X 與 LinkedIn 上還流行起一個梗——把 Microsoft 365 改名成 Microsoft 364,因為「軟體公司變暗的那一天」。
三、第一批受害者:政府、醫院、銀行與機場真正讓這次故障從科技新聞變成公共基礎設施事件的,是受影響的對象清單。
日本政府的服務在故障當天就停擺,副內閣官房大臣 Masanao Ozaki 在記者會上表示,公務員的因應方式是開始手寫紙本文件,多數部門整個工作日都無法寄出郵件。菲律賓最高法院則透過 X 表示,期間回覆郵件與其他往來的處理都會延遲。澳洲的學校、法院與政府機關同樣在週五早上開天窗,澳洲情報機關與聯邦警察都被列入受影響名單。
英國的醫療系統是最受關注的一環。全國醫師協會(National Pharmacy Association)發表聲明表示,NHS 郵件系統中斷影響了藥局與家庭醫生(GP)之間的溝通,部分需要藥師回頭聯絡開立處方的醫師才能確認細節的複雜處方,病患可能拿不到藥。英國醫護工會(GMB)則稱這次中斷對救護車服務與 NHS 基金會有「嚴重影響」,雖然緊急與危及生命的派遣未受影響。英國國會的議員也回報無法透過議會帳號使用微軟產品,英國警方則表示線上表單提交可能受影響,幸而情報系統使用獨立架構,沒有被波及。
香港的情況由銀行業說出最具體:Morgan Stanley 與 Goldman Sachs 的員工從一進門就無法收發郵件或使用 Teams,整個午餐時段都無法處理,「偶爾有些信進來,但大概還有數百萬封積壓要處理」,一位銀行員如此說道。德國 Deutsche Bahn 表示 Outlook「嚴重遲緩」,導致改點資訊的分發受到嚴重限制。VIA Rail Canada 提醒旅客可能收不到行程相關郵件,請改用網頁版乘車資訊或訂閱簡訊。航空業方面,IndiGo、Akasa Air 與南非 CemAir 都回報郵件客服或系統受影響,不過三家都表示航班運作未受影響,印度航空(Air India)更幽默地說:「郵件可以等,這是規劃假期出發的提示。」在美國,多個城市政府出現對外信箱全面中斷,包括 Miami Beach、Austin、Jacksonville、Baltimore County,以及加州的 Pasadena、Fremont、Burbank 與 Santa Barbara;科羅拉多州 Arapahoe 警長辦公室表示,連** Prisoner 的保釋金支付都被延後**。底特律電動車廠 Workhorse Group 則直接宣布,把第三季財報電話會議延到 11 月 16 日,理由寫得很直白:「全球微軟故障造成的業務中斷。」而這些中斷還催生了第二波風險:多家銀行發出詐騙警告,包括渣打(Standard Chartered)新加坡、ING 澳洲與昆士蘭銀行,提醒客戶提防有人假冒微軟技術支援要求提供帳號資料、一次性密碼或點擊不明連結——因為連 email 掛掉時,人最容易相信「有人要幫你修」。
四、為什麼修了 12 小時還修不好
Hacker News 上被標記為「史上最具破壞力的商用郵件中斷」這句話,出自《The Pragmatic Engineer》作者 Gergely Orosz:「對一個有超過一億使用者的服務來說,全球性故障的緩解花了 12 個小時以上,這非常罕見……我記不起有哪一次跟商業郵件有關的中斷花這麼久才恢復正常。」他點出的關鍵,在於恢復「服務容量」不等於恢復「服務正確性」。微軟的做法是把流量小心翼翼地重新引進來,這是為了避免出現「已經寄出的信、來自 Gmail 等未受影響信箱的信,在修好之後才突然湧到收件人信箱」這種第二波混亂。但這也意味著每一步都必須極度保守:不能一次把流量灌回去,否則剛喘一口氣的伺服器會再次被打垮。
HN 上另一位網友 Arbortheus 用真實流量做了實測。他的公司用 Graph API 輪詢數百個 Microsoft 365 租戶,17:33 UTC 就偵測到第一波 5xx 錯誤,到 11/13 09:44 UTC 撰稿時仍未恢復,累計中斷 16 小時 11 分。他對照微軟《Service Level Agreement for Microsoft Online Services(WW)》2026/10/01 版的 Exchange Online 條款換算:Uptime 低於 99.9% 給予 25% 服務信用、低於 99% 給 50%、低於 95% 給 100%,而 16 小時 11 分的中斷換算下來是年度 SLA 99.82%、當月 SLA 97.78%——後者落在 50% 信用這一級。澳洲墨爾本大學的電腦科學教授 Toby Murray 與 RMIT 的 Mark Gregory 則從宏觀角度切入。Murray 說 Outlook 與 Teams 是「關鍵的全球商業基礎設施」,這次故障「極其廣泛,且其後果遠遠超出能不能收發工作郵件」;Gregory 則直言,在 CrowdStrike 事件與其他幾次故障之後,一家像微軟這樣的公司還能發生全球性故障,是「不可思議的」。
五、這不是第一次把時間軸拉長看,會發現微軟的 Exchange Online 早已不是第一次進入全球新聞。
SecurityWeek 在報導中特別點出,本次故障是「近期一系列網路配置變更」的一部分,微軟正在回滾其中一段。而在 2026 年更早之前,Exchange Online 已經多次單獨出事:8 月底至 9 月初那次大規模中斷,Exchange Online 直到 48 小時後才完全恢復;9 月 4 日 BleepingComputer 再度報導 Exchange Online 出現郵件延遲與「Server Busy」錯誤;3 月則有一次因新導入的虛擬帳號(virtual account)變更,導致行動版與 Mac 版 Outlook App 無法存取郵件,微軟花了數天才完成回退。
同一個元件、同一種「配置變更引入的連線層故障」、同一種要拖上數十小時才收掉的修法。 這些案例彼此獨立地發生,可以理解成巧合;但把它們排在一起看,就很難再用「單一事件」來解釋。微軟在事件中段的公告措辭也透露了心態。官方 X 帳號一度寫道:「我們已監測為改善服務可用性而套用的變更狀態,確認它們並未如預期運作……我們正在辨識可以套用的替代工作流,以在持續的流量管理失衡下提升容量。」——這句話本身就說明:前一輪的嘗試,沒有用。
為什麼這件事重要
第一,這是「集中度風險」最教科書式的一次示範,而且它發生在所有人都以為自己已經有備案的那一層。 過去幾年,企業談數位韌性的時候,預設情境是「雲端掛了,我切到本地」——但這次中斷的落點不是你的資料庫,是你的郵件與身分驗證。HN 上有多位網友指出這一點:郵件不是「其中一項應用程式」,它是流程的骨幹。日本政府拿紙本出文件、美國警長辦公室的保釋金支付延後、英國藥局聯絡不到 GP——這些全都說明一件事:當一個組織把流程設計成依賴單一供應商時,它依賴的不是那個供應商,而是那個供應商在壓力下的行為。
第二,這次故障的形態會愈來愈普遍。 微軟自己說了原因:大量伺服器因為沒有通過自動健康檢查而被判定離線。這是所有大型雲端系統的共同弱點——自動化愈多,監控愈複雜,而「監控本身失效」這個失效模式,是在設計監控的時候最容易被當成不可能發生而略過的。微軟不得不先停用健康檢查、改用替代方法驗證,才終於把伺服器一批批救回來。HN 網友 solid_fuel 的觀察更尖銳:他說這些狀態更新「讀起來有種 LLM 驅動的代理人搞不定複雜系統的的味道」——這是未經證實的揣測,但它精準指出一個真實風險:用 AI 加速維運的系統,會讓「系統壞掉」與「AI 修不好系統」兩件事愈來愈難以區分。
第三,它把「技術主權」從口號變成成本表。 CNN 特別把這次故障放在歐洲減少對美國科技依賴的脈絡中:法國總理 Sébastien Lecornu 今年早前已宣布政府官員棄用 Zoom 等美國視訊工具,改用法國自有軟體。Capital Economics 首席經濟學家 Neil Shearing 說「歐洲的網際網路基本上是一個美國建構、美國系統」,而科技記者 Jacob Ward 說:「我認為這對每個人來說都是一個警醒——我們在享受這些雲端系統便利的同時,對它們有多脆弱,可能有多麼不自覺。」在此之前,這是地緣政治與採購的議題;現在,它是每個歐洲政府的資訊長都要寫進風險報告的東西。
第四,OpenAI 與 Anthropic 同日受波及這件事,值得單獨標記。 兩家 AI 服務商的後端連線元件,都壓在同一個基礎設施供應商的同一套設定變更上。這說明「AI 產業已經不需要雲端巨頭」這種敘事在基礎設施層面完全不成立:AI 公司是雲端最大的消費者,也是雲端最脆弱環節的繼承者。當基礎設施出事,AI 服務的可用性取決於它們跟誰共用同一段管線。
數據解讀與質疑
質疑一:「74 個國家」是回報數,不是受影響人數。 這個數字來自 Downdetector,而 Downdetector 的機制本質是「願意回報的人數」。BBC 的記者自己也點出這個限制:Downdetector 只告訴你「有多少人使用這個網站並回報」,如果你中了但沒回報,系統完全不知道。以微軟官方說法,Microsoft 365 有 4.3 億使用者,因此「74 國」與「4.3 億人」之間的落差,才是真正的規模。BBC 引述的數字是 07:00 GMT 的 43,000 筆回報,Downdetector 官方則說 Outlook 的回報峰值達到平時的 2,000 倍以上——倍數比絕對值更能說明這次的異常程度。
質疑二:官方說法前後不一致,這件事本身值得記錄。 CBS News 在週四晚間報導,微軟當時已對外表示「我們已確認影響已經解除」,並引用微軟 16:14 ET 的貼文說「已將受影響基礎設施恢復到健康狀態」,隨後又說仍在「重新平衡流量」。但到了週五,CNN 與 BBC 的報導都是故障仍在進行中,微軟 365 Status 官方帳號的措辭變成「邊際成功」,BBC 則引述官方說法為系統健康「仍然不穩定」、流量正在「謹慎地重新引進」。同一個事件裡,「已解除」與「尚未持續恢復」兩種說法都出自微軟。 這不代表任何一方說謊——自動化的健康檢查與流量重新引進本來就可能給出過度樂觀的訊號——但讀者應該把「微軟宣布解除」與「使用者回報恢復」當成兩件事,而這次顯然是後者落後於前者。
質疑三:根因還沒有被官方公布。 目前對外說法只有三層:伺服器大量變成不可用、健康檢查失敗、近期配置變更可能相關。SecurityWeek 提到的「負責建立安全連線的處理程序過載」是引述微軟的說法,但仍屬機制描述而非根因分析。微軟承諾「緩解後將提供根因、深度防禦修復項目等完整細節的事故報告(Post-Incident Report)」——這份報告還沒出來。在它出來之前,任何關於「就是某個設定改壞了」的斷言都只是推測,包括社群流傳的各種版本。
質疑四:SLA 的門檻低到值得注意。 HN 上的討論提出了兩個方向相反的觀察。一方面,Arbortheus 的實測顯示這次的當月 SLA 可能落在 50% 服務信用那一級;另一方面,有網友指出 99% 的可用性對郵件服務而言,等於每年有 3.5 天不能收發信——而 99.9% 才剛好是一年約 8.7 小時。從「服務信用」的角度,這是可計價的商業損失;從「服務品質」的角度,一個人人都知道公司停擺要靠電話通知的關鍵基礎設施而言,這個門檻寬鬆得驚人。SLA 是合約,不是可靠性。
質疑五:最容易被忽略的風險,是後遺症而不是故障本身。 中斷期間同時是詐騙的高峰期——多家銀行同步發出警告不是巧合。當一整個組織的「正常驗證管道」(收到真實郵件、收到真的驗證碼)同時失效,員工對異常訊息的免疫力會顯著下降,而這些人往往同時失去了可以立刻求證的管道。
Siami 觀點這次故障最值得記錄的部分,可能不是它有多嚴重,而是它有多普通。沒有資安攻擊、沒有超大規模的資料損毀、沒有罕見的天災、沒有明顯的人為操作失誤。走完整條因果鏈,得到的是:一次配置變更,一批伺服器的健康檢查沒有正確回報,剩下來的節點過載,而修復的每一步都必須保守到不能出錯。這是大型雲端系統在正常運作數年後,會自然長出來的病。真正殘酷的是時間分布。微軟官方說明裡那句「部分近期配置變更可能與此有關」,意味著類似的風險從來沒有消失過——它只是潛伏著,等待下一個「剛好時間點吻合」的部署。而且 2026 年這一年,Exchange Online 已經用配置變更相關的方式出事太多次了:3 月的虛擬帳號、8 月底到 9 月初長達 48 小時的中斷、9 月的 Server Busy、11 月這次。每一次的技術形態都不完全一樣,但每次都是同一個元件、同一種變更、同一種長拖數十小時的修法。 這已經不能單獨用巧合解釋了。另一件值得留心的事,是故障期間 AI 角色的尷尬位置。微軟自己的修復過程裡,被拿來繞過失效健康檢查的是替代驗證方法;而同一天,OpenAI 與 Anthropic 的連線元件也一起掛掉。HN 上一則留言把這個巧合說得最妙:「微軟修不好 Outlook 是因為他們沒有 Claude,而 Anthropic 的員工因為登不進 Outlook 所以修不好 Claude。」這句話是玩笑,但它指出一個真實的結構:當整個產業的關鍵服務都建在同一層基礎設施上,基礎設施的故障會變成產業的系統性風險,而不是個別服務的可靠性問題。
至於整個事件最該被記住的一句話,或許來自一個很簡單的觀察。有人在故障當天把自己的信箱放在便宜的 VPS 上,多年如一日穩定運作,留言說:「我自託的郵件伺服器,過去十年的 uptime 已經比 outlook.com 還好了。」多數人會說這是業餘者的浪漫、不具規模效益——而 HN 上也有人老實回應:「你自己架郵件伺服器大概有很多好理由,但看來我自架的那台,過去十年的 uptime 真的比 Outlook 好 :-D」這場辯論永遠不會有結論,因為真實答案取決於你的組織把多少流程壓在郵件上。但這次故障至少把選項的成本,往前挪了一格。最後,Siami 想留一個不太舒服的觀察。BBC 在直播這場故障時,邀來的是英國政府的數位部門官員;CNN 的報導裡,日本政府官員在記者會上說,公務員開始手寫紙本文件。二十年前,這聽起來像科幻小說;今天它只是一個工作日的上午。替代方案不是不存在,而是相關技能已經被集體遺忘。 一旦某天真的需要用回紙本,會發現它需要的不是意願,而是一整批已經轉行去做別的事情的人。
延伸閱讀
- Microsoft 365 服務狀態中心(事件 EX1550543/MO1550821)|官方一手狀態記錄,故障元件清單與所有更新時間點
- Microsoft 365 Status 官方 X 帳號|確認「變更並未如預期運作」的關鍵公告
- Downdetector 官方統計貼文|74 國、各時區回報暴增倍數與美國境外占比的原始數據
- Downdetector:Microsoft 365 即時狀態頁|回報量與問題分布的地圖
- SecurityWeek〈Microsoft 365 Outage Disrupts Outlook, Exchange Online and Teams〉|健康檢查失敗、配置變更回滾與安全連線程序過載的細節
- BBC News 直播:Microsoft outage updates|NHS、藥局、國會、警方與 Gergely Orosz 的完整訪談
- CNN Business 直播:Microsoft outage live updates|日本、菲律宾、香港金融業與英國 NHS 的第一手案例
- IT之家〈微软 365 核心服务全球性大规模瘫痪〉|中文來源,含 OpenAI 與 Anthropic 連線元件受影響的細節
- Reuters〈Microsoft scrambles to restore services as major outage hits〉|國際線第一手報導
- BleepingComputer:8 月底至 9 月初的 Exchange Online 長時中斷|同類型故障的前例,48 小時後才完全恢復
- Hacker News 討論串(296 分/195 則回覆)|SLA 實測換算、AI 輔助維運的風險、單一供應商依賴與自架郵件的完整辯證
- YouTube:NBC News〈Widespread outage of Microsoft apps used by hundreds of millions〉|NBC News 官方頻道的現場報導
網友熱門留言 (6)