編按:本文綜合整理自 Google 官方發表稿〈Introducing Gemini 4 Hydrogen for Agentic Workflows〉、Google Antigravity 部落格〈Gemini 4 Hydrogen and Orchestrator〉、Ars Technica〈Google rolls out Gemini 4 Hydrogen, finally replacing 3.8 Flash〉、The Decoder〈Google’s Gemini 4 Hydrogen outscores the bigger Argon just four weeks after its launch〉、Google AI Studio 開發者文件〈What’s new in Gemini 4 Hydrogen〉、Google DeepMind〈Gemini 4 Hydrogen Model Card〉、9to5Google〈Google announces Gemini 4 Hydrogen with significant leaps in speed, intelligence〉、DeepMind 資深副總裁 Koray Kavukcuoglu 的 X 貼文 與 Hacker News 討論串(541 分/330 則回覆),並加入 Siami 編輯部觀點與分析。文中所有基準分數、價格與模型卡條款均引述自上述一手來源;Hydrogen 於 11 月 12 日上線,截至發稿尚未有第三方長期使用報告。
2026 年 11 月 12 日,Google DeepMind 資深副總裁兼首席 AI 架構師 Koray Kavukcuoglu 在官方部落格發表 Gemini 4 Hydrogen。這不是一次邊緣性的模型更新——它是 Google 把「Flash」這個名字徹底埋葬的動作。Hydrogen 接替 Gemini 3.8 Flash,橫掃 Google Search、Gemini App、AI Studio、Android Studio、Gemini for business 與 Antigravity,同時也是 Gemini 4 家族三款模型裡唯一一款「一開始就對所有人開放」的成員。
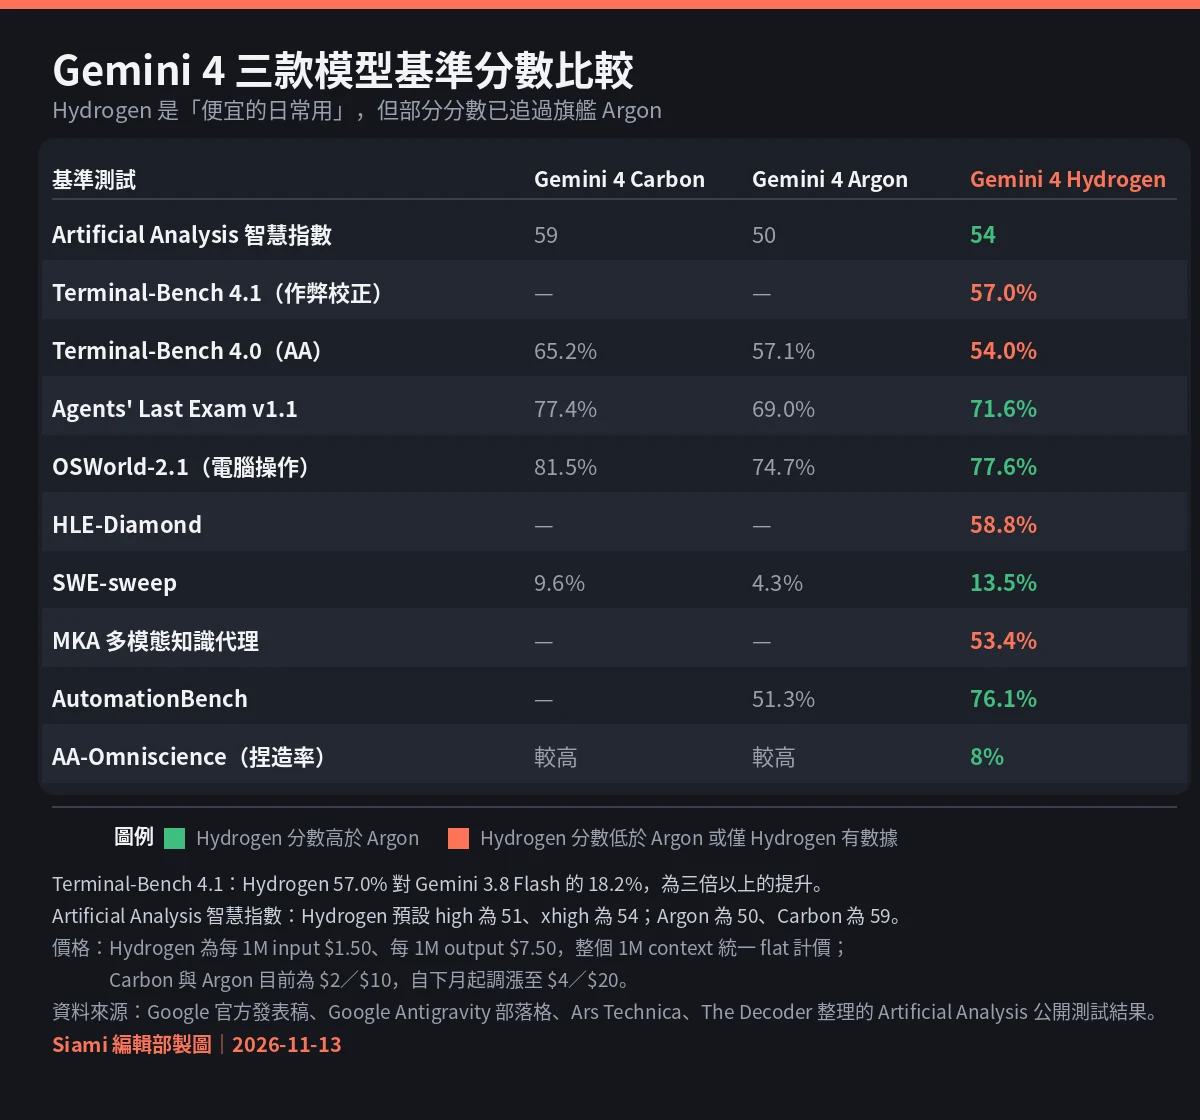
更耐人尋味的數字是:在 Artificial Analysis 智慧指數上,這款被官方定位為「日常執行用」的模型,在預設思考層級拿到 51 分、xhigh 層級 54 分,反超了旗艦 Gemini 4 Argon 的 50 分。Argon 是 Google 在三週前才開放給開發者的中階模型。而 Carbon——真正的最強模型——在 xhigh 也只有 59 分。The Decoder 的標題寫得很直白:Argon 上市不到四週就可能變成過氣產品。
一、三層模型同時在架上,Hydrogen 反而最便宜
Google 這次的產品線結構是:Carbon 負責最困難的架構判斷、除錯與資安稽核,屬於「燒 token 也要想清楚」的前沿模型;Argon 處理大多數長週期任務但更省 token;Hydrogen 則是執行層——寫程式、跑測試、驗證變更。
Hydrogen 是從 Carbon 改寫而來的。官方模型卡寫得很直白:「Gemini 4 Hydrogen is adapted from Gemini 4 Carbon」,訓練資料集與訓練資料處理方式都沿用 Carbon 的說明。這意味著它不是從零訓練的新模型,而是同一條技術路線上往「速度與效率」方向調校出來的分支。
規格面上有三個關鍵數字:
- 1,048,576 token 統一 context window——輸入、思考與輸出共用同一個視窗,不是「輸入 1M 加上另外 1M 輸出」
- 最長 100 萬 token 輸出——透過 background execution 或 client-side continuation 達成,預設同步輸出上限為 64K
- 四個思考層級:low、medium、high(預設)、以及新增的 xhigh
價格是全篇最關鍵的一條:每 1M input $1.50、每 1M output $7.50,整個 1M context 統一 flat 計價,快取命中為 $0.075。這代表長文件與長對話不會因為超出某個門檻就跳價。Hydrogen 的 API 定價跟 3.8 Flash 相同,cache hit 更是只有 $0.075。
相較之下,Carbon 與 Argon 目前是 $2/$10,下個月開始調漲到 $4/$20。也就是說 Google 正在把旗艦層的價格拉高,同時用一個幾乎不漲價的執行層去承接大部分流量。
二、官方數字:快三倍、準五倍
Google 官方發表稿給出的對比基準都是 Gemini 3.8 Flash:
- 預設 high 層級下,完成任務快 2.5 倍
- Terminal-Bench 4.1 分數從 18.2% 拉高到 57%,超過三倍
- 捏造內容(fabricated claims)減少逾 5 倍
- 工具呼叫失敗或搜尋回傳空結果時,能乾淨地重新調整策略,而不是硬猜
- 合作夥伴在複雜圖譜、SQL 與資料密集型企業工作流測試中,速度快 2 到 2.8 倍,token 用量減少 12% 到 23%
其他基準測試的官方數字包括:HLE-Diamond 58.8%(領先同級)、Vals Tax Agent Bench 52.3%(整體第一)、Vals Legal Research Bench 55.8%(並列第一)、AutomationBench-AA 領先同級、多模態知識代理 MKA 53.4%、Agents’ Last Exam v1.1 71.6%,以及在 arena.ai 的即時基準 Agent Arena 上排名第五。
安全面的數字同樣被列在發表稿裡,值得單獨記錄:
- agentic 任務中的越界行為減少最高 81%,服務不足減少最高 79%
- 工具使用與程式設計評估中,錯位行為與任務走捷徑減少 12 倍
- 遇到不可能或被阻擋的任務時,繞過權限邊界的機率降低 2 倍
- 內部 agent 誠實度評估達 96.7%
- 20 萬次以上稽核回合中,99.9% 的思維鏈可讀性,零欺騙性推理編輯
- 對抗間接提示注入的 Gray Swan IPI 基準,抗性提升逾 2.3 倍
- HealthBench Pro 的誤拒率低於 0.4%
模型卡也誠實標註了幾件事:知識截止日期為 2026 年 3 月;在更高思考層級「可能會使用更多 token 來最大化表現」;偶爾會有延遲或逾時;模型卡同時承認仍可能出現一般性幻覺。
三、Orchestrator:多模型協作第一次變成預設
Hydrogen 同步帶來 Google Antigravity 裡的一個新選項 Orchestrator。官方描述它的設計動機很直白:業界常見做法是「靜態模型路由器」——從第一句 prompt 猜測任務難度,然後把整個任務丟給最便宜的可用模型。但當 agent 執行時間拉長,難度會在過程中改變,靜態路由就會崩掉。
Orchestrator 採取的是動態雙向切換:Carbon 可以先用唯讀模式探索相依關係、釐清歧義並產出具體計畫;接著交給 Hydrogen 寫程式、更新套件、跑測試;一旦 Hydrogen 遇到阻力,就交回 Carbon 檢查狀態、修補計畫再續跑。官方數據是:在 Terminal-Bench 4.0 上,Orchestrator 達到接近 Carbon 的任務成功率,同時平均少用 24% 名額、快 19% 完成。
Carbon 也可以當協調者,讓 Hydrogen 平行擔任 worker 與 verifier 代理,在各自隔離的工作區裡同時建置與測試。Antigravity 官方示範了一個用 Antigravity SDK 搭的開源 issue 分流系統:Hydrogen 代理處理分流與撰碼,Carbon 代理負責較大的重構、新功能與安全檢查。
這裡有一個容易被忽略的結構性變化:Hydrogen 已經是 Antigravity agent 的預設模型。AI Studio 文件寫得很清楚:「The Antigravity agent now uses Gemini 4 Hydrogen by default」。也就是說,用 Antigravity 的人不需要做任何選擇,就已經在用 Hydrogen。
四、Search 才是這次真正的重頭戲
Google 官方把這次 Search 更新稱為「AI 搜尋工具史上最大的一次升級」。Hydrogen 在 Search 裡做的事包括:
- 用更進階的推理理解「使用者的真正意圖」——包含多段式問題、錯字與高度具體的要求
- 產生更視覺化、更容易掃讀的回應
- 改進 query fan-out 技術,連出更廣泛的相關連結
但 Ars Technica 記者 Ryan Whitwam 在報導裡直接標上了懷疑:「but we’ve heard that from Google before.」這句話背後有前科——Google 過去多次宣稱 fan-out 改進能帶來更多相關連結,實際結果卻不一定顯著。
值得注意的是開發者可用性的落差。Ars Technica 指出:Hydrogen 已經上線給 Google AI Pro 與 Ultra 訂閱者,但 AI Plus 與免費用戶在 Gemini App 裡仍停留在舊的 3.5 Flash-Lite。Google 官方的 X 貼文則寫「✨ Everyone: @GeminiApp, Google Search, and @GoogleAIStudio」。這兩份說法在「Gemini App 的模型下拉選單到底給誰」這件事上並不完全一致,值得讀者自己進產品裡確認。
五、命名亂局與社群反應
Hacker News 討論串累積 541 分、330 則回覆,是當日最受關注的 AI 發布之一。討論的焦點分兩條線。
第一條線是命名。多位網友指出 Gemini 4 的元素命名邏輯互相矛盾:按字母序應該是 Argon → Carbon → Hydrogen;按原子量或宇宙豐度應該是 Hydrogen → Carbon → Argon;而實際的智慧排序卻是 Carbon → Hydrogen → Argon。fastball 的建議是用惰性氣體命名並把前三款放在序列中間,為未來更大或更小的模型留空間——他甚至替 Google 把槽位都排好了:氩、氪、氙,留一個氡給真正超大的模型,兩個更小的槽位留給可以在任何消費裝置上跑的模型。
第二條線是實際體感。onlyrealcuzzo 的評價最直接也最不留情面:他們把 pass@1 那種沒意義的基準分數拉上去,換來 p90/99 表現變差——越界、過度運作、做出與要求相反的結果、做了完全無關的事,而這些正是 agentic 工作流裡每週都會撞到的。同一篇留言還補了一句:「10 mostly random benchmarks. Really?」
另一邊,krmmalik 的使用經驗完全相反:他讓 Opus 跟 Fable 找程式碼裡的隱蔽 bug,兩個模型都說沒事、是他想太多,最後是 Argon 真正挖到底並做出修法。他並認為 Gemini 系列的「AI 腔」比 ChatGPT 與 Claude 少。
至於把 Hydrogen 當日常主力的人,則碰到了另一類問題。tobias2014 描述了他在 command line 呼叫 Antigravity CLI 被連續停權的經歷:客服表示什麼都做不了,連原因都不肯說,只丟給他一個沒有任何文字輸入框、只有一個「我理解 TOS,請勾選」的申訴表單,勾完自動通過,用一個 prompt 後再次停權。
Simon Willison 則做了一件很有工程價值的事:讓 Carbon、Argon、Hydrogen 各畫一隻鵬鶘,用同一個 Markdown SVG 渲染器視覺化比較。他的結論是「Surprisingly plain pelicans for a Gemini model」,並附上三方的並排比較圖——他特別指出 Carbon 與 Argon 售價相同,因此兩者的 token 用量差異可以直接比較,而 Google 官方說法是 Argon 比較省 token。
為什麼這件事重要
第一,這是模型分層策略的一次實質反轉,而且是往「民主化」的方向反轉。 Google 前兩款 Gemini 4 模型走的是極度保守的路線:Carbon 先從資安研究員開放,一般可用性也只給最高價訂閱層。Hydrogen 反過來——一開始就對 AI Studio 免費層、Gemini API 全部方案與 Google 產品線開放。Ars Technica 用了一句話點出差別:Hydrogen 沒有拿到 Carbon 與 Argon 那種「緩慢且_security-conscious」的發布待遇。這意味著接下來幾個月,整個生態系會有大量開發者第一次用上「跟旗艦同級的智慧」當日常預設模型。
第二,「更便宜的那個打贏旗艦」這件事本身,會改變企業的模型採購邏輯。 Argon 上市不到四週就被自家成本更低的 Hydrogen 在多項基準上超越——這在模型發布史上相當罕見。過去企業選模型的邏輯是「最弱的那個能不能撐住」,Hydrogen 逼著這個邏輯變成「花多少 token 錢能換到多少可靠性」。更關鍵的是 Carbon 與 Argon 下月要漲到 $4/$20:Google 正在把旗艦層變貴,同時提供一個幾乎不漲的執行層,等於是用價格把流量從旗艦導向 Hydrogen。
第三,Orchestrator 讓「多模型協作」從工程選項變成產品預設。 過去要讓不同模型分工,要自己寫路由邏輯、自己判斷任務難度、自己在失敗時接手。Google 現在把這整套東西收進一個下拉選單裡,而且有官方數據撐腰(Terminal-Bench 4.0 上接近 Carbon 的成功率、少 24% 名額、快 19%)。這件事的意義不在 Google 多了一個功能,而在于它把「模型選擇」從開發者每天都要做的瑣事,變成平台替使用者做的決定——而平台的決定,通常是成本導向的。
第四,Google 在 Safety 數字上花的心力,本身就是一個訊號。 81% 越界下降、96.7% 誠實度、99.9% 思維鏈可讀性、20 萬次稽核回合——這些數字不是給安全審查者看的,是給每天要把 agent 放進生產環境的工程師看的。在一個「模型每天升級、prompt injection 每天進化」的年代,把「會不會繞過權限邊界」量化成「2 倍機率降低」,是把安全從口號變成可比較規格的做法。
數據解讀與質疑
質疑一:所有最亮眼的數字都是 Google 自己測的。 57% 的 Terminal-Bench 4.1、2.5 倍速度、5 倍捏造率下降、81% 越界下降——全部出自 Google 自己的發表稿與模型卡。外部第三方目前只有 The Decoder 引述的 Artificial Analysis 數據,而那一組數字對 Hydrogen 的評價明顯更保守也更矛盾:Artificial Analysis 的獨立測試把 Hydrogen 在 xhigh 層級放在 54 分,與 Claude Sonnet 5.5 同級、略低於 GPT-6.1 Sol;但在 AA-Omniscience 上「只會有 8% 的時間編造東西」,這是相當漂亮的一項。
質疑二:Hydrogen 在 agentic 終端工作上是弱項,而且弱得不小。 The Decoder 整理的資料顯示:Hydrogen 在 Terminal-Bench 4.0 只拿 54%,Terminal-Bench-Science 0.1 只有 50%;同期 Claude Sonnet 5.5(max)是 64 與 53,GPT-6.1 Sol(max)是 56 與 58。換句話說,在「讓模型自己操作終端機」這類最接近真實工程工作的場景,Hydrogen 落後同級競品。這正好對應 onlyrealcuzzo 在 HN 上說的 p90/99 問題:官方公布的基準是平均值,而平均值恰恰是 agentic 場景裡最不該看的數字。
質疑三:xhigh 的成本會讓「最聰明的那個設定」變得不划算。 同一份報導指出,xhigh 把智慧指數從 51 拉到 54,但需要接近 high 兩倍的輸出 token,平均每任務成本從 $1.87 上升到 $3.16。The Decoder 的性價比結論是:Hydrogen 在 xhigh 下每任務約 $3.16,大約是 Claude Sonnet 5.5(max)同等智慧水平成本的三分之一,卻是 GPT-6.1 Sol(max)的 2.5 倍。這是同一則數據的兩面:Hydrogen 未必是最便宜的聰明模型,但它確實是「這個價格帶裡最聰明的」。
質疑四:模型卡自己承認的定位問題。 Google DeepMind 對 Hydrogen 做過 Material Capability Change 評估,結論是「相較於 Gemini 4 Argon,Hydrogen 並未在通用能力上展現實質提升」,因此不需要跑完整套關鍵能力評估。換句話說,官方自己認為 Hydrogen 在能力上就是 Argon 的同級替代品,它在 AA 指數上超越 Argon 是靠更高的預設思考層級與更好的執行效率,而不是模型本身的智能躍升。The Decoder 那句「Argon 上市不到四週就過時了」在這個框架下要重新理解:Argon 不是被更好的模型取代,是被更便宜的自己取代。
質疑五:模型名稱的混亂是真的,而且正在產生實際成本。 一位 HN 網友(ComputerGuru)指出的是實際採購問題:Hydrogen 定價等於未打折的 3.8 Flash,遠高於大家現在實際付的價格,而當 3.8 Flash 的折扣在年底結束、3.7 又被靜默轉導到 3.8 Flash 之後,「很多既有企業 Gemini 客戶得把生意帶去別家」。當一個發布要同時解釋「三款模型的能力排序」與「Flash 系列去哪了」時,企業客戶的理解成本就是真實成本。
質疑六:Antigravity 的穩定性問題與模型能力無關,但可能擋住試用。 tobias2014 的停權案例發生在他「今天才升級到 Ultra」之後。若 CLI 呼叫被誤判為違反服務條款,那麼 Antigravity 這個被 Google 拿來展示 Orchestrator 與平行代理的主場景,實際可用性就會打折扣。官方目前沒有公開說法。
Siami 觀點
這次發布最值得記錄的,不是 Hydrogen 有多強,而是Google 願意讓「便宜的那款」成為預設。
2026 年整整一年,前沿模型的能力曲線一路往上,但價格曲線卻在同一時間往上彎。開發者被夾在中間:要更好的智慧就得付更高的價,而多數生產環境裡的任務根本不需要旗艦能力。Hydrogen 的做法是把這件事攤開——它不是最強的,但它在多項指標上已經越過「旗艦的一半價格」這條線,而且 Google 主動讓 Carbon 與 Argon 下月漲價,把流量導向它。
這背後有一個很現實的產業邏輯。當每一家的旗艦模型都貴到只有大公司用得起時,「日常用模型」這個位置就變成所有平台都在爭奪的入口。Hydrogen 把 1M context、flat 計價、四個思考層級、免費 AI Studio 層與 Search 全面更新一起推出來,賣的不是模型,是分發管道。Search 是 Google 最硬的護城河——每天數十億次查詢,每一則 AI Overview 都是一次模型能力的展示機會。
但也有兩個地方讓人保留。第一,Hydrogen 在終端操作與科學推理這兩項最接近真實工程工作的基準上是落後的,而且落後的幅度不小。這意味著「日常用」的邊界在哪裡,最終還是要由每一個團隊自己用真實工作負載去測,而不是看 AA 指數的分數高低。第二,HN 上那些抱怨 p90/99 的留言,目前都還只是初期體驗的第一印象;模型這種東西的穩定性需要時間才能量出來,而 Google 顯然很清楚這一點——所以這次連模型卡都一起放了出來。
最後留一個小小的觀察。Koray Kavukcuoglu 在發表稿裡寫的第一句話是「Hydrogen brings cutting-edge intelligence to everyone」。這句話在技術上完全成立——1M context、100 萬 token 輸出、四個思考層級、$1.50 起跳。但「everyone」這個詞今天已經沒有三年前那麼輕了。 因為能真正用上 xhigh 層級、需要 1M context 吃掉長文件、並且願意為了 19% 的完成速度多付 token 的使用者,在每一間公司裡都還是少數。Google 把模型送到每個人的手上是真的;把成本結構設計成讓「每個人」都用得起最聰明的那一檔,也是真的。但這兩件事之間的落差,就是 2026 年 AI 產業最真實的樣子:能力已經不是門檻,成本與整合才是。
延伸閱讀
- Google 官方發表稿〈Introducing Gemini 4 Hydrogen for Agentic Workflows〉|一手來源,含完整基準數字、安全指標與上線範圍
- Google Antigravity 部落格〈Gemini 4 Hydrogen and Orchestrator〉|Orchestrator 動態切換 Carbon/Hydrogen 的設計說明與 Terminal-Bench 數據
- Ars Technica〈Google rolls out Gemini 4 Hydrogen, finally replacing 3.8 Flash〉|國際線報導,含訂閱層落差與 Carbon/Argon 即將漲價的細節
- The Decoder〈Google’s Gemini 4 Hydrogen outscores the bigger Argon just four weeks after its launch〉|整理 Artificial Analysis 獨立測試與完整三模型分數對照表
- Google AI Studio 開發者文件〈What’s new in Gemini 4 Hydrogen〉|模型 ID、四個思考層級用法、長解碼與 API 範例
- Google DeepMind〈Gemini 4 Hydrogen Model Card〉|知識截止日期、Material Capability Change 評估結論與 CBRN/網安門檻說明
- Google 官方部落格〈Google Search gets a major upgrade with Gemini 4 Hydrogen〉|Search 端更新細節與 query fan-out 改進說明
- Koray Kavukcuoglu 的 X 貼文|Google DeepMind 資深副總裁的第一手發表宣告
- Google 官方 X 貼文的產品線分級說明|Everyone/Pro+Ultra/Developers 三層開放範圍原文
- Hacker News 討論串(541 分/330 則回覆)|命名亂局、p90/99 實測體感、Antigravity 停權案例與 Simon Willison 的鵬鶘比較圖
- YouTube:Google Gemini 官方頻道〈Gemini 4 Hydrogen is now available to everyone〉|官方發布影片
- YouTube:Google Antigravity 官方頻道〈Gemini 4 Hydrogen available in Google Antigravity〉|Orchestrator 與 Antigravity 內的實際操作示範
網友熱門留言 (5)