編按:本文綜合整理自 Claude Status 官方第一起事件紀錄、Claude Status 官方第二起事件紀錄、Claude Status 官方 Microsoft 365 connector 事件紀錄、Mashable〈Anthropic Claude down: Why it said it was unable to authenticate code〉、AGTP 的第一手用戶回報、Fastero〈Claude Outage History〉 與 Hacker News 討論串(416 分/340 則回覆),並加入 Siami 編輯部觀點與分析。文中時間點與服務範圍均以 Anthropic 官方事件紀錄為準;截至發稿,兩起重大事故的根因仍未公布。
2026 年 11 月 13 日,Claude 幾乎在同一天把兩種故障各演了一次。第一種是所有人都熟悉的「服務掛了」:登不進 Claude.ai、Claude Code 被登出、OAuth 請求失敗;另一種更麻煩,是表層看似恢復,但排程工作、文件與試算表、安全掃描等後台能力仍可能延遲、卡住,甚至直接被略過。
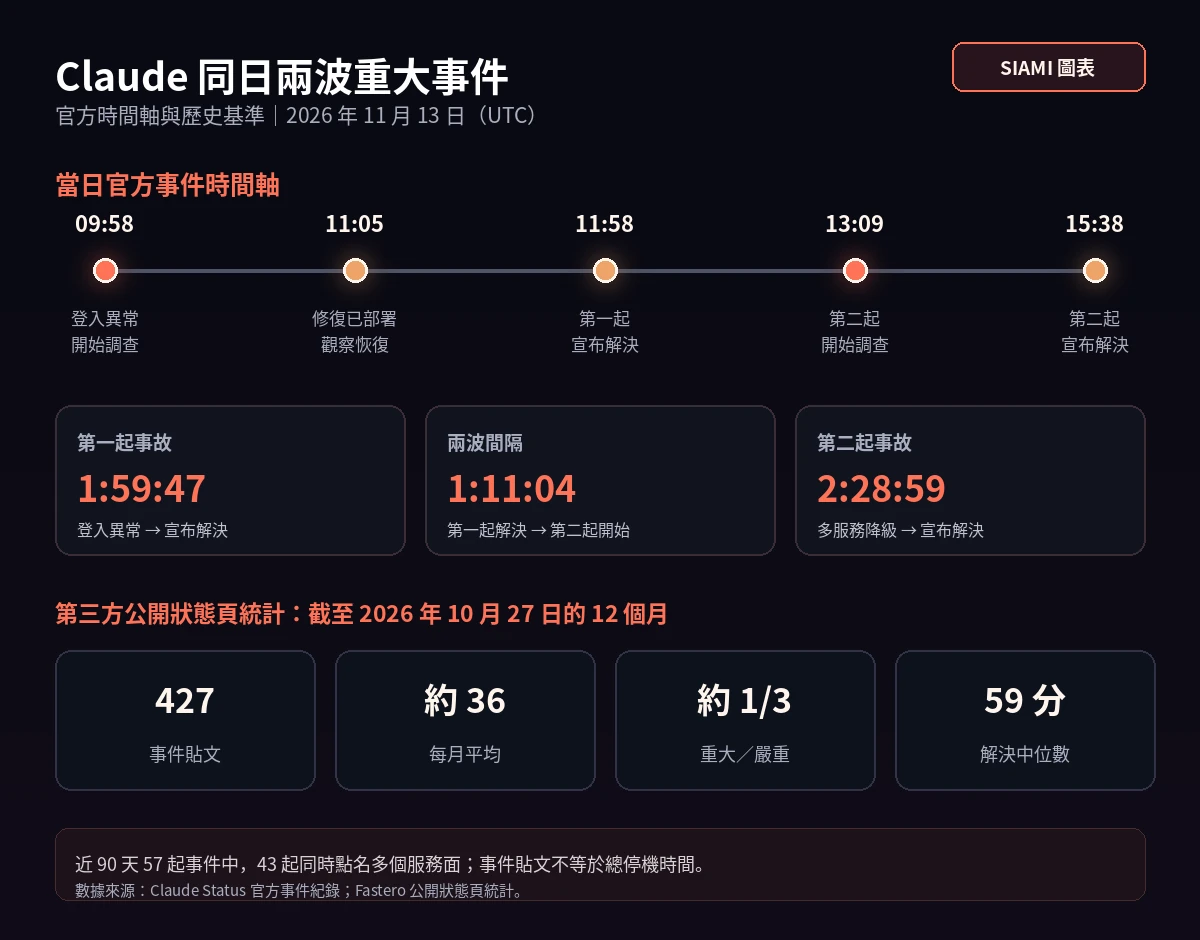
第一起重大事故於台北時間 17:58 展開。Anthropic 官方最初只寫:「正在調查使用者在 Claude.ai 與 Claude Code 驗證時遇到的問題。」約一小時後,修復部署完成,狀態進入觀察期;再過約 53 分鐘,官方宣布 Claude.ai 與 Claude Cowork 的問題已解決。從開案到結案,前後約 1 小時 59 分。
但第一起事故才剛關門,官方又在 13:09 UTC 開啟第二起重大事故:Claude.ai、Claude API 與 Claude Code 再度全面降級。範圍後來擴大到 Claude Docs、Claude Sheets、Claude Managed Agents、Claude Meetings、Claude Security、行動版與多個 connector。第二起直到 15:38 UTC 才宣布解決,前後約 2 小時 29 分。
兩起事故相隔僅 1 小時 11 分。這不是一場拖了兩小時的單一故障,而是同一晚接連兩場重大中斷。
一、第一起故障:表面是登入,底下是整條身分鏈
第一起事件最精準的官方描述只有一句:使用者在 Claude.ai 與 Claude Code 驗證時遇到問題。Mashable 在 10:46 UTC 發稿時表示,該媒體測試團隊仍能登入 Claude,但 X 上已有多名使用者回報登入困難;AGTP 也記錄到 Claude Code 進行中的工作階段被強制登出、/login 無法執行,以及「OAuth request failed」等訊息。
這代表故障未必等於「整個模型不能推理」。更精確的描述是:一部分工作階段已經存在,但身分驗證鏈無法完成,於是使用者看得到正在執行的內容,卻無法建立或維持新的工作階段。
Anthropic 的狀態頁把這起事件列為 major,影響記錄涵蓋 Claude.ai、Claude Console、Claude Code 與 Claude Cowork;其中 Claude Console 與 Claude Code 在事件最終元件狀態中列為正常,Claude.ai 與 Claude Cowork 則留下 degraded_performance 狀態。官方在 11:05 UTC 表示修復已部署並開始觀察,11:58 UTC 才正式結案。
換句話說,「修好」與「恢復」中間還隔著 53 分鐘。這段觀察期不是形式:它代表服務端要確認錯誤率、登入成功率與工作階段行為真的回到可接受範圍,而不只是程式碼已經部署。
至於根因,官方至今沒有說明。HN 上有人把故障直接歸因於同期 Microsoft 365 事故,也有人猜測 Claude Code、GitHub 與 Microsoft 同時異常代表它們共用某段基礎設施;但 Anthropic 只在另一項明確標示為 Microsoft 365 connector 的事件中說過,該問題由上游 Microsoft 服務事故造成。第一起驗證故障是否同源,目前沒有官方證據。
二、第二波更難纏:表面恢復,後台工作仍在積壓
第二起事故不能簡化成「又掛了一次」。它的官方時間軸呈現出一種更棘手的狀態。
- 13:09 UTC:官方開始調查 Claude.ai、Claude API 與 Claude Code 的降級
- 14:03 UTC:問題範圍擴大,Claude Docs、Sheets、Security 與 Managed Agents 都列入
- 14:36 UTC:Claude.ai 與 API 已見恢復,但 connector、Meetings、Managed Agents、Security 仍降級
- 15:33 UTC:主要錯誤回到正常,Docs 與 Sheets connector 也能運作,但新增 connector 暫時不可用
- 15:38 UTC:官方宣布多個服務面已解決
最值得注意的,是 15:33 UTC 那次更新中的一句話:排程工作與例程可能晚兩小時以上才執行,部分甚至直接被略過;Claude Security 的掃描、審查與專案設定也仍處於延遲狀態。
這揭示了 AI 服務可用性一個容易被忽略的層次。聊天介面回來,不代表工作排程器已把積壓補完;API 能回應,也不代表每一個延後的任務都會自動補跑。對一般使用者,這是「現在又好了」;對把代理程式接在排程器、CI、自動化流程上的團隊,這卻是一種更難察覺的狀態:服務看起來健康,但工作已經被跳過。
Siami 圖表整理了當日五個官方節點、兩起事故時長與間隔,以及 Anthropic 公開狀態頁的歷史基準;完整數字與時間線請見文內圖表。
三、HN 的真正爭議:服務可用性正在變成新的單點故障
第一起事故登上 Hacker News 後累積 416 分、340 則回覆。討論很快從「現在能不能登入」轉向更底層的問題:當工作流程被重新設計成依賴 LLM,供應商中斷是否已成為組織韌性的單點故障?
一位網友描述得很具體:他們公司約 20% 開發者用 Claude 做出三倍產出並包辦幾乎所有工作,另有 10% 完全不碰,其他人則只在部分任務採用。這種使用差異意味著,同一次故障對不同團隊的成本並不相同。對把模型當按一下按鈕的小工具的人,兩小時可能只是等一下;對把程式碼審查、文件、營運工作都交給代理程式的團隊,這可能是一整個工作日。
另一則留言點出更深的結構問題:不是每個人都需要「沒有 Claude 就完全不能工作」,而是整個組織是否把可用性壓縮成單一供應商。如果替代模型只是拿來臨時頂替,流程的資料格式、工具權限、提示詞與工作狀態能否無縫轉移,才是韌性的真正考驗。
討論裡也有人提醒,軟體品質不能因為 AI 提高產量就一起退步。AI 可能寫出更好的程式,但誰來找出那些測試沒有覆蓋、程式碼審查也漏掉的洞?如果仍要靠人工把關,那麼「30 倍產出」究竟省下了多少時間,還是只是把產出的技術債提前到未來?
這些留言沒有提供標準答案,卻把真正該問的問題說清楚了:可靠的替代模型不是災難復原方案;可攜的流程、狀態與權限才是。
四、把兩起事故放進歷史:這不是罕見例外
第三方的 Fastero 追蹤器整理 Anthropic 公開狀態頁後指出,截至 2026 年 10 月 27 日的前 12 個月,Claude 狀態頁共有 427 起事件,平均每月約 36 起;約三分之一被評為重大或嚴重,解決時間中位數為 59 分鐘。在最近 90 天的 57 起事件中,43 起同時點名多個服務面;Claude.ai 出現於 43 起、Claude Cowork 40 起、Claude Code 39 起、Claude API 38 起。
這些數字不能直接翻譯成「Claude 全年壞掉 427 次」。事件貼文的定義很寬:可能是單一模型短暫回傳錯誤、連接器延遲,也可能是所有主要產品同時無法使用。Fastero 自己也提醒,一則事件不等於一段完整的停機時間。
但它仍能回答一個重要問題:這次不是罕見的系統性例外。 對只看 11 月 13 日兩起事故的人,兩小時與兩小時二十九分聽起來像壞運;放進每月數十起事件的背景,較合理的結論是:多服務同時受影響,對 Anthropic 而言並非罕見故障型態。
更值得留意的是 11 月 12 日仍未解除的 Microsoft 365 connector 事件。官方明確說它由上游 Microsoft 事故造成,郵件、日曆與搜尋工具多數請求仍失敗,Claude for Outlook 也受影響;到 13 日 15:40 UTC 才看到部分恢復訊號,但微軟端事故仍未關閉。換言之,Anthropic 同一天面對的並非單一故障,而是自身驗證鏈、自身多服務降級,以及上游 Microsoft 依賴故障三條問題線交疊。
為什麼這件事重要
第一,AI 服務的競爭正在從模型能力轉向「工作流程可靠度」。 當模型可以寫程式、操作文件、排程工作與串接企業系統,服務中斷就不再只是聊天機器人不能用,而是產值流程停擺。企業選模型時,開始需要同時比較模型價格、上下文長度、基準分數,以及供應商的事件頻率、恢復時間與跨區域可用性。
第二,驗證與工作狀態是比推理引擎更靠近核心的依賴。 推理模型偶爾回錯答案,代理程式還能重試;一旦登入與 OAuth 鏈中斷,已經排队的任務可能無法續跑,延遲排程甚至可能被直接跳過。這次官方特別列出「工作逾兩小時未執行或遭略過」,正說明 AI 服務的品質不只由模型回應決定,也由狀態管理與任務耐久性決定。
第三,「恢復正常」不等於「工作流已恢復」。 第一起事故花了 53 分鐘從修復部署走到正式關案;第二起則明確留下排程與安全掃描延遲。對使用者來說,狀態頁亮綠只是資訊,真正要確認的是:積壓有沒有清完、延遲工作有沒有補跑、代理程式是否在缺失狀態下繼續執行。
第四,供應商集中度正在成為新的營運風險。 同一晚,Claude、Microsoft 365、GitHub 與雲端基礎設施的異常讓開發者互相猜測是否為同一原因。官方把上游 Microsoft 故障講清楚,卻沒有說明自身驗證事故根因;這種資訊落差讓跨供應商備援的設計更難,也讓「先換一家模型」看起來比實際更簡單。
數據解讀與質疑
質疑一:兩小時與兩小時二十九分,都是依官方事件時間戳計算,不等同每個使用者都中斷相同時間。 第一起從建立事件到宣布解決約 1:59:47,第二起約 2:28:59;實際受影響會因地區、既有工作階段、驗證路徑與重試機制而不同。事件總長不能直接換算成「全球使用者平均中斷」。
質疑二:第一起驗證故障與 Microsoft 365 的關聯,目前仍是推測。 HN 有大量留言把兩者連在一起,Mashable 當時也明說尚不清楚是否相關。Anthropic 只對獨立的 Microsoft 365 connector 事件確認「由上游 Microsoft 服務事故造成」,不能把這個結論自動套用到第一起登入故障。在根因報告出來前,最多只能說時間重疊。
質疑三:427 起「事件」不是 427 次全面中斷。 其中包含單一模型錯誤、connector 延遲、低影響事件與狀態頁更新;Fastero 是第三方根據公開資料整理,也不是 Anthropic 官方 SLA 報告。這個數字的正確用法是觀察「事件密度與型態」,而不是宣稱某段時間所有服務都不可用。
質疑四:官方狀態頁的元件最終狀態不應被解讀為每個使用者都完全正常。 第一起事件結束時,Claude.ai 與 Claude Cowork 在元件清單仍被標為 degraded_performance;第二起則明說部分排程與安全功能仍延遲。狀態頁描述的是供應商觀察到的服務層級,不是逐一驗證每個租戶、每個工作階段都已無損恢復。
質疑五:HN 的 416 分與 340 則回覆反映注意力,不等於 416 個受影響組織。 討論串中有人用「成人版的雪天」形容故障,有人馬上切換 Codex,也有人把服務中斷視為合理的工程風險。樣本呈現的是不同依賴程度,不能平均成一個企業損失數字。
Siami 觀點
這兩起事故最值得記錄的,不是「Claude 又掛了」,而是 Anthropic 在官方頁面上把「修復已部署」和「服務已解決」清楚分開。這種透明度本身值得肯定:11:05 部署修復、11:58 宣布解決,中間 53 分鐘的觀察期,把程式上線與實際恢復之間的距離留在了紀錄裡,而不是一句「已修復」帶過。
但第二起事故又補上更嚴肅的一課:即使錯誤率回到正常,排程工作可能延遲超過兩小時,部分甚至被略過;安全掃描與專案設定仍可能卡住。 對話介面恢復並不保證代理工作流恢復。AI 服務的「可用」因此不能只問 API 是否回應 200,還得問:工作有沒有執行、狀態有沒有持久化、延遲與遺失是否可觀測、彌補是否自動發生。
這也改變了企業採購 AI 服務時的問題。過去評估聊天機器人,常比較回答品質與每 token 價格;現在則得多問一句:如果供應商掛了兩小時,哪些流程會停、哪些資料仍在、哪些任務能續跑、哪些結果必須人工核對。模型可以替代,狀態與權限卻不能臨時複製。 真正有效的備援,不是再訂閱一家模型,而是從一開始就把工作狀態、工具權限與驗證邊界設計成可攜、可審核、可恢復。
至於 Microsoft 365 與 Claude 同晚異常,目前最誠實的結論仍是「時間重疊、原因未定」。把未知講成確定很容易,卻會讓故障報告失去價值。Anthropic 真正欠下的不是更多社群轉貼,而是兩份清楚的第一方根因說明:第一起驗證事故到底壞在哪裡,第二起多服務降級為何在第一起關案後一小時又冒出來。
在這兩份說明出現以前,這晚最可靠的 Siami 結論是:Claude 的能力已經足以進入工作流程核心,但它的可靠性距離同一個等級仍有可見差距;而採用它的團隊,現在就該把備援從「換模型」提升為「保住流程」。
延伸閱讀
- Claude Status 官方第一起事件紀錄|09:58 UTC 開案、11:05 UTC 部署修復、11:58 UTC 宣布解決
- Claude Status 官方第二起事件紀錄|Claude.ai、API、Code、connectors、Managed Agents、Meetings 與 Security 的完整時間軸
- Claude Status 官方 Microsoft 365 connector 事件紀錄|官方明確確認此項由上游 Microsoft 服務事故造成
- Mashable〈Anthropic Claude down: Why it said it was unable to authenticate code〉|第一手媒體測試與「是否和 Microsoft 有關尚不清楚」的報導
- AGTP 的第一手用戶回報|Claude Code 被登出、
/login失敗與 OAuth 錯誤訊息 - Fastero〈Claude Outage History〉|第三方逐時整理的 12 個月事件、服務面與解決時間統計
- Hacker News 討論串(416 分/340 則回覆)|服務中斷如何成為工作流程單點故障的完整討論
- YouTube:第三方頻道 Kinda Into AI 對第一起事件的官方時間軸帶讀|說明「修復已部署」與「正式解決」的差別;非 Anthropic 官方頻道
網友熱門留言 (5)