編按:本文綜合整理自 Crissy Field GmbH 原始研究報告〈Lovable: Many Apps Built on the Platform Expose Sensitive Data〉(2026/11/02)、Handelsblatt Lina Knees 專訪〈Lovable: Hat die beliebte KI-Coding-Plattform ein Sicherheitsproblem?〉(2026/11/03)、Lovable 官方部落格〈Our response to the April 2026 incident〉(2026/04/22)、Matt Palmer〈Statement on CVE-2025-48757〉(2025/05/29)、GitHub Advisory Database GHSA-773x-pxjg-gxgx、OECD.AI AI 事故監測紀錄(2026/11/03)、UpGuard〈Everything Everywhere: Systemic Data Exposure in Supabase Apps〉(2026/09/25) 與 Hacker News 討論串(487 分/175 則回覆),並加入 Siami 編輯部觀點與分析。文中所有數字均以研究報告原文與各平台官方揭露為準。
2026 年 11 月 2 日,德國漢堡安全公司 Crissy Field GmbH 與德國商報《Handelsblatt》聯合公布一份研究報告,標題直白到不需要修飾語:《Lovable:建在這個平台上的許多應用曝露敏感資料》。
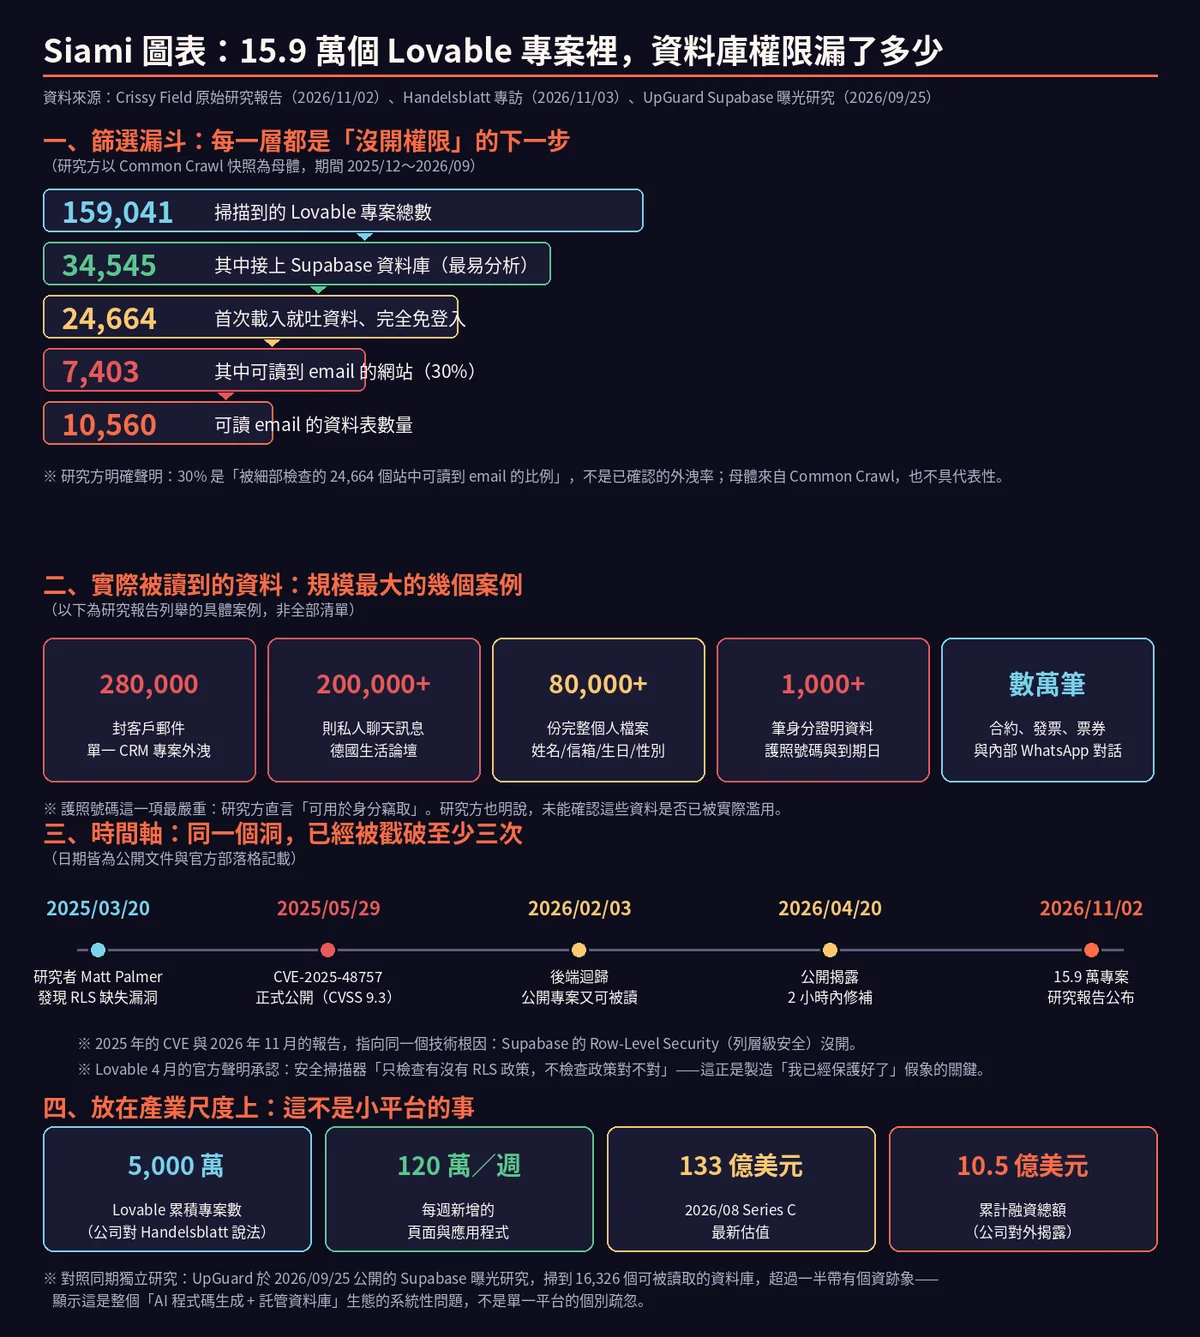
研究方從公開的網頁封存庫 Common Crawl 裡撈出 159,041 個 Lovable 專案(時間跨度 2025 年 12 月至 2026 年 9 月),逐一檢查其資料庫權限設定。結果是:大量建置在這款 AI 程式碼生成平台上、由完全沒有技術背景的使用者「一句話生成」的應用,其資料庫裡的個資不需要登入就能被任何人讀走。
而被讀走的東西包括:逾 1,000 筆護照號碼與到期日、超過 20 萬則私人聊天訊息、8 萬多份完整個人檔案(姓名、信箱、生日、性別)、28 萬封客戶郵件,以及數萬筆合約、發票、票券與內部 WhatsApp 對話。
這不是駭客入侵。研究方用的是唯讀的普通請求——跟應用程式自己送出的請求一模一樣。他們特別聲明,考慮到公布存取方式只會讓更多人下載得到,因此不公開技術細節。
一、一個被掃出來的「漏洞」,其實是一個預設值
技術根因並不複雜,而且不是 Lovable 特有的。
Lovable 產生的應用大多把資料存在 Supabase——一套託管的 Postgres 資料庫。前端要存取資料庫時,用的是一把叫做 anon key 的公開金鑰,而 Supabase 設計上本來就允許這把金鑰公開,它不是外洩的機密。
真正站在「公開金鑰」和「你的資料」之間的,只有一道牆:Row-Level Security(RLS,列層級安全)。RLS 是一組規則,規定「這個使用者只能看見自己的資料列」。Supabase 官方文件寫得很清楚:啟用並正確撰寫這些規則,是開發者自己的責任。
當 RLS 沒有開,Supabase 就會照它被告知的方式運作——把每一列資料交給任何持有公開金鑰的人。免登入,直接下載。
Lovable 的市場推廣主打「不需要任何技術知識」,但在它的服務條款裡,應用程式與資料處理的責任被放在客戶自己身上。這兩件事之間的落差,就是整份報告的核心。
一個把「你不用懂技術」講得越順的平台,越需要在底層把安全預設值做對——因為它的使用者根本沒有能力自己補上。
二、數字的層次:這不是「幾個App出事」
研究方的樣本數與篩選過程本身值得看,因為它決定了這些數字該怎麼讀:
- 掃描母體為 159,041 個 Lovable 專案。
- 其中 34,545 個接上 Supabase——研究方選這個資料庫是因為整合方式容易分析,且他們認為是 Lovable 專案中最常用的選擇。
- 有 24,664 個網站在首次載入時就直接吐出 Supabase 的資料庫紀錄,完全不需要登入或任何互動。單看這一步還不能算資安問題——資料可能本來就是要公開顯示的。
- 但研究方再送出更多的唯讀請求,讀出了更多資料庫內容。結果是在這 24,664 個網站中的 7,403 個(30%)、橫跨 10,560 個資料表裡,找到了電子郵件地址。
研究方在報告裡主動寫了兩道防火牆,值得注意:30% 這個數字不是已確認的外洩率,它只適用於被細部檢查的那 24,664 個站;樣本來自 Common Crawl,不具代表性;而且電子郵件可能是公開聯絡信箱或測試資料,同時這個方法也會漏掉不含信箱的個資記錄。他們甚至說,部分資料集只抓取了一部分就下載,實際受影響的內容可能更多。
這種自我設限在資安研究裡其實很少見——它意味著真實情況很可能比報告寫的更糟,而不是更好。
而個案的規格,遠比統計數字更駭人:德國一個生活論壇外洩 8 萬多份含姓名、信箱、生日與性別的完整檔案,另有 20 萬則以上聊天訊息可讀;數個活動主辦方與餐廳外洩數萬筆售票與餐飲紀錄,含電子郵件、電話、郵遲地址、付款資訊與票券代碼;一家物業管理公司外洩了內部電子郵件的 AI 摘要,涉及租戶、屋主與合作夥伴的敏感資訊;最嚴重的一例是某服務供應商外洩 1,000 多筆身分證明文件紀錄,含護照號碼、到期日與國籍——研究方直言這「可用於身分竊取」。
三、這個洞不是第一次被戳破
把這份報告放進時間軸,會發現它講的是一個反覆出現的結構性問題。
2025 年 3 月 20 日,Lovable 的 DevRel Matt Palmer 檢查一個 Lovable 建的網站時,發現改寫查詢參數就能讀到該專案 users 資料表的所有資料。他在 Lovable 的 Twitter 帳號回覆中指出後,Lovable 當下否認了這個問題,然後刪除了推文與該網站。該網站後來以 2 美元費用重新上架。這個漏洞在 2025 年 5 月 29 日正式登記為 CVE-2025-48757,CVSS 評分 9.3(危急),GitHub Advisory 編號 GHSA-773x-pxjg-gxgx,影響範圍寫明是「2025-04-15 之前的 Lovable 版本」,允許遠端未經身分驗證的攻擊者讀寫任意資料庫資料表。
2026 年 2 月 3 日至 4 月 20 日,Lovable 又發生一次公開專案事件。官方部落格〈Our response to the April 2026 incident〉的說法是:2025 年公司已依使用者回饋刻意關閉公開專案的對話紀錄與原始碼存取,但 2026 年 2 月的後端迴歸把這個存取又打開了。多名研究者透過 HackerOne 提出有效報告,卻因為 Lovable 提供給分流團隊的內部文件過時而被關閉、未被升級處理。4 月 20 日事件被公開後,Lovable 在兩小時內修補,並把所有既有公開專案改為私有(官方可重混的範本除外),同時重整 HackerOne 的漏洞分流流程。Lovable 自己在官方部落格裡承認:「我們的第一份公開回應是輕忽的,沒有正視真正的疑慮。」
2026 年 8 月 12 日,Lovable 完成 4 億美元 C 輪融資,估值 133 億美元,由 Menlo Ventures 領投;累計融資總額約 10.5 億美元,6 月的年化經常性收入已達 5 億美元。對外揭露的規模是:平台上已累計完成 5,000 萬個以上專案,每週新增 120 萬個頁面與應用程式。
2026 年 9 月 25 日,UpGuard 公布獨立研究,掃描出 16,326 個可被讀取的 Supabase 資料庫,超過一半帶有個資跡象。
2026 年 11 月 2 日,就是這份 15.9 萬專案的報告。OECD.AI 的 AI 事故監測(AIM)也在 11 月 3 日將其正式登錄為一起AI 事故,受影響專案數標為「超過 24,000 個」,傷害類型歸類為「人權或基本權利」。
這三件事的技術根因完全相同。 一年半前 CVE 開的是 RLS 缺失,兩次公開事件開的是「公開專案」定義漂移,而這次 15.9 萬掃描開的還是 RLS 缺失。
一個在同一個地方被戳破三次的洞,不該被當成三個意外。它是同一個決策在三年裡重複犯錯。
四、工具已經存在,但只做了一半
必須公平地說:Lovable 並不是完全沒有動作。
在 CVE-2025-48757 之後,Lovable 上線了自動化的 Security Scanner 與 AI Security Reviewer,官方文件也明確把「保護 API 金鑰」「以 RLS 保護資料存取」列為標準功能。2026 年 4 月的事件後,公司也確實重整了漏洞分流與回應流程。
但 Matt Palmer 在 CVE 聲明裡點出的問題,恰恰也是這份新報告的關鍵:Lovable 的安全掃描器「只檢查是否存在任何一條 RLS 政策,不檢查那條政策是否正確、是否與應用邏輯一致」。這一點在獨立技術分析中也再次被確認。
換句話說,掃描器會回報「這個資料表有設定 RLS ✓」,然後就結束了。它不會告訴你,那條 RLS 政策寬鬆到等於沒有。而報告裡那 10,560 個外洩資料表,很可能就落在這個掃描器的盲區裡。
德國媒體《Handelsblatt》報導,Lovable 對這份研究的官方回應是:這是一個產業普遍存在的問題。這句話本身沒錯——同一時期 UpGuard 掃 Supabase、Escape 掃 5,600 個 vibe-coded 應用,得到的都是同方向的結果。但它同時意味著:平台方把自己放在「工具提供者」的位置上,把風險留在使用者身上,而這批使用者的技術背景正是平台最不擅長照顧的那一群。
五、當安全變成一道需要自己動手的工序
這份報告裡最值得注意的技術細節,出現在研究方法而不是案例清單裡。
研究方在報告中特別寫道:他們只送出唯讀請求,用與應用程式本身相同的 API 金鑰,而且是「先從最基礎的設定開始,準備好再往更精密的攻擊推進」。但他們永遠沒有走到第二步——因為在第一層就已經有太多敏感資料裸露在外。
Hacker News 上參與這次分析的研究者 neathack 在討論串中確認了這點:「任何對網路運作有中等程度理解的人都能重現研究結果。」
另一則留言則把時間差補了起來:guestlistplus10 提到,Railway 在幾天前也遭到類似攻擊,攻擊者使用消融過的開放權重模型與竊得的金鑰,造成約 74 萬美元的 AI 費用。Railway 官方 10 月 22 日的初步調查報告也寫明,該次攻擊的目的正是「取得 AI 供應商 API 金鑰以進行蒸餾攻擊」。
當「打開一個網頁」就足以取得一個月的郵件、二十萬則私訊和一千份護照資料時,攻擊的成本會趨近於零——這不是資安問題,是經濟結構改變了。
值得停下來想的是這裡的因果鏈:AI 讓「做出有漏洞的應用」變得極度便宜。傳統上一個有漏洞的應用要工程師花時間寫錯;現在只要一句「幫我做一個會員系統」,AI 就會在 30 秒內生出資料表、後端連線和前端表單——但不會生出 RLS 政策,因為那是需要理解「誰能看哪一列」才能寫出來的東西,而 AI 沒有動機去生成它。
研究方自己在結論裡講得很清楚:使用情境需要特殊照護;平台方在行銷上反覆強調不需要技術知識,這會讓人誤以為平台也把安全包辦了;易用性不會取代專業的存取權限檢視;自動檢查不能替代專業的安全評估。在應用處理真實客戶或商業資料之前,存取權限、介面與使用者帳號之間的隔離都該被檢查過,而且重大變更後要重做。
為什麼這件事重要
第一,這是「AI 生成的預設值」第一次被大規模量化。 過去兩年關於 vibe coding 安全的討論大多是預測性的——「可能會出事」「風險不確定」。這份報告把它變成了一個可計數的問題:15.9 萬個專案裡,30% 可讀到電子郵件。這種數字會改變開發者做取捨的方式,因為風險從「我不知道」變成了「我知道,而且我知道缺口的形狀」。
第二,護照號碼與身分證明文件這件事的性質,與一般資料外洩不同。 電子郵件外洩多半可以用垃圾郵件過濾器處理;護照號碼、到期日與國籍的組合,是可以直接用於身分竊取與帳號接管的高價籌碼。報告裡那 1,000 多筆紀錄,是這批案例中唯一帶有「不可逆傷害」屬性的一類。這也意味著歐盟 GDPR 下的通知義務時鐘,在這些案例上可能已經開始跑。
第三,這個故事的真正結構是「重複失敗」,而重複失敗在治理上的意義完全不同。 第一次是疏忽,第二次是教訓沒學到,第三次就變成結構性問題。CVE-2025-48757 已經把根因寫得清清楚楚:RLS 缺失、Lovable 客戶端架構把安全責任外推給實作者、掃描器只檢查存在性。同一份根因一年半後被掃出 15.9 萬次,代表 2025 年的補救措施在量級上完全沒有生效。
第四,HN 討論串裡有一條很少被引用的觀察,比其他留言都更值得看。 有開發者描述自己正在面試一家「大幅採用 agentic 開發」的公司,嘗試提出一個平衡觀點——先解決治理、護欄與「致命三要素」(私有資料存取、無限制的對外通訊、不當的程式碼執行),再談這些技術的可能性。結果是高階主管不感興趣,他的職位很可能因此被刷掉,而公司實際要找的是「AI 的強力推廣者」。這說明整件事的瓶頸不在技術,而在決策層對「先治理再擴張」這個順序的接受度。沒有 CISO 與資安治理在決策迴圈裡,任何掃描器都只是裝飾。
數據解讀與質疑
質疑一:30% 這個數字會不會被過度引用? 研究方自己已經先做了這件事。他們明說 30% 不是已確認的外洩率,只適用於被細部檢查的 24,664 個站;母體來自 Common Crawl,不具代表性;電子郵件可能是公開信箱或測試資料;同時這個方法也會漏掉不含信箱的個資記錄。這兩個方向的誤差會互相抵銷,但抵銷到什麼程度無法確定。 因此正確的讀法是:30% 不是外洩率,而是一個「至少有這個比例存在可被讀取的 email 欄位」的下限指示燈,不是統計結論。
質疑二:既然研究者知道有洞,為什麼不修? 因為他們不是攻擊者,這是他們與駭客最重要的一道界線。整份報告的價值恰恰建立在「我沒有做任何越界的事」這個前提上——研究方法只有唯讀請求,使用的還是應用自己送出的金鑰。如果連這種程度的存取都被視為需要修補,那個報告本身就不可能存在。
質疑三:Lovable 說「這是產業普遍問題」,是推卸責任嗎? 這句話有兩面。第一面是真的:UpGuard 在 2026 年 9 月掃到 16,326 個暴露的 Supabase 資料庫,Escape 掃 5,600 個 vibe-coded 應用發現 2,000 個高影響問題、175 個 PII 實例,Wired 早在 2026 年 5 月就報導過同樣的情況。把責任全推給 Lovable,在事實上站不住腳。第二面是:平台方是這個產業裡唯一能設定預設值的人。 使用者分不出哪個 Supabase 金鑰該藏、哪個 RLS 該開——他們連自己用了 Supabase 都不知道。當一個供應鏈節點能設預設值卻選擇不設,產業普遍性就成了責任分配的一部分,而不是免責事由。
質疑四:這件事到底怎麼發生的? 三個技術上的缺口疊在一起:① Supabase 的 anon key 公開是設計如此,安全完全依賴 RLS;② AI 生成的應用不會自動產生 RLS 政策,因為那需要「理解誰該看哪一列」的語意推理;③ 掃描器只檢查政策存在性,給了使用者一個「已經保護好了」的假象。第四個缺口在流程:這批使用者沒有工程師,也沒有 CISO,也沒有 code review。傳統團隊裡那個會問「這張表有沒有被保護?」的角色,在這個使用者群體裡根本不存在。
質疑五:有沒有被濫用? 研究方明說無法確認任何一筆資料是否已被實際使用。這不代表沒被用——被公開放著的資料庫,一個爬蟲就能在幾分鐘內打包帶走,而且在沒有被發現的情況下,濫用本來就不會留下可見的痕跡。但把「無法確認」說成「有被濫用」同樣是沒有根據的。Siami 的判斷是:這是責任歸屬上的不確定性,不是事實上的空白,而 GDPR 下的評估標準看的是「是否已有暴露」而非「是否已被使用」。
Siami 觀點
這份報告最刺眼的地方,不是 20 萬則私訊這種數字——數字震撼是新聞的常態,讓人真正停下來的是時間軸。
2025 年 3 月,一位在職於該平台的工程師親手示範了這個漏洞,被否認、推文被刪、網站下架。兩個月後它成為 CVSS 9.3 的正式編號。2026 年 2 月,同一個平台的後端迴歸讓「公開專案可被其他使用者讀取」這件事捲土重來,持續到 4 月 20 日被公開才修補。2026 年 11 月,獨立研究團隊掃出 15.9 萬個專案,發現 RLS 缺失到處都是——根因跟 2025 年 3 月那個 CVE 完全一樣。
這條時間軸說明的不是「開發者會犯錯」,因為開發者本來就會犯錯。它說明的是:這個產業目前缺少一套能讓「已知問題必須在合理時間內被解決」的機制。 掃描器會變綠、文件會更新、官方部落格會寫得很誠懇(這份聲明確實寫得很誠懇),但沒有任何東西阻止同一個洞在十八個月後出現在一萬七千個不同的應用裡。
而這整件事的機制層面,是AI 把「做出錯誤的東西」的成本壓到了接近零,卻沒有把「驗證它是不是對的」的成本壓到同樣低。寫一段有漏洞的程式碼,AI 幾秒鐘就能給你;讀懂這段程式碼在一個真實的多租戶資料庫裡會怎麼洩漏,仍需要一個真正懂授權模型的人類坐在那裡。AI 壓縮的是生產成本,不是驗證成本——這個落差,正是 15.9 萬這個數字的來源。
對台灣的中小型工作室與獨立開發者來說,這件事有一個非常具體的提醒:現在把客戶資料交給任何一個 AI 生成的應用(含由 AI 生成的網站表單串接自家 CRM),風險已經不再抽象。今天就可以做的三件事:開 Supabase 的 Security Advisor 逐表確認 RLS 已啟用且政策正確;從前端程式碼裡移除 service_role 金鑰(那一把會直接繞過 RLS);用 anon 金鑰直接測試每個資料表,確認未登入狀態下真的拿不到資料。這三件事花不了一個下午,而報告裡最嚴重的那一類後果,本來只需要這一個下午就能擋下。
最後一個值得記住的數字是 1,000 多筆護照紀錄。資料外洩的新聞裡,數字常常是抽象的——「數百萬筆」聽起來嚴重,但讀者無感。1,000 筆護照號碼不抽象,因為那是可以一筆一筆被拿去開戶、辦卡、申請貸款的具體憑證。它不多,但它足以讓每一個被洩漏的人,今天就該去確認自己的身分狀況。
延伸閱讀
- Crissy Field:Lovable: Many Apps Built on the Platform Expose Sensitive Data — 本次研究的一手報告全文,含方法論與限制說明
- Handelsblatt:Lovable: Hat die beliebte KI-Coding-Plattform ein Sicherheitsproblem? — Lina Knees 的原始專訪,含 Lovable 官方回應
- Matt Palmer:Statement on CVE-2025-48757 — 2025 年漏洞發現者的一手說明,含「掃描器只檢查存在性」的批評
- GitHub Advisory Database:GHSA-773x-pxjg-gxgx — CVE-2025-48757 的官方安全公告
- Lovable 官方:Our response to the April 2026 incident — 平台方對 2026 年 4 月公開專案事件的完整時間軸與改進措施
- OECD.AI AI 事故監測紀錄 — 本事件被官方登錄為 AI 事故的正式條目
- UpGuard:Everything Everywhere: Systemic Data Exposure in Supabase Apps — 16,326 個暴露資料庫的獨立研究,證明這是生態系問題
- Hacker News 討論串(487 分/175 則回覆) — 開發者與安全研究者對「AI 開發的治理順序」與「消融模型的攻擊面」的實質討論
網友熱門留言 (10)