編按:本文綜合整理自 密西根大學工程學院新聞稿〈Generative AI uses more energy on non-English text〉(2026/11/05)、EMNLP 2026 論文〈The Language–Energy Divide: Measuring Energy Costs of Multilingual LLM Inference〉(arXiv:2606.21869)、論文官方資料與程式碼(MichiganNLP/language-energy-divide)、ACL Anthology 正式出版版本、ML.Energy 能量量測框架、Ethnologue 語言人口統計、Hacker News 討論串(213 分/111 則回覆) 與 密大電腦科學與工程系官方 X 貼文,並加入 Siami 編輯部觀點與分析。文中所有數字均以論文原始表格與實驗設定為準。
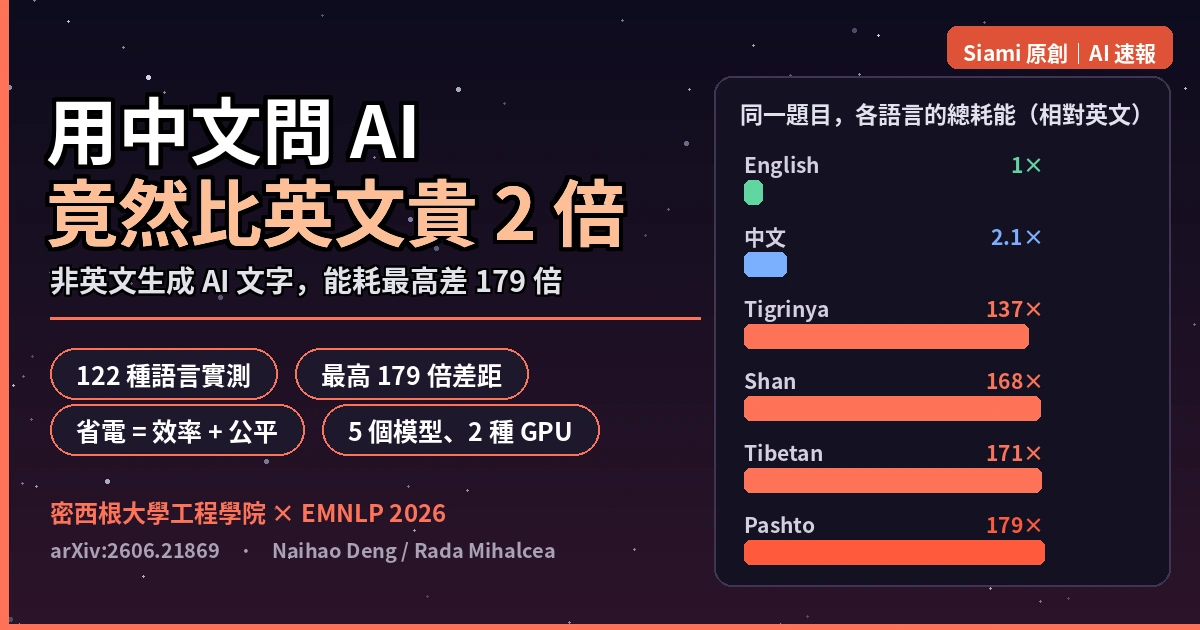
2026 年 11 月 5 日,密西根大學工程學院釋出一份研究,主張一個聽起來離譜、但機制上完全合理的事實:同一個模型、同一張考卷、同樣的硬體與批次設定,用英文問和用普什圖語問,AI 生成一次回覆所消耗的電能可以相差 179 倍。
研究由該校 AI 實驗室(U-M AI Lab)主持人 Rada Mihalcea 與博士生 Naihao Deng 領銜,論文〈The Language–Energy Divide: Measuring Energy Costs of Multilingual LLM Inference〉發表於 2026 年 EMNLP 會議。實驗用一套涵蓋 122 種語言的閱讀理解測驗(Belebele),搭配 Qwen3、Gemma 3、Llama 3.1 等開源模型,在密大 Great Lakes 高效能運算叢集上實際量測 GPU 的用電。
一、122 種語言、5 個模型、同一張考卷
研究的核心設計相當克制:把模型、硬體、提示詞、批次大小全部固定,只讓「語言」這一個變因動。
- 語言:Belebele 資料集的 122 種語言,依 NLLB 資源分級分成 56 種高資源、66 種低資源。
- 模型:Qwen3-8B/14B/32B、gemma-3-27B、Llama-3.1-8B-Instruct,共 5 個,橫跨三個模型家族。
- 硬體:NVIDIA L40S(48GB)與 RTX 6000 Pro Blackwell(96GB)兩種 GPU,批次大小從 16 一路測到 512。
- 推論框架:vLLM 服務於 HPC 叢集,並比對 ML.Energy 框架定義的「穩態」區間——也就是伺服器批次塞滿的那段窗口,避免短促的英語請求被算進冷啟動成本。
- 任務:除了 122 語言的選擇題,也把 GSM8K 數學題與 LM-Arena 開放式問答翻譯成另外七種語言,驗證落差是否跨任務成立。
翻譯用的是 Meta 的 NLLB-200,並且做了回譯品質檢查(back-translation QC),自動流程失敗的地方再人工校訂。
二、179 倍:數字實際長什麼樣
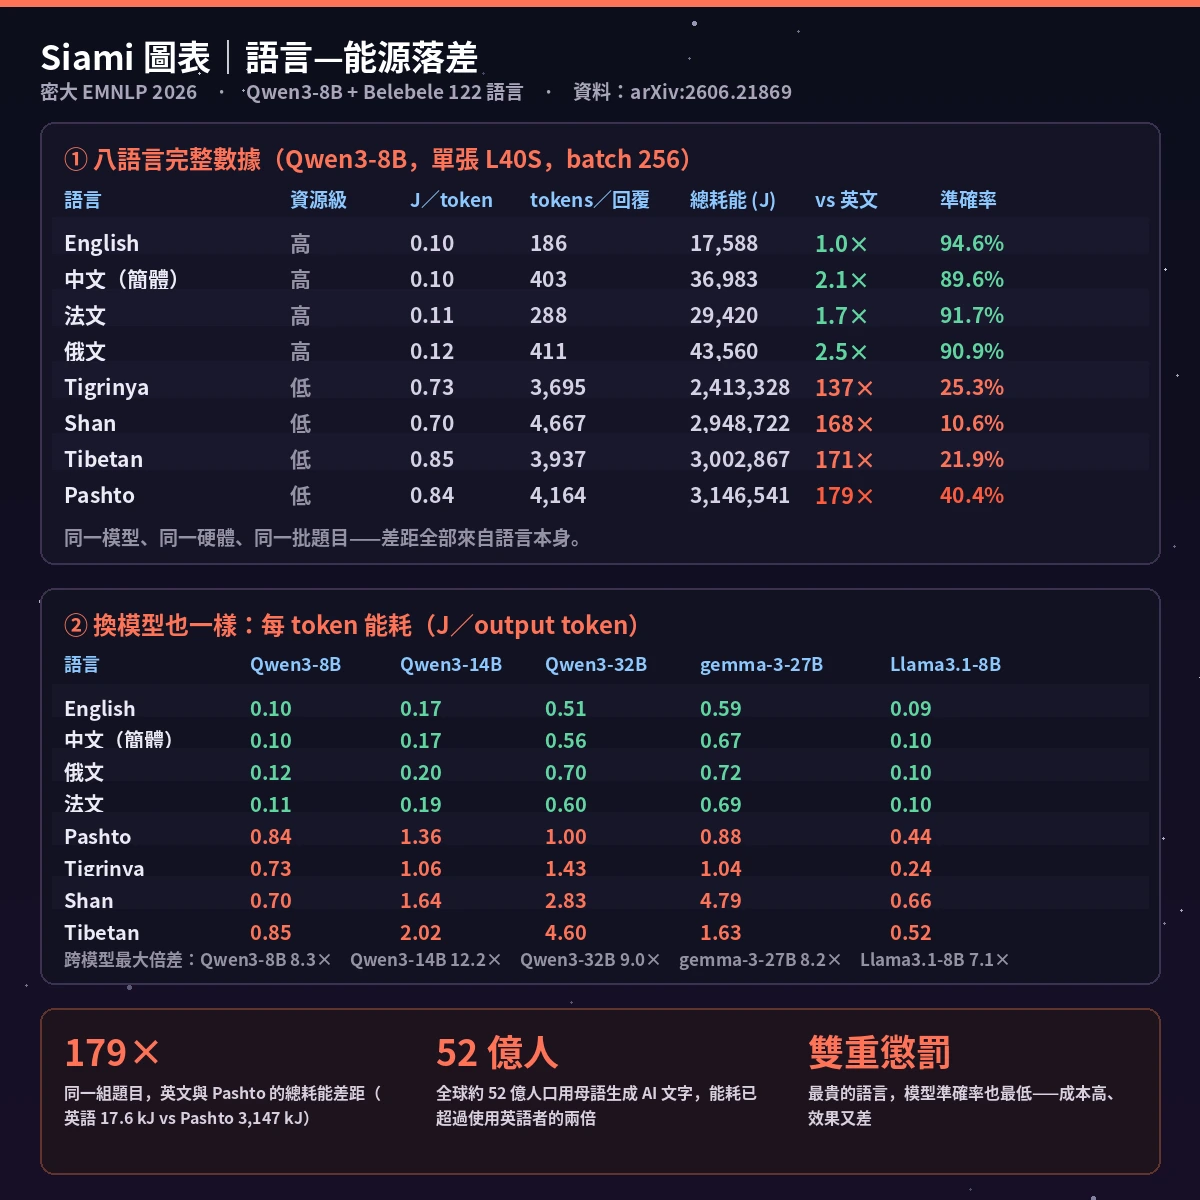
以 Qwen3-8B 在 Belebele 上的結果為例,同一批題目、同一部 GPU,差距如下:
| 語言 | 每 token 能耗 | 每次回覆輸出 token | 總耗能 | 相對英文 | 準確率 |
|---|---|---|---|---|---|
| 英語 | 0.10 J | 186 | 17,588 J | 1.0× | 94.6% |
| 簡體中文 | 0.10 J | 403 | 36,983 J | 2.1× | 89.6% |
| 法文 | 0.11 J | 288 | 29,420 J | 1.7× | 91.7% |
| 俄文 | 0.12 J | 411 | 43,560 J | 2.5× | 90.9% |
| Tigrinya | 0.73 J | 3,695 | 2,413,328 J | 137× | 25.3% |
| Shan | 0.70 J | 4,667 | 2,948,722 J | 168× | 10.6% |
| 藏文 | 0.85 J | 3,937 | 3,002,867 J | 171× | 21.9% |
| 普什圖語 | 0.84 J | 4,164 | 3,146,541 J | 179× | 40.4% |
若改用「每次回覆」的單位,英語是 19.5 J,普什圖語 3,496 J,藏文 3,337 J,Shan 3,276 J,Tigrinya 2,681 J——最高與最低相差 179 倍。
新聞稿另外點名幾個使用者規模很大的語言:印地語是英文的 7.9 倍、孟加拉語 15.3 倍;多數西歐語言則落在兩倍以內。全球約有 52 億人以母語生成 AI 文字時,能耗已超過使用英語者的兩倍。
三、兩個原因:token 爆炸 × 每個 token 更貴
差距不是單一因素造成的,而是兩個機制相乘的結果。
第一個是輸出長度。 低資源語言每次回覆會吐出 20 到 25 倍於英語的 token 數量。分詞器是針對英文最佳化的,非拉丁字母需要更多 token 才能表達同樣的意思,模型被迫生成更長的答案,模型的 KV cache 隨之膨脹,可用記憶體被壓縮、批次被迫切小,每個 token 的成本再往上跳一次。
第二個是每 token 的基礎能耗。 大多數語言聚在 0.10 至 0.20 J/token,但藏文、普什圖語、Tigrinya、Shan、阿姆哈拉語這些非拉丁腳本構成一條長尾,超過 0.4 J/token,最貴與最便宜之間每 token 就差 8.3 倍。
值得注意的是有個例外:埃及阿拉伯語(arz_Arab)雖然是低資源語言,卻擠進最便宜的前五名,因為它跟高資源的現代標準阿拉伯語共用同一套阿拉伯字母,分詞器覆蓋率夠好,成本優勢就一併沿用過去了——美索不達米亞、納吉迪、摩洛哥、北黎凡特等阿拉伯方言也同樣落在便宜的那一叢。腳本相同,命運就相同。
四、換模型、換 GPU、換批次,差距都沒消失
這是整篇論文最關鍵的一段:落差不是某個模型的暫時性 bug。
| 語言 | Qwen3-8B | Qwen3-14B | Qwen3-32B | gemma-3-27B | Llama3.1-8B |
|---|---|---|---|---|---|
| 英語 | 0.10 | 0.17 | 0.51 | 0.59 | 0.09 |
| 簡體中文 | 0.10 | 0.17 | 0.56 | 0.67 | 0.10 |
| 俄文 | 0.12 | 0.20 | 0.70 | 0.72 | 0.10 |
| 法文 | 0.11 | 0.19 | 0.60 | 0.69 | 0.10 |
| 普什圖語 | 0.84 | 1.36 | 1.00 | 0.88 | 0.44 |
| Tigrinya | 0.73 | 1.06 | 1.43 | 1.04 | 0.24 |
| Shan | 0.70 | 1.64 | 2.83 | 4.79 | 0.66 |
| 藏文 | 0.85 | 2.02 | 4.60 | 1.63 | 0.52 |
五個模型的跨語言最大倍差分別是 8.3×、12.2×、9.0×、8.2×、7.1×。每一個模型上,英語或中文都是最便宜的語言,藏文或 Shan 都是最貴的,而高資源群與低資源群的數值從來沒有重疊過一次。
值得注意的是,模型變大並沒有收斂差距:Qwen3 從 8B 拉到 32B,英語的每 token 能耗從 0.10 J 升到 0.51 J,但低資源語言跟高資源語言之間的倍數關係在每個尺寸上都一樣存在。換 GPU、從 16 批次拉到 512 批次也一樣——簡體中文在每一個批次大小下都還是墊底的那一檔,Shan 在多數情況下最貴。
↑ TED-Ed 與 Sajan Saini 合作〈Why are AI data centers using so much electricity?〉(TED-Ed 官方頻道)——理解這份研究的背景:AI 的耗電問題從來不是新話題,但這篇論文指出耗電的負擔並不是平均分配的。
五、這不只是工程問題,是定價與公平的問題
論文提出了三個具體的改進方向:
- 把當量當成第一級評估軸。 建議在 Responsible NLP Checklist 與 model card 中,除了準確率,也強制填報推論耗能——兩個準確率相同但能耗差很多的系統,在實際部署上並不等價。
- 多語言模型應逐語言回報耗能。 一個模型可能對不同語言付出完全不同的成本,卻只公布一個總數。
- 部署端的緩解手段。 包含「先翻成英文再處理」的管線(translate-then-process)、依語言做查詢路由(把低資源語言導向更專精、但更小的模型),以及依各語言閱讀速度調整批次大小的服務端最佳化。
研究團隊也主動點出這份研究本身的雙面刃:成本敏感的服務商可能拿這些數字當作「不服務低資源語言」的藉口。但論文的立場是,留著不量、不談,反而會讓同樣的結果在無聲中發生。他們主張用透明化、緩解措施與部署端的公平稽核來回應。
論文作者明確寫道:這是對當前分詞、訓練資料與服務選擇如何對待每一種語言的裁決,不是對任何語言本身難度或價值的裁決。
↑ 國際能源署(International Energy Agency)官方頻道〈How much electricity does AI actually use?〉——從全球能源 accounting 的角度補上這份研究沒有處理的總量視角。
為什麼這件事重要
第一,AI 的成本正在變成一道語言門檻。 大多數人用 AI 是用母語問問題,而論文作者 Naihao Deng 的說法是:多數人會希望用母語使用 AI 模型,隨著 AI 融入社會各層面,人們也會感受到壓力去使用它,但這個雙重懲罰會讓某些人更容易被 AI 的價格擋在門外,也讓公司更不願意服務某些語言。全球約 52 億人正處在這個位置。
第二,這是少數「省電等於做好事」同時成立的情況。 絕大多數效率優化都是成本問題:省下的是雲端帳單。但把非英文使用者的能耗拉近英文,等於讓那 52 億人的服務品質(準確率)一起提升——省電、變快、變準、變便宜,四件事指向同一個方向。論文提到一位開發者社群成員在 Hacker News 上的實測:他用自己最佳化的商用模型重跑了這份論文的核心發現,結論大致成立,而且發現俄文與中文的耗能反而比預期低——這正是中文使用者的好消息。
第三,分詞器的偏見被量化成了一個可以拿來談判的數字。 「非英文比較費 token」以前是開發者圈的口耳相傳,現在有了跨 122 語言、5 個模型、2 種 GPU 的可重現數據。對模型廠商來說,這個數字意味著「只公布總成本」的商業模式會被質疑;對政策制定者來說,這意味著 AI 法案裡的語言覆蓋條款有了量化依據。
數據解讀與質疑
這份研究方法紮實,但有幾個地方需要讀者自己拿捏。
「179 倍」是特定條件下的比值,不是通用常數。 它來自 Qwen3-8B 在 Belebele 選擇題上、單張 L40S、批次 256 的實測。換成每 token 能耗,倍數只有 8.3 倍;而且論文測的是 8B 級的開源模型,不是前沿 API 模型。拿「179 倍」去推算一個實際的雲端帳單,會嚴重高估或低估。
部分差距其實是「模型陷入迴圈」造成的,不是語言本身需要的長度。 Hacker News 上多位開發者觀察到同一份論文第 6 頁的表格:最糟的情況是同一句話被重複輸出 45 次。這代表高耗能裡有一塊是模型品質缺陷(低資源語言下模型更容易退化、重複生成),而不是「這個語言比較費電」的固有特性。這也解釋了為什麼準確率同步崩掉——10.6% 的 Shan 準確率,意味著模型有一半以上根本沒答對,那 4,667 個 token 裡很多是無效輸出。
能耗與準確率是「同因異果」,不是因果。 論文自己用的詞是 double penalty:最耗電的語言,模型也最不擅長。兩者都源自同一個上游原因——該語言在訓練資料與分詞器裡的占比不足。不能解讀成「多花能量就會變差」或反過來。
翻譯品質是方法上的不確定來源。 論文自己承認,GSM8K 與 LM-Arena 的提示詞是用 NLLB-200 翻譯加回譯檢查得來的,機器翻譯與人工校訂都無法完全取代母語者。附錄 A 的討論也點出,資源分級是粗糙的預測因子——被判為高資源的祖魯語、斯威士蘭語、科薩語,反而落後於被判為低資源的馬拉地語、爪哇語。
「改用拉丁字母轉寫」不是免費的解方。 附錄數據顯示,印地語轉寫成拉丁字母只從 75.9% 掉到 66.7%,但孟加拉語從 78.3% 直接崩到 29.9%、僧伽羅語從 51.8% 掉到 32.1%。轉寫幫了分詞器,卻可能打斷模型對該語言的詞彙與形態知識——這條路不是一致有效的。
發表時效的合理質疑。 Hacker News 上有人問:這些模型在投稿時已經是 18 個月前的主流了,為何不在投稿前重跑一次?學術界的答覆是「實驗成本高、很多實驗本質上難以重現」,這在研究現實裡成立,但也確實提醒讀者:數字反映的是 2025 年代的模型堆疊。
Siami 觀點
對中文使用者來說,這份研究其實是好消息。 簡體中文在所有測試模型上都是最便宜的一檔(2.1×),比日文、韓文等常見的第二語言都省。原因很直觀:中文在訓練資料裡占比高、分詞器覆蓋好、模型答得也比較準(89.6%)。中文使用者在這場「AI 電價分化」裡,恰好站在成本較低、服務品質較好的一側。
真正被排除在外的,不是「西方 vs 中國」,而是「高資源 vs 低資源」。 這點很重要。普什圖語、藏文、Shan、Tigrinya——這些不是任何一方的語言,而是全球數億使用者的日常語言。台灣、香港、東南亞的讀者看這份報告時,容易誤以為「非英文 = 比較貴 = 對中文讀者不利」,但數據說的是另一件事:受害的是那些既沒有大量訓練資料、又沒有自足分詞器的語言。AI 的排他性沿的從來不是地理界線,而是資料密度。
省電的捷徑其實早就被全球開發者用腳投票了。 Hacker News 上多名開發者提到實務現況:寫程式問 AI 用英文,需要時再翻回母語;多語言使用者早就自發地把英文當成內部工作語言。這份研究只是第一次把這個「地下最佳化」量化成一個有學術背書的倍數——未來 API 廠商若按 token 計價,這個差距會直接反映在價格上,讓「用英文省電」從社群暗語變成一道有財務後果的選擇題。
對台灣的啟示:本地語言模型的價值在於「省掉那次翻譯」。 論文最實用的建議就是 translate-then-process 管線——非英文輸入先翻英文、用通用模型處理、輸出再翻回。但論文同時警告,對文化承載重或社會語言豐富的任務,這條管線會產出「流暢但不文化忠實」的結果。對繁體中文這種有大量在地慣用語、幽默與歧義的語言,把繁中直接送到對繁中分詞友善、且用繁中訓練過的模型上,未必比「翻英文再翻回」更貴——這是台灣這邊的模型廠商真正的切口。
延伸閱讀
- 論文原文:The Language–Energy Divide(arXiv:2606.21869)|HTML 全文版(含所有表格與圖)
- 官方資料集與分析程式碼:MichiganNLP/language-energy-divide(含 122 語言逐語言的耗能與準確率原始數據)
- ACL Anthology 正式出版版本(EMNLP 2026 Main)
- ML.Energy:GPU 推論能量量測框架與排行榜
- 密西根大學工程學院新聞稿〈Generative AI uses more energy on non-English text〉
- Belebele:122 語言閱讀理解測驗集(Bandarkar et al., 2024)
- Ethnologue:全球語言人口統計
- Hacker News 討論串(213 分/111 則回覆)
- 延伸閱讀:分詞器公平性研究整理(HN 網友提供)
- 延伸閱讀:ML.ENERGY Benchmark 論文說明
網友熱門留言 (11)