編按:本文綜合整理自 Google Research 官方部落格〈Advancing science & engineering with Antigravity’s /teamwork〉(2026/11/13)、Antigravity 官方文件〈Teamwork agent teams (/teamwork)〉、Antigravity 官方部落格〈Teamwork: when AI becomes a research partner〉(2026/08/27)、Antigravity 科學應用頁(10,000 名學術研究者免費申請)、Google Research 官方 X 貼文(2026/11/13)、Vahab Mirrokni 成果清單貼文、Hacker News 討論串(208 分/49 則回覆)、Interesting Engineering 報導(2026/11/13) 與 Magica 對前一批 Teamwork 成果的獨立質疑(2026/11/13),並加入 Siami 編輯部觀點與分析。文中數字均引自 Google 官方公布內容,並已標明哪些是作者自述、哪些是第三方觀察。
2026 年 11 月 13 日,Google Research 在官方部落格公布 Antigravity 平台的多代理系統 /teamwork 最新成果。發表這篇文章的是 Google Fellow、Google Research 資深研究副總裁 Vahab Mirrokni,他同時也是 Gemini 4 團隊的核心人物。
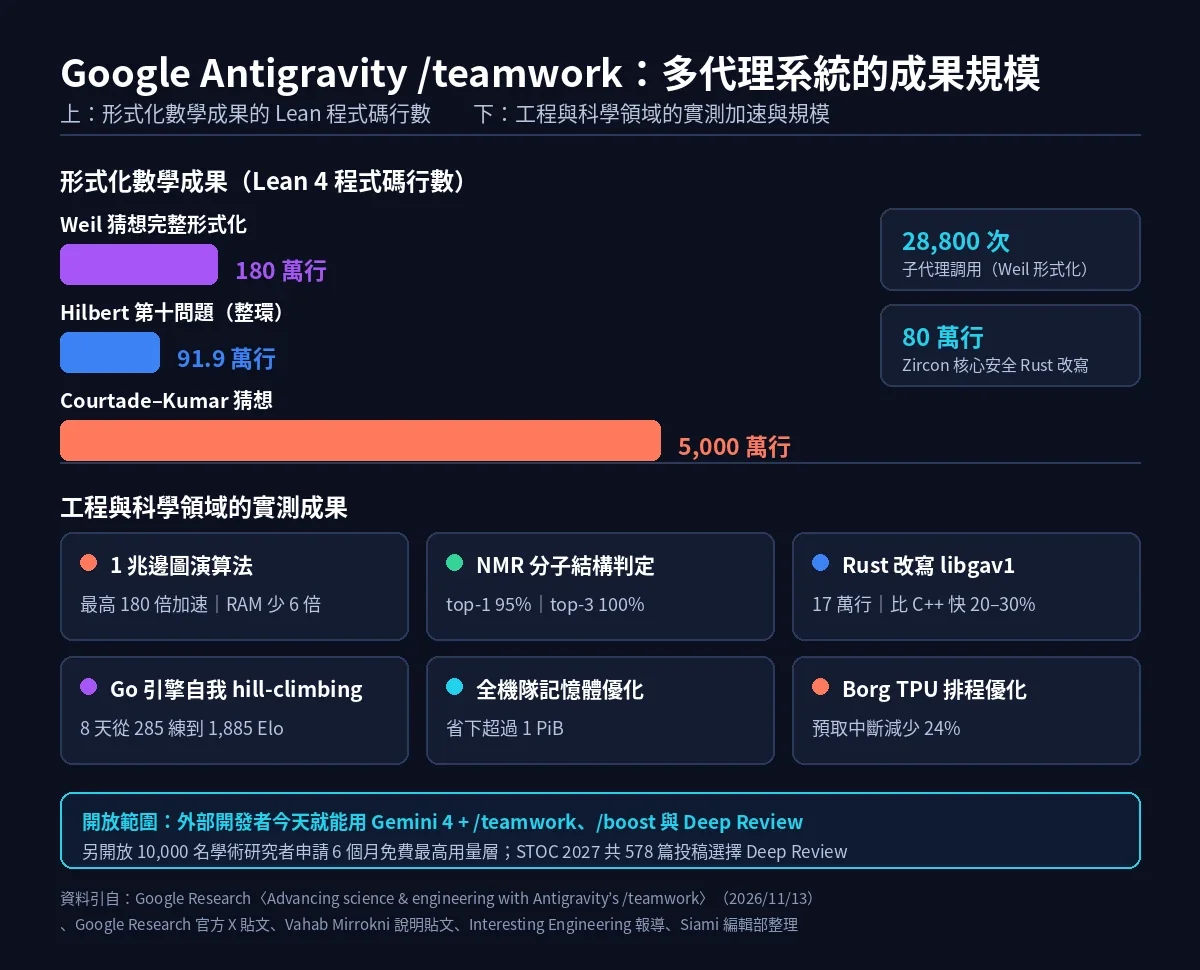
這批成果的量級,坦白說不太像一般的 AI 產品公告:Google 宣稱,代理系統在數學、化學、系統軟體與機器學習工程四個領域,同時推進了多個長年未解的問題——其中最誇張的一項,是用多代理協作完整形式化了 韋爾猜想(Weil conjectures),總計約 180 萬行 Lean 4 程式碼,耗費 28,800 次子代理調用。同一批工作也重現了 3D 納維-斯托克斯方程「有限時間奇性」結果的端到端形式化,那是七個千禧年難題相關問題之一,開放了約 90 年。
這不是「AI 變聰明了」這種模糊說法,而是一份可以直接用 Lean 核心檢查器逐行驗證的產物。
一、/teamwork 到底怎麼運作:兩段設計對策兩個瓶頸
Google 在文章裡把設計動機講得相當具體。/teamwork 要解決的是當前語言模型的兩個已知弱點,而整套架構就是針對這兩點反過來設計的。
第一個弱點是生成不可預測。 單次嘗試跟「找到正確答案」之間存在巨大落差。/teamwork 的解法是「平行探索加上專職反證者(falsifiers)」——每一條候選解答都要丟給獨立的驗證機制,例如:
- Lean 4 證明檢查器(逐行檢查每個邏輯步驟)
- 未經修改的軟體測試套件
- 執行模擬器與網頁搜尋
- 硬體計時器(用真實硬體當裁判)
第二個弱點是長任務失焦。 模型在進行多日工作時,注意力會隨著上下文視窗擴張而渙散。/teamwork 的解法是「以構造方式切分上下文」:每個專門代理只拿到它那一步需要的檔案與工具;協調者把任務交棒給全新的接手者;批評者與稽核者則在乾淨的上下文裡挑戰與驗證結果,完全不帶原始產出者的推理過程。
這兩點合起來,構成一種與「單一代理跑更久」完全不同的哲學:不是讓一個模型變得更強,而是讓一群模型互相拆台。而整套工作流用宣告式的自然語言「模式」表達,系統會依使用者prompt 動態路由到最適合的模式——從分散式編碼、迭代式求解(打包成獨立的 /boost),到長篇證明與文件審查。
二、數學:從韋爾猜想到千年難題的端到端形式化
數學是這次成果的重災區。Google 與 CUHK、USC、CMU 等學術合作方聯手,用 /teamwork 的 Long Proof 模式(在 Antigravity 內實作 Stellar Colosseum)完成了資訊理論 2013 年的 Courtade–Kumar 猜想的完整證明。這個猜想斷言:當隨機位元串通過有雜訊的通道時,把輸入壓縮成單一位元,不會比「獨裁者函數」(只複製單一輸入位元)保留更多資訊。
形式化驗證的成果更為龐大。由 Google Cloud AI 團隊與 Argon 搭配開發的多代理框架 LEAP:
- 產出約 180 萬行 Lean,端到端、機器可檢的形式化 韋爾猜想——這組定理是 Pierre Deligne 在 1974 年證明的、有里程碑地位的結果,內容是有理係數多項式方程在有限域上解的個數計數
- 合成超過 91.9 萬行 Lean,首次形式化近期「一般整環上的 Hilbert 第十問題」證明
- 獨立重現 3D 納維-斯托克斯方程平滑外力下有限時間奇性的端到端形式化
- 首次形式化 Birkhoff 猜想(動力學系統,自 1927 年開放下來)
- 首次形式化 3D Bochner–Riesz 猜想(調和分析,開放逾 50 年),過程中還找出並修掉了一份近期發表的非形式化證明裡的漏洞
- 解決三維以上無窮調和函數的 C¹ 正則性(開放約 20 年)、形式化 Killip 與 Vişan 的 KdV 水波方程適定性定理,並驗證 UCLA 團隊關於 40 年歷史的 Jamison Caterpillar 猜想、Ağırseven–Ollis 猜想等非形式化證明
其他領域也同步推進:線上逆線性最佳化問題得到決定性演算法,執行時間從維度上的指數降為多項式;n 位元整數乘法方面,除了把理論圖靈機下界簡化到 n log n 以下,另一項成果給出單一二維網格上的 O(n log n) 演算法,其 C 實作與 GNU GMP 在十億位元尺度上逐位元相符;資料結構領域對 Tarjan 1985 年的 Deque 猜想取得進展,證明每操作開銷的新上界同時優於任何有限次迭代的 inverse-Ackermann 函數,並以 Lean 4 驗證。
三、Deep Review:把論文審稿變成可收費的 API
另一條線是 Deep Review,把 /teamwork 的文件審查模式做成獨立產品。在 STOC 2027 之前,共有 578 篇投稿(超過全部投稿的三分之一)選擇接收 Deep Review 的回饋。
作者問卷(n = 70)的結果如下:
- 90% 認為回饋大致或幾乎完全符合事實
- 90% 表示願意再次使用
- 超過 30% 表示它抓到了實質的證明錯誤或數學上顯著的筆誤
- 14% 表示它找出的技術性缺口需要一個多小時以上才能修好
Google 提供每週兩次免費的 Deep Review 呼叫給所有人。
四、化學與工程:從分子結構到 1 兆邊圖
化學方面,研究人員把 30 個專門代理組成自我修正迴圈,搭配物理資訊光譜模擬器,從實驗核磁共振(NMR)資料判定分子結構,在複雜基準分子上達成 95% top-1 精確匹配、100% top-3 準確率,幾乎是單一代理性能的兩倍。以 HIV 蛋白酶抑制劑為例,一個錯置的化學鍵就足以區分無活性的仿製藥與真藥。
工程方面的數字更直接:
- FarArray:以 SNAP 微核心為基礎的低延遲核心繞過 Partitioned Global Address Space。其上的無鎖連通分量演算法可擴展到一兆邊的圖,吞吐量提升 60 到 90 倍、速度提升 40 到 180 倍,RAM 用量只有 TCP 鍵值儲存的六分之一
- InstantEmbedding(Personalized PageRank):峰值 DRAM 減少最多 14 倍,執行時間比加速 MapReduce 實作快 11 到 27 倍
- GNN 的自訂 TPU kernel:高頻寬記憶體用量最多降 185 倍,前向與反向傳遞加速 8 到 15 倍
- Rust 改寫:Zircon 微核心剩餘的 C++ 程式碼在兩週的 Argon 活動中改寫為約 80 萬行安全 Rust,通過所有核心單元測試並能在 arm64 硬體上開機;Google 的 AV1 解碼器 libgav1 也被改寫為約 17 萬行 Rust,在廣泛的一致性測試套件中達成 100% 逐位元相同。值得注意的是,初版 Rust 移植比原 C++ 慢約 4 倍,但當 /teamwork 取得效能分析工具並被要求以樣本影片片段的最大化速度為目標後,Rust 版本反而比原 C++ 與手寫組語快 20 到 30%
- Go 引擎:在 Argon 上以 hill-climbing 團隊從基本 AlphaZero 實作從零訓練 9x9 圍棋引擎,自我對弈加速 2,300 倍,不到八天獲得約 2,600 Elo、來到 1,885 Elo,介於 KataGo 每步 16 與 32 次訪問之間
- 生產環境:全機隊記憶體優化省下超過 1 PiB;Borg 的代理式排程最佳化讓部分硬體類型的 TPU 工作負載預取中斷減少 24%,同時維持服務層級目標與叢集利用率
五、開放給誰:10,000 個免費學術席位
工具本體已經對外開放。外部科學家與開發者今天就能在 Antigravity 與 Deep Review 使用 Gemini 4 模型搭配 /teamwork 與 /boost;Hydrogen 模型對所有人開放,Carbon 與 Argon 則給 Enterprise 與 Ultra/付費用戶。另外 Google 開放 10,000 名學術研究者申請六個月的最高用量層免費使用權,並附上 Gemini 4 Argon。
為什麼這件事重要
三年前如果有人宣稱「AI 證明了韋爾猜想」,最合理的第一反應是要求看證明本身。今天 Google 交出來的是 180 萬行 Lean 4——那不是敘述、不是摘要,而是一份能被電腦核心逐行檢查的東西。這個差別是本質性的:敘述需要信任作者,Lean 檔案只需要信任檢查器。
更關鍵的是,這批成果全部在「人類專家與代理協作」的框架下完成,不是代理單獨閉門造車。數學家負責確認形式化定理陳述與原始問題相符,代理負責產生證明與反證,Lean 負責把關。這其實是把「數學研究的分工」重新排列了一次:人負責定義問題與驗證語意,機器負責窮舉與形式化,人機之間用可檢查的語言(Lean)當中介語言。
從產業角度,這也意味著 Google 終於把內部最強的科學代理能力開放出來了。過去這些工具只用於內部模型與內部研究,外界只能從論文裡看到結果;現在整個 /teamwork、/boost、Deep Review 對外開放,還附贈一萬個免費學術席位——這不是慈善,是生態系鎖定:一旦研究人員的驗證工作流跑在 Lean 產物與 Antigravity 上,這套工具就成了科學研究的基礎設施,而 Google 是唯一能持續升級它的供應商。
最後是那個 Rust 改寫的細節:初版比 C++ 慢 4 倍,最後比手寫組語快 20–30%。這說明整件事的價值不在「AI 寫了 Rust」,而在於代理能自己找到效能瓶頸並且用工具驗證自己的假設。這比「AI 生成程式碼」是巨大得多的一步。
數據解讀與質疑
第一,成果全部由作者自述,缺少獨立重現。 這是所有 AI 科研新聞共通的問題,而這次更明顯。Magica 在分析 Google 前一批 Teamwork 成果時就點出關鍵:那些展示用的部分執行使用了比產品預設配置更高的平行代理數量,而且「僅憑 token 價格無法確立每個已驗證結果的成本」。官方在 2026/08/31 的摘要中說七個開放問題被解決,但 8/27 的技術版本對這「七個」做了重要區分——例如 Erdős 單位距離結果是在無網路環境下獨立重現了既有突破,Knuth 的 Cycles 只是給出「偶數整數情況中兩種較簡單構造的首個證明」,而非所有情況的無限制解決。Magica 也特別點出量化論文裡的 5.93 倍是「誤差界限前導常數的約 5.93 倍縮減」,不是某個 AI 應用上實測的 5.93 倍加速。這些區別在官方原文裡被埋在很深的段落中,卻直接決定了「新突破」四個字的份量。
第二,Hacker News 的反應相當冷淡,而且點出的問題很準。 討論串拿到 208 分與 49 則回覆,但高票留言多在挑文筆與邏輯,而不是驚嘆。網友 avodonosov 指出「把下界簡化」不是正常數學說法;lern_too_spel 指出「8 天內獲得 2,600 Elo、達到 1,885 Elo,介於 KataGo 每步 16 與 32 次訪問之間」這句本身語意不通——1,885 與 2,600 是不同時間點的數字,句子把它們併在一起反而讓人無法判斷真實區間。還有資深研究者 dava96 指出,Rust 改寫在最佳化前比 C++ 慢 30%,那麼如果他們有最佳化 C++ 版本,是否能獲得比 Rust 更大的收益?這個問題官方完全沒有回答。
第三,成本與隱私問題幾乎沒被談到。 X 上的討論更直接:@asmirkn 說「多代理系統跑開放問題,token 消耗是會燒到瘋的,我在這裡面完全看不到每解出一個問題的成本」;@lwytch 點出真正的瓶頸是帳號用量與 API 成本,再加上消費級帳號在活動開著時被強制用於訓練。官方公布的確切數字只有「28,800 次子代理調用」與「兩週活動」這類時間尺度指標,沒有任何一項成本數據。對一個宣稱要開放給 10,000 名學術研究者的工具來說,這是個很大的空白。
第四,署名權與激勵結構仍然模糊。 多數結果由「Google 與學術合作方」共同完成,但代理實際完成了大部分勞動。論文的作者名單仍然是那幾十位具名研究員,代理貢獻既不署名也不列於致謝。網友 kats 甚至開了玩笑說「Google 就像微軟和 Intel 錯過手機那樣錯過了 LLM」——這句話雖然在講產品體驗,但諷刺的是同一件事:整個系統的說服力取決於外部世界能否獨立驗證,而目前沒有。
Siami 觀點
這則新聞真正的重量,不在「AI 又解決了幾個數學問題」——那個表述本身把這件事說小了。它真正的重量在於驗證機制的商品化。
過去二十年,軟體工程靠編譯器與測試套件建立了「機器可檢查 = 可信」的範式,人類因此敢於把關鍵系統交給機器執行。數學領域一直缺這個東西——Lean’s 存在,但只有少數專家會寫。今天 Google 把「寫 180 萬行 Lean」變成一個按鈕,意味著形式化驗證從專家技藝變成了可外包的產能。
如果這條路走通,數學研究的分工會被徹底改寫:人類學者的工作重心從「寫出證明」轉向「提出值得證明的問題」與「設計反證策略」。這是更純粹、更稀缺、也更像真正專家價值的那種工作。
但同一件事的陰影面也很清楚。當驗證變成商品,驗證本身的可信度就必須靠成本透明度來維持。 目前這批成果的成本數據是缺席的——讀者無法知道「180 萬行 Lean」背後燒了多少 token、多少小時、多少不眠不休。Magica 對前一批成果的追問(「每個已驗證結果的成本是多少」)在這一批同樣成立,而且沒被回答。當一個領域開始用「億行」與「萬次調用」來描述成果,而不談美元與小時,社群很自然會開始懷疑:這些數字裡有多少是能被外部重現的?
接下來三到六個月會看到第一批外部重現報告,不管結果是正是反。那些報告的品質,將比這次的官方公布更能決定「AI 能否做前沿科學」這個命題是真進展還是一場行銷。
至於 Rust 改寫 libgav1 最後反過來比手寫組語快 20–30% 這件事——那是整份公告裡最讓人興奮的一行數字,因為它代表的不是「AI 很會寫程式碼」,而是「AI 會驗證自己的直覺」。前者是生成,後者才是科學。
延伸閱讀
- Google Research 官方部落格原文:Advancing science & engineering with Antigravity’s /teamwork(2026/11/13)
- Antigravity 官方文件:Teamwork agent teams (/teamwork)|團隊協作模式說明
- Antigravity 官方部落格:Teamwork: when AI becomes a research partner(2026/08/27)
- Antigravity 官方頁面:Why choose Google Antigravity for science(10,000 名學術研究者免費申請)
- Google Research 官方 X 貼文(2026/11/13)|Vahab Mirrokni 成果清單貼文
- Interesting Engineering 報導:Google’s Antigravity agents formalise major mathematical proofs(2026/11/13)
- Magica:Google reports seven Teamwork math results(2026/11/13,第三方獨立質疑與成本分析)
- Hacker News 討論串(208 分/49 則回覆)
- Google Research 官方 X 頻道|Google Antigravity 官方 YouTube 頻道
網友熱門留言 (12)