編按:本文綜合整理自 TechNews〈Memories.ai 推出 Memories Upload 零工平台,付費請大家拍影片給機器人看〉(2026/11/15)、Fortune 獨家〈In the Race for Robot Training Data, Ex-Meta Researchers Startup Turns to Gig Workers With Cameras〉(2026/11/10)、Memories.ai 官方部落格〈Introducing Memories Upload: First-Person Video, Ready to Train Robots〉、The Robot Report〈Memories.ai builds standardized egocentric video pipeline〉、CryptoBriefing、TokenPost、Physical Intelligence 研究〈Emergence of Human to Robot Transfer in Vision-Language-Action Models〉(arXiv:2512.22414)、Stanford HAI AI Index Report 2026、micro1 官網〈Get paid to record tasks〉,並加入 Siami 編輯部觀點與分析。文中所有數字均為各公司自行公布,非第三方稽核結果,已於文中分別標註。
2026 年 10 月 28 日,美國舊金山。一個叫 Memories Upload 的平台正式上線,做的事情聽起來很簡單:付錢請普通人戴著攝影機,錄下自己煮咖啡、修腳踏車、備餐、補貨架的過程。
這些第一人稱影片不會進入任何社交平台。它們會被切成片段、標註動作、對齊時間戳,然後賣給機器人公司——用來教機器人怎麼做事。
這是 Meta 前研究員 Shawn Shen 與 Ben Zhou 在 2025 年 7 月拿到 800 萬美元種子輪(Susa Ventures 領投、Samsung Next 參投)後,交出的第一份成績單。
一、平台怎麼運作:45 克的相機、6 到 18 美元的任務
攝影機叫 LUCI Pin,重量不到 45 公克,以磁吸方式固定在頭帶、胸前、頸部、帽子或手腕的支架上。兩台配對可以拍立體影像,用於估算深度。公司表示,寬廣的視野可以同時把「雙手和正在處理的任務」放進畫面——這正是外部拍攝做不到的事。
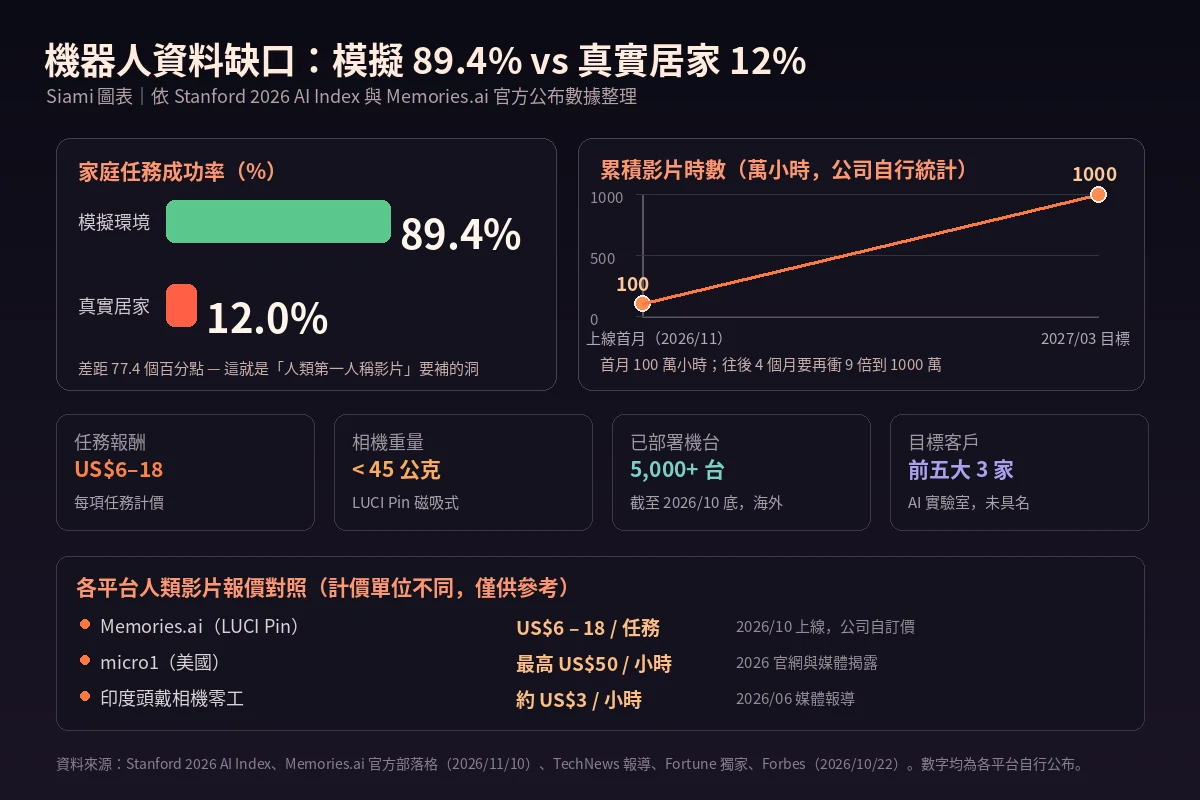
平台採任務制。參與者可以領取有償拍攝任務,內容涵蓋備餐、商品上架、設備維修等需要雙手操作的工作。依 TechNews 引述韓國媒體 TokenPost 與 CryptoBriefing 的報導,每項任務報酬 6 至 18 美元。平台舉例的任務包括切菜與修理腳踏車。
創辦人 Shawn Shen 的說法是:客戶愈來愈希望影片涵蓋更多元的工作環境、任務與拍攝角度。即使同樣是煮咖啡,兩個人在不同廚房完成,也能提供有用的差異。開發商也要求手腕視角,用來捕捉頭戴式攝影機可能漏掉的細節,例如手究竟在哪一刻碰到物品。
二、數字看起來很猛,但都是公司自己說的
以下是 Memories.ai 官方公布的數字,全部未經第三方稽核:
- 平台測試版上線首月累積超過 100 萬小時的第一人稱影片
- 目標在 2027 年 3 月前蒐集逾 1,000 萬小時
- 截至 2026 年 10 月底,有超過 5,000 台 LUCI Pin 部署於海外
- 客戶包含「全球前五大尖端 AI 實驗室的三家」,以及多家機器人開發商,但以保密協議為由未透露名稱
官方部落格裡寫得更直白:「語言模型靠網路上發表的人類知識紀錄學會寫作、推理與解釋。機器人需要的是它的物理版本——人們真的在做事的第一人稱影片。沒有人建出過這種規模、多樣性與品質的紀錄,而機器人訓練正需要它。」
三、背後的技術:Nvidia Cosmos 標註 + LVMM 索引
Memories.ai 與輝達合作,採用 Metropolis 影片搜尋與摘要工具處理影片。其影片描述模型以輝達的實體世界理解模型 Cosmos 微調而成,動作標註同樣使用 Cosmos 系列模型,並會針對客戶的特定任務進行後訓練。系統產生的描述會對應到影片特定時間點,開發商搜尋某個動作就能調出相關片段,不必逐一觀看數小時的影片。
在資料庫這一層,公司自研的 LVMM(Large Visual Memory Model) 會把每一小時影片索引成帶時間戳的字幕與向量,官方宣稱比傳統方式少了約 95% 的視覺 token。資料湖也提供 MCP 工具,讓任何 agent 直接對著整個資料庫查詢——例如餵給它一個失敗模式,它會找出全庫中類似的時刻,回傳一份可直接用於微調的子資料集。
Nvidia Cosmos 產品與工程總監 Rick Zhuang 對這件事的態度相當保守。他指出,辨識出某項活動,和理解手如何握住工具、移動物體是兩回事;鏡頭晃動或物體被部分遮擋時,難度更高。他認為,手部動作細微或動作邊界模糊時,人工審核不可或缺,人類影片也最好與機器人示範及模擬資料搭配使用。
四、這不是第一家在做,但是規模不一樣
Memories.ai 踩上的是一條已經有人走過的路。
Figure 透過 Index 平台付費請人錄製日常任務,用來訓練 Helix 模型。開發機器人通用「大腦」軟體的 Physical Intelligence,則測試將人類影片與遙控操作資料結合。共同創辦人 Sergey Levine 認為,這類補充資料能讓模型了解真實世界可能發生的情況,與機器人自身蒐集的資料相輔相成——但開發商仍須設法把人類動作轉換成適合機器人身體結構的動作。PI 的研究〈Emergence of Human to Robot Transfer in Vision-Language-Action Models〉給出了機制解釋:先用機器人資料預訓練模型,再用人類影片微調,人類到機器人的遷移效果會隨模型規模浮現。
在更廣的市場上,micro1 在美國以每小時最高 50 美元的價格收購這類資料,2026 年 4 月《MIT 科技評論》專題報導指出,加州的零工經濟正因而出現新的「演算法演員」族群;華盛頓郵報 4 月的互動專題也記錄了這批攝影工。印度則有頭戴相機的零工,時薪約 3 美元。
差別在量體。Memories.ai 的說法是首月 100 萬小時、目標 1,000 萬小時——而這個數字的前提,是 Stanford 2026 AI Index 揭示的那個洞:機器人在模擬環境中能完成 89.4% 的家庭任務,搬進真實居家環境後只剩 12%。官方部落格把這 77.4 個百分點的落差,直接當成 Memories Upload 存在的理由。
五、隱私與同意:這是整件事最脆弱的一環
拍攝過程必然會帶到同事、路人、居家空間。這部分 Memories.ai 的說法是:配戴者及經常入鏡的同事必須先簽署同意書;影片離開拍攝國家或交付客戶前,公司會以自動化工具模糊其他人,並遮蔽識別證、螢幕與車牌等資訊;每批影片也會抽樣人工檢查,確認敏感細節已經處理。
官方部落格另外承諾三件事:貢獻者必須先同意錄影規則,包括「絕不拍攝私人螢幕或文件」;不販售音訊;以及貢獻者可以在公司付款前隨時刪除片段。
這三條聽起來合理,但有個現實問題:同意書是為了影片裡的第三方而簽的,不是為了貢獻者自己未來的生活而簽的。 一段「煮咖啡」的影片裡,可能同時包含一把特定型號的刀、一個特定品牌的電鍋、以及一段對話裡提到的地址。模糊人臉不等於移除這些資訊。
為什麼這件事重要
這是把「人類生活」變成機器人訓練燃料的完整商業化。 語言模型可以爬整個網際網路,因為那些內容本來就是為了被看而產生的。物理世界的資料沒有這個特性——沒有人會為了讓機器人學會翻鍋而認真拍下自己翻鍋。所以過去十年,機器人訓練資料的來源只有三種:研究人員自己架設的實驗室、昂貴的遙控示範、以及simulation。每一種都貴且慢,這也是為什麼人形機器人的「泛化」一直卡在示範階段。
Memories.ai 的做法是把採集成本外包給零工經濟。6 到 18 美元一項任務,換來 45 公克相機、標準化流程,以及數百萬小時的第一人稱影片。 這個模式一旦跑通,「機器人訓練資料」的供給曲線會跟計算資源的曲線一樣往右移。
對台灣的啟示尤其直接。這是一門不需要高學歷、卻需要動手能力的零工。 記得去年底那些新聞嗎——西螺工廠缺工、AI 導入產線的相關人才。中國與印度已經開始出現「戴頭戴相機的資料採集員」這種職業,台灣目前還沒有對應的通路,但技術門檻幾乎是零:一台相機、一個手機 App、一份同意書。
但更有意思的,是這件事反過來揭露的問題:當機器人公司開始用「你家的廚房」當訓練場時,誰決定了機器人未來的動作準則? 誰煮咖啡的手法會變成機器人的預設動作、誰家的整理順序會被寫進模型?這些都是零工經濟裡看不見的決策權轉移。
數據解讀與質疑
質疑一:89.4% 對 12% 這個對比,基期定義是什麼? 這是 Stanford AI Index 2026 的數字,官方部落格引用它來說明資料缺口。但「模擬環境的家庭任務」與「真實居家的家庭任務」是兩個不同的測試集——物件擺放、擾動程度、任務細節定義都可能不同。落差是真的,但把它精確解讀成「只要補 77.4 個百分點的人類影片就能解決」,是把統計學說得太滿了。人類影片能不能補上這個缺口,取決於它在模擬與真實之間的遷移效果,而這正是 Physical Intelligence 的研究要回答的問題——不是 Memories.ai 的。
質疑二:100 萬小時 vs 1,000 萬小時的目標,成長速率需要 9 倍。 首月 100 萬小時若真實,代表平均每天約 33,000 小時的產出。而要在接下來 4 個月推到 1,000 萬,等於每天要產出約 76,000 小時。這是成長速率要拉高 2.3 倍,而且是連續 120 天。 招募零工是相對容易的,但維持足夠的「任務品質與一致性」是另一回事——官方自己說每批都要抽樣人工檢查,人力成本會隨片量等比上升。這條曲線能不能走完,是這家公司最大的不確定性。
質疑三:「前五大 AI 實驗室的三家」這個客戶數字,等於什麼都沒說。 全球前五大尖端 AI 實驗室通常是規模最大的幾家(包括造出前沿模型的機構與雲端巨頭)。這三家是自建資料部門、還是外購?如果是前者,Memories.ai 賣的是「比自建便宜的補充資料」;如果是後者,那是因為他們沒有足夠的實地採集管道。在保密協議下,讀者無從判斷是哪一種。 這也是本文不把「客戶」當成競爭力證據的原因。
質疑四:任務報酬的跨平台比較,因為計價單位不同,其實不能直接比。 Memories.ai 是「每項任務 6–18 美元」,micro1 是「每小時最高 50 美元」,印度零工是「每小時約 3 美元」。任務耗時多久,直接決定了每小時實際收入。若一個任務要 30 分鐘,6 美元等於每小時 12 美元;若要 3 小鐘,就只有每小時 2 美元。 這是數字比較裡最容易被誤讀的地方,也是對真正想參與的零工最重要、卻最少被揭露的資訊。
質疑五:隱私機制的漏洞不在人臉,在物體。 官方列出的遮蔽項目是識別證、螢幕、車牌,這是對的,但清單裡沒有「物品身分」。一段沒有任何人臉、沒有任何螢幕的影片,照樣可以洩漏:這是誰的廚房(火焰裝潢、特定流理台)、這是誰的工具(專業級電動工具)、這是什麼工作場所(工單上出現的工廠名稱)。「人臉模糊」在法律上容易被稱為隱私保護,在實務上卻是最容易做到、也最不充分的一層。
Siami 觀點
這是一篇不該被寫成「AI 又要取代人類」的報導。
那種框架在這裡是錯的。Memories.ai 沒有在取代誰的什麼工作——它創造了一個新工作,而且這個新工作在未來兩三年可能會出現在台灣的招募平台上,名字大概會叫「具身智慧資料採集員」或「機器人示範員」。
真正值得注意的是它的時序。這家公司的種子輪是 800 萬美元,平台 2026 年 10 月才上線,卻已經開始跟全球前五大 AI 實驗室中的三家談供應。在人形機器人還沒有真正走進任何一間工廠的時候,訓練資料的戰爭就已經打到如火如荼。 這說明產業的瓶頸已經很清楚:模型不是問題,資料是。而誰能以最低成本穩定供應最大量、最高一致性的物理世界紀錄,誰就定義了下一代機器人的能力邊界。
第二個值得看的是這門生意裡最反直覺的一點:最值錢的資料是「失敗的」。 官方說 AI 會評分「任務做得有多好」,每一個通過驗收的小時才計費;同時資料湖的 MCP 工具設計目的,是讓 agent 餵給它一個失敗模式,它就去全庫找出類似的時刻。這意味著被判定為「做得不好」的片段——切到一半停住的菜、打翻的杯子、卡住的螺絲——才是最有價值的部分。 但它們也是最難被標準化、最難被定價、最難說服零工願意持續提供的那部分。
第三點,也是最值得持續追蹤的一點:這是「資料被徵用」的下一個現場。
回想一下過去幾年,已經有過幾波類似的爭議——爬蟲與版權、AI 模型的訓練資料來源、生成式 AI 的創作糾紛。每一波的反應都晚了一拍,因為當時沒有人預見那條路會通。而現在,一個新的現場正在成形:不是從網路上拿資料,而是從你身上收資料——你的手、你的廚房、你的工作流程、你的證件。
平台的同意書寫得很乾淨:貢獻者可以刪除片段、不販售音訊、同事要簽同意書。這些都是進步。但同意書處理的對象是「片段」,而這門生意的邏輯要求片段必須被累積成數十萬小時的語料庫,然後被標註、被索引、被餵給模型後訓練。在這個尺度上,「刪除一個片段」這個承諾的實務效力,是需要被持續追蹤的。
對台灣而言,兩件事值得開始留意:其一,如果未來有類似平台在台灣開站,勞動條件與資料同意權是兩件要分開談的事,不能因為「有報酬」就把它當成一般打工;其二,個資法與工作契約的邊界會被這個模式推到模糊地帶——你在家裡錄影,家裡的門口、書桌上的文件、螢幕上還沒關掉的對話,全都在鏡頭裡。
延伸閱讀
- TechNews:Memories.ai 推出 Memories Upload 零工平台,付費請大家拍影片給機器人看(2026/11/15,本次主要來源)
- Fortune 獨家:In the Race for Robot Training Data, Ex-Meta Researchers’ Startup Turns to Gig Workers With Cameras(2026/11/10)
- Memories.ai 官方部落格:Introducing Memories Upload — First-Person Video, Ready to Train Robots(含 Stanford 89.4%/12% 數據與隱私三承諾)
- Memories.ai 官方產品頁:Memories Upload — Real-world data for physical AI
- The Robot Report:Memories.ai builds standardized egocentric video pipeline(含 Memories-H0 手部姿勢模型與 EgoAction 動作切分)
- arXiv:Emergence of Human to Robot Transfer in Vision-Language-Action Models(Physical Intelligence,2025/12)
- Physical Intelligence 官方研究頁:Human to Robot Transfer
- Stanford HAI:The 2026 AI Index Report(含機器人模擬 vs 真實居家成功率)
- CryptoBriefing:Memories.AI launches Memories Upload, a gig-work platform for robot training(每項任務 $6–18)
- TokenPost:Memories.ai Memories Upload 平台報導(LUCI Pin 45 公克、5,000 台部署)
- micro1 官方頁:Turn your trade skills into AI training data and get paid for it(美國同類平台,每小時最高 $50)
- MIT Technology Review:The gig workers who are training humanoid robots at home(2026/04/01)
- Los Angeles Times:Why people in L.A. are strapping cameras on their bodies to do chores(2026/03/12)
- Washington Post:See why tech companies are paying people to do chores(2026/04/17,每小時最高 $25)
- 影片:Memories.ai 官方頻道 — Memories Upload | First-Person Video, Ready to Train Robots
- 影片:NVIDIA Omniverse 官方頻道 — Video to Data Challenge: From Human Video to Robot Skills
網友熱門留言 (6)