編按:本文綜合整理自 Jakub T. Jankiewicz〈All AI-generated code should be Open Source〉(2026/11/15,個人部落格)、Hacker News 討論串(1,100 分/597 則回覆)、All Things Open〈The copyright problem with AI-generated code〉(2026/08/05,作者 Jim Hall)、美國版權局《Copyright and Artificial Intelligence, Part 2: Copyrightability》(2025/01/29)、第九巡迴法院 Naruto v. Slater 判決(2018/04/23,案號 16-15469)、EFF〈Victory! Appeals Court Rejects Expansive New Copyright Claim〉(2026/09/16)、Stack Overflow Developer Survey 2026〈AI Data〉、Black Duck《2026 Open Source Security and Risk Analysis Report》、arXiv〈A Large-Scale Comprehensive Measurement of AI-Generated Code in Real-World Repositories〉(2603.27130)、英國《Copyright, Designs and Patents Act 1988》原文 與 Wikimedia Commons〈AI-generated media〉指引,並加入 Siami 編輯部觀點與分析。文中所有數字均標明係官方報告、法院判決或調查統計,爭議性推論已於文中明確標示。
2026 年 11 月 15 日,Hacker News 上一篇只有一千多字的個人部落格文章,拿下 1,100 分、597 則回覆,幾乎是一夜之間把「AI 寫的程式碼到底該不該開源」推成了整個程式設計圈的公投。
作者 Jakub T. Jankiewicz 是波蘭工程師、資深開源開發者,也是 Wikimedia Polska 的Trainer。他的主張只有一句話,但拆開來有四根支柱:
- 訓練資料的來源有問題。 AI 模型是在自由軟體運動以來累積的龐大開源程式碼語料上訓練的,那些碼是被抓取來用的,沒有取得許可、也沒有適當署名。Stack Overflow 與姊妹站的內容則以 Creative Commons 授權釋出,法律上要求署名。把這些集體知識轉成專有、閉源程式碼,構成的是「授權洗白」(license laundering)。
- 純 AI 產出的程式碼在美國不受版權保護。 既然沒有版權,也就沒有版權人。
- 各國規定不同。 英國等國對電腦生成作品給予有限保護,為了跨法域公平,開發者與公司應主動用開放原始碼授權或 CC0 釋出 AI 生成的程式碼。
- 實務上人類已經很少真的在寫。 開發者愈來愈依賴 AI,甚至連檢查產出都省略,更別說改寫成符合自身需求。這種只花了打字提示詞功夫的程式碼,應該開源。
Hacker News 上最高票的反駁只有一句話:既然 AI 產物沒有版權,掛上開源授權就是無效動作。第二名的補刀更直接:授權本質上是一份「不提起版權侵權訴訟」的協議——沒有版權權利可以放棄,這份協議就不成立。
另一派則主張作者自相矛盾:模型是在海量開源語料上訓練的,人類工程師何嘗不是讀著 Stack Overflow 與開源專案學會寫程式?那照這個邏輯,所有受過人類知識餵養的程式碼都該開源,開源運動會不會因此自我瓦解。
一、Monkey Selfie 案到底在說什麼
作者的第二根支柱援引的是著名的「猴子自拍案」。這樁案子的事實其實相當簡單:2011 年一只猴子在攝影師的相機上按到快門,自拍了幾張照片,攝影師 Wendy Mack 試圖用版權註冊,被美國版權局拒絕。
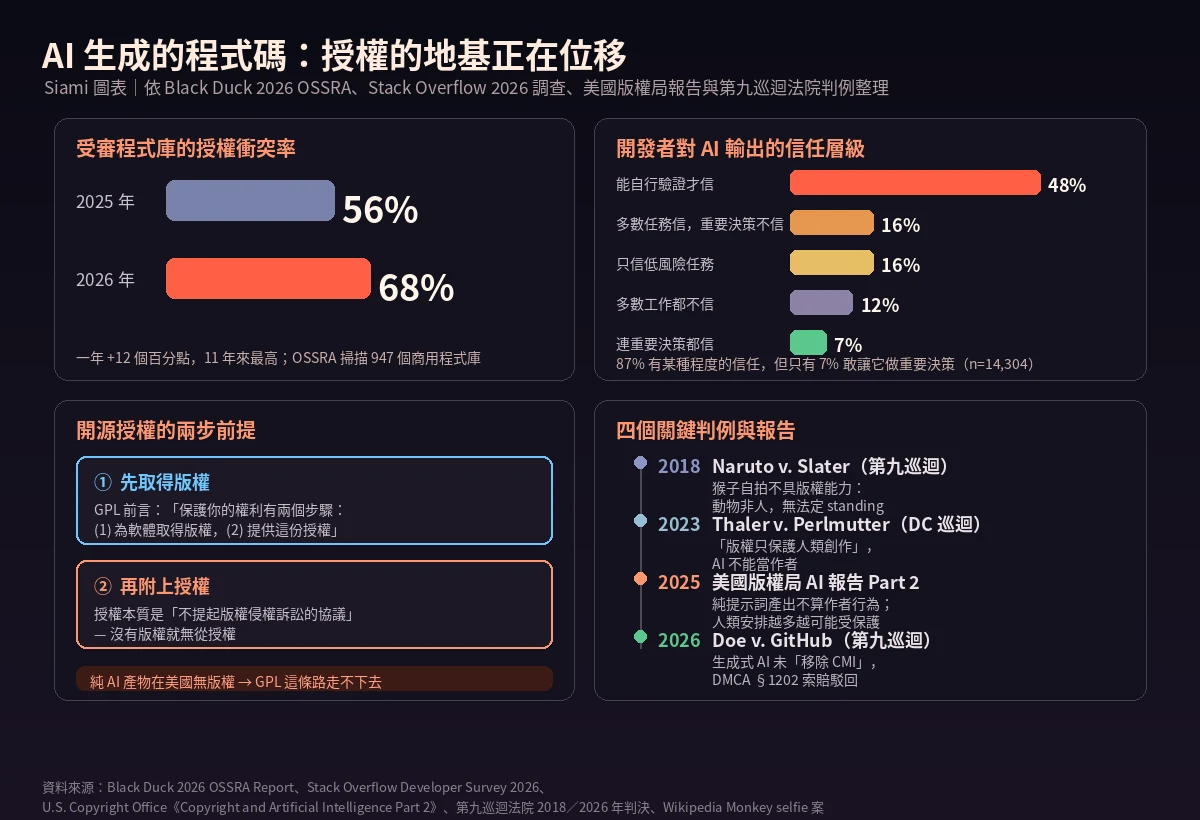
2018 年 4 月 23 日,第九巡迴法院在 Naruto v. Slater(案號 16-15469)中駁回 PETA 的訴訟,理由寫得非常直白:
「本院結論是,這只猴子——以及所有動物,因為牠們不是人——在《版權法》下欠缺當事人適格。」
但這樁案子在 2026 年被反覆引用時,有一個關鍵的法律區別經常被抹掉:它處理的是「誰有權利起訴」的當事人適格(standing)問題,不是「AI 產物能否獲得版權」的作者身分問題。
真正處理作者身分的是 Thaler v. Perlmutter。2023 年,華盛頓特區地方法院駁回 Stephen Thaler 為「完全由演算法自主創作」的圖像申請版權,理由是「版權法只保護人類創作」,並引用猴子自拍案作為旁證。2025 年 3 月 20 日,DC 巡迴法院進一步確認:AI 不能持有版權。
差別在於,動物連「作者」這個位置都進不去,而 AI 生成的內容在整條法律鏈上被視為「沒有作者」。兩者都導向「沒有版權」,但走的路完全不同——引用時不能混為一談。
二、美國版權局 Part 2 報告:門檻不是零,而是「比例」
2025 年 1 月 29 日,美國版權局公布《Copyright and Artificial Intelligence, Part 2: Copyrightability》報告,全文 52 頁(含註腳後有效頁數約 25 至 30 頁),是迄今為止對 AI 生成物版權問題最完整的官方說明。
報告的核心立場有兩層:
- 純 AI 產出不受版權保護。 報告援引該局先前的指引:「當一項 AI 技術只從人類那裡收到提示詞,並依此產出複雜的文字、視覺或音樂作品時,作者的『傳統要素』是由科技決定並執行的,而不是人類使用者。」
- 但門檻是比例原則,不是全有全無。 報告說得很清楚:報告沒有硬性規定一個人可以用多少 AI 仍能主張版權,這些問題需要逐案判斷;一般原則是人類在過程中做的決定越多(例如重新安排 AI 產出的組織方式),該人類就越可能主張版權。
報告裡的官方措辭相當精準:AI 生成的產出不可能與使用者構成共同著作(joint work),但「共同作者」的類比可以拿來評估某人是否貢獻了足夠的表達。報告援引一句話:「一個只是描述作者應該做什麼或看起來如何的人,並不是《版權法》下的共同作者。」
換句話說,這就像委託畫家畫肖像——你要求他把鼻子畫小一點、背景改成花園,並不會因此變成「共同畫家」。你只是描述了成品,真正做作品的是別人。
作者文章裡那句「人類安排越多越能主張版權」的反面,同樣重要:當你只是打字提示詞、其餘全部交給模型時,你很可能一點版權都拿不到。 這正是「vibe coding」在法律上的真實處境。
三、開源授權的兩步前提:為什麼 GPL 會卡住
All Things Open 2026 的講者、FreeDOS 專案開發者 Jim Hall 在〈The copyright problem with AI-generated code〉一文裡,點出了整件事最要命的一環。所有開放原始碼授權,從最早的「自由軟體」授權到 GNU GPL,都建立在版權之上。
GPL 前言寫得很清楚:
「我們用兩個步驟保護你的權利:(1) 為軟體取得版權,(2) 提供這份授權,給你法律許可去複製、分發和/或修改該軟體。」
授權本質上是一份協議——授權人承諾不行使版權權利。如果沒有版權權利可以放棄,這份協議就是空的。套回前面的討論:純 AI 產出的「vibe coding」專案,在美國很可能根本沒辦法掛上 GPL。你沒有東西可以授權。
Hall 的結論相當保守但準確:AI 寫程式碼的比重越高,開發者越不可能對成果持有版權;極端的 vibe coding 情境下,可能連一點版權都主張不了,而因為開源授權依賴版權,也就連開源授權都放不上去。
這裡出現了一個尖銳的諷刺:作者提的解方(用開源授權釋出 AI 程式碼),在他的第一根支柱(AI 產物無版權)成立時,法律效果恰恰是零。 這也是 HN 上最高票反駁的核心。
另一個被忽略的現實是,開源從來不只是「授權」。它同時是一種治理與信任機制:誰維護、誰審查、誰回應安全漏洞、誰承擔責任。HN 上一位網友把這點講得很清楚——「開放原始碼的價值正在位移:開放原始碼指的是經過人類驗證的程式碼。把生成出來的東西直接開源並沒有價值。」
而「授權本身還做了很多事」也是關鍵:GPL 的著作權利豁免(poison pill)機制、保證免責條款、專利授權條款,這些都不是版權授權,而是用版權當交換籌碼的合約設計。
四、英國的例外,以及猴子自拍的真正戰場
作者第三根支柱援引英國法:《Copyright, Designs and Patents Act 1988》第 9(3) 條與第 12(7) 條規定,電腦生成作品的作者被視為「作出必要安排以創作者」的人,保護期 50 年。換句話說,英國在法律上承認電腦生成物可以有版權。
這個條文在學界並不受歡迎。King’s College London 的版權法研究者 James Parish 在 2025 年發表的論文中,標題直接就是「是時候廢除《1988 年版權、設計與專利法》第 9(3) 條」,並從遊說與立法史重新檢視這條臭名昭著的英國電腦生成作品條款。而 Wikimedia Commons 的〈AI-generated media〉官方指引裡,英國、中國大陸、香港三地被分開處理,正是因為各法域對「人類作者要件」的處理方式並不相同。
值得注意的是,2026 年 9 月 16 日第九巡迴法院的 Doe v. GitHub 判決,讓開源社群暫時鬆了一口氣。一群匿名 GitHub 貢獻者起訴,指控 OpenAI 與微軟用 GitHub 上的程式碼訓練模型,產出的新程式碼與他們的作品雷同但去除了版權管理資訊(CMI),主張違反 DMCA 第 1202 條。第九巡迴法院駁回,認定生成式 AI 並未「移除或改變」CMI。EFF 把它稱為「勝利」,直言聯邦上诉法院擋下了一項試圖擴張的新版權責任。
這個判決的意義不在於 AI 沒有版權問題,而在於它把責任推回訓練階段:版權主張要往「模型是不是用受版權保護的訓練作品來訓練」這個方向走,而不是「生成出來的東西沒署名」。
五、數據面:衝突率在飆,但崩潰的預言還沒到
作者的文章沒有帶數據,但市場數據就在旁邊。
Black Duck《2026 Open Source Security and Risk Analysis Report》掃描 947 個商用程式庫,發現68% 含有授權衝突,比 2025 年的 56% 上升 12 個百分點,是這份報告 11 年歷史上最高的一次。報告把主要成因指向傳遞性依賴(transitive dependencies)的指數成長,而 AI 生成的程式碼正是把這條依賴鏈拉得更長、更難稽核的幫兇之一。Black Duck 官方頻道也針對 2026 年 OSSRA 做了完整帶讀。
Stack Overflow Developer Survey 2026 的信任數據則給了另一個方向的提醒:87% 的受訪者對 AI 輸出有某種程度的信任,但信任是有條件的——48% 說「能自行驗證時才信」,16% 只信多數任務但不信重要決策,16% 只信低風險任務,12% 大部分工作都不信,只有 6.6% 連重要決策都信(n=14,304)。同一份調查顯示 83% 的開發者已在工作上使用至少一種 AI 工具,其中 66% 使用程式碼助手類工具,且這些助手的使用者有 73% 每天都在用。
Google 的數字則常被拿來當「AI 已經寫掉大部分程式碼」的證據:Sundar Pichai 在 2026 年 4 月表示,Google 內部新產生的程式碼有 75% 由 AI 生成並經工程師核准,半年前(2025 年秋)這個數字是 50%;Meta 也設定內部目標,2026 年預期有 65% 的工程師用 AI 產生超過 75% 的提交程式碼。
但把三組數字放在一起,就會看到一個被口號掩蓋的落差:AI 產出的比例在飆升,「人類到底改了多少」的資訊卻在消失。 而版權判準恰好只看後半段。
為什麼這件事重要
三個理由。
第一,這不是法律獵奇,而是 8 位數規模的產業結構問題。 Black Duck 2026 OSSRA 的 68% 授權衝突率、Stack Overflow 2026 的 83% AI 工具使用率、Google 的 75% AI 生成新程式碼——三個數字指向同一個現實:程式碼的生產方式在幾年內被整體替換,而權利歸屬的規則還停在「人是作者」的舊世界。當產出端與權利端脫鉤,企業最先遇到的會是合約與盡職調查問題:客戶要授權聲明、保險要責任歸屬、監管要稽核紀錄,而這些問題都不會等法院給答案。
第二,它把「開源」這件事重新拆解成三層。 過去「開源」是單一概念:把程式碼公開並附上授權。接下來會分裂成三個獨立問題——發布(公開,大家看得到)、授權(法律效力,能不能商用、能不能追責)、治理(誰在維護、誰審查、誰承擔漏洞)。作者的方案只處理了發布層,而 HN 上最有力的反駁(授權需要版權才成立、開放原始碼的價值是經過人類驗證)精準命中了授權層與治理層。理解這三層的分離,才能理解為什麼「把 AI 產出的東西全部開源」聽起來很有道德說服力,卻在實務上什麼都沒解決。
第三,這是一個測量方法的教訓。 當產業用「AI 生成比例」當成長指標,用「授權衝突率」當風險指標,兩者都無法回答真正該問的問題:那 75% 的 AI 生成新程式碼裡,人類修改過的部分佔多少?真正需要被問的不是「這段碼是不是 AI 寫的」,而是「這段碼裡有多少表達性要素是由人類決定並承擔的」。arXiv 上〈A Large-Scale Comprehensive Measurement of AI-Generated Code in Real-World Repositories〉(2603.27130,2026 年 7 月修訂版)這類實測研究,正是往這個方向走——它首次在真實程式庫而非實驗室基準上量測 AI 與人類程式碼的差異,結論之一是真實世界裡 AI 與人類在程式碼層面指標的差距其實相當小,而不是如實驗室觀察所預期的那樣懸殊。
數據解讀與質疑
質疑一:Monkey Selfie 案的引用有法律類別錯誤。 猴子自拍案解決的是動物欠缺《版權法》下的當事人適格,是「誰能起訴」的問題;AI 生成物的版權爭議是「誰是作者」的問題。兩者結論相同(沒有版權),但推論路徑不同。真正對應的先例是 Thaler v. Perlmutter 與美國版權局 Part 2 報告。作者引用猴子自拍案在科普上好懂,在法學上卻容易讓讀者誤以為「動物不能有版權,所以 AI 也不能」是一條可以直接套用的規則。
質疑二:解方與前提互相抵消。 作者的第一根支柱(純 AI 產物無版權)一旦成立,第三根支柱(用開源授權釋出)就失去法律效力——因為授權是放棄版權權利的協議,沒有權利可放棄。HN 上最高票回覆正是這一點,且更有力的追問是:既然如此,這個提議實際效果只是讓人更不願意公開 AI 生成的程式碼(因為公開了也沒人追不到責任),方向與提案表面目標相反。要讓提案自洽,必須把前提改成「AI 產物有版權但業界選擇放棄」——而那與作者引用的所有判例都衝突。
質疑三:把「純 AI 產出」當成主要情境,是統計上的失準。 Part 2 報告的標準是比例原則,Google 的 75% 數字也明確包含「經工程師核准」。Stack Overflow 2026 調查顯示,48% 的開發者只在能自行驗證時才信任 AI 輸出,只有 6.6% 讓 AI 做重要決策。也就是說,真實世界裡「只打提示詞、完全不審查、完全不修改」的純 AI 產出,很可能遠小於 75% 這個數字所暗示的規模。用一個邊緣情境去推論整個產業的授權結構,會高估危機。
質疑四:開源社群真正的痛點不是授權,是維護。 作者自己舉了一個誠實的反例:他的專案大多是開源,但有一個不是,因為設計高度依賴領域經驗。HN 網友 regularfry 的區分很精準:「以開放原始碼釋出」跟「從來不釋出」是兩件事;另一位的說法更直白——「很多用 AI 寫程式碼的開源專案,會讓其他開發者不想參與,就像去銀行看別人點鈔,一點都不好玩。」把大批未經人類審閱的生成內容丟進開源池,可能稀釋的不是版權,而是信譽與維護能力。
質疑五:立法與產業實務的節奏根本不同步。 美國版權局的 Part 2 報告停在 2025 年 1 月,英國的電腦生成作品條文至今(2026 年 11 月)仍未廢除,而 Doe v. GitHub 才剛在 2026 年 9 月划出 DMCA 的界線。產業端(OSSRA 68%、Stack Overflow 83%、Google 75%)每一季都在刷新數字,法律端一年只出一兩份文件。用法律還沒跟上來否定或贊成任何一方,都太早了。
Siami 觀點
這場辯論真正的價值,不在於誰對誰錯,而在於它把「AI 時代的程式碼歸屬」從務虛的倫理問題壓縮成三個今天就能回答的具體問題。
第一個問題:這份程式碼裡,有多少表達性要素是由人類決定的? 這才是版權判準的真正核心。與其糾結「整個專案是不是 AI 寫的」,不如把每一段程式碼標註成「人寫的」或「模型產生的」。版權局報告的原則很直白——人類的安排與選擇越多,權利越可能成立。把這件事做成開發流程裡的常規記錄,比在法律灰色地帶裡靠運氣安全得多。
第二個問題:這個專案要釋出的是「發布」,還是「授權 + 治理」? 作者的提案只處理了發布。但對一個真的想用開源做事的團隊而言,發布只是入口——接下來是誰看 issues、誰審 PR、誰回應漏洞報告、誰承擔安全責任。願意做這件事的組織,和只是把檔案丟上 GitHub 的組織,是兩種完全不同的東西。AI 讓發布的成本趨近於零,治理的成本卻一點沒降。真正稀缺的是後者。
第三個問題:如果有一天真的要主張版權,證據在哪裡? 這是給工程團隊的實務提醒:把版本控制紀錄、code review 討論、提交訊息、決策紀錄留好。當「這段是不是 AI 寫的」成為法律問題時,這些紀錄就是「人類是否做出足夠表達性貢獻」的證據。GitHub 的 DCO 簽章機制本身就在處理同一個問題——只有人類能合法簽署開發者證明書,提交 AI 生成程式碼的人仍然必須逐行審查並承擔授權合規責任。
最後一點比較實際。對多數團隊而言,正確答案可能既不是「全部開源」也不是「全部閉源」,而是分層:核心的、決定產品價值的、需要長期維護的部分,由人類撰寫並保留完整版權與責任;樣板、測試、文件、重構產物這些人類不願意維護的部分,坦然接受它是模型產物,並且不要假裝自己擁有它。誠實地承認「這一段沒有版權可以給你」,比貼上一份實際上不生效的 MIT 授權誠實得多——也安全得多。
作者的文章之所以在 HN 上炸開,是因為他把一個真實的問題用一句響亮的話說了出來。而它之所以被 597 則回覆拆得體無完膚,也是因為那句話的骨架,比它自己以為的要脆弱。
延伸閱讀
- Jakub T. Jankiewicz〈All AI-generated code should be Open Source〉 — 原始文章
- Hacker News 討論串(1,100 分/597 則回覆) — 主要論戰場
- 美國版權局《Copyright and Artificial Intelligence, Part 2: Copyrightability》 — 官方報告全文(52 頁)
- All Things Open〈The copyright problem with AI-generated code〉 — Jim Hall 對 GPL 授權前提的拆解
- EFF〈Victory! Appeals Court Rejects Expansive New Copyright Claim〉 — Doe v. GitHub 判決分析
- 第九巡迴法院 Naruto v. Slater 判決原文(2018/04/23)
- Stack Overflow Developer Survey 2026〈AI Data〉 — 信任層級完整數據
- Black Duck《2026 Open Source Security and Risk Analysis Report》 — 68% 授權衝突率原始報告
- arXiv:2603.27130〈A Large-Scale Comprehensive Measurement of AI-Generated Code in Real-World Repositories〉 — 真實程式庫的 AI 程式碼實測研究
- Wikimedia Commons〈AI-generated media〉官方指引 — 各法域版權處理對照
- 英國《Copyright, Designs and Patents Act 1988》 — 電腦生成作品條文原文
網友熱門留言 (10)