編按:本文綜合整理自 Qwen 官方部落格〈Qwen4-Max: Your New Teammate Has Arrived〉(2026/11/16,Qwen Team)、Hacker News 討論串(202 分/58 則回覆)、Artificial Analysis 模型頁 Qwen4-Max、OpenRouter Qwen4-Max 模型頁、llm-stats〈Qwen4-Max-Preview Benchmarks, Pricing & Context Window〉、the-decoder〈Alibaba’s open-weight Qwen3.8-Max takes on long-horizon AI tasks with 2.4 trillion parameters〉 與 WorldofAI 頻道影片〈QWEN 4 Preview IS INSANE! First Look at Qwen 4 Max & 27B!〉,並加入 Siami 編輯部觀點與分析。文中所有基準分數與效能數字均為廠商自行測試結果,第三方尚未完成獨立重測,相關數字已在文中明確標示。
半年前,阿里巴巴的 Qwen3.8-Max 用 2.4 兆參數把開源旗艦的體感推到「接近前沿閉源」的位置。當時外界普遍認為,Qwen4 系列至少要再往上跳一個級距才配得上這個家族的名字。
11 月 16 日,Qwen 官方部落格正式發表 Qwen4-Max。這不是預覽版、不是偷偷放出的 API 端點,是完整發布:架構細節、訓練曲線、基準成績、案例展示、成本對比、API 定價一次到位。
一、架構升級:不是加參數,是換引擎
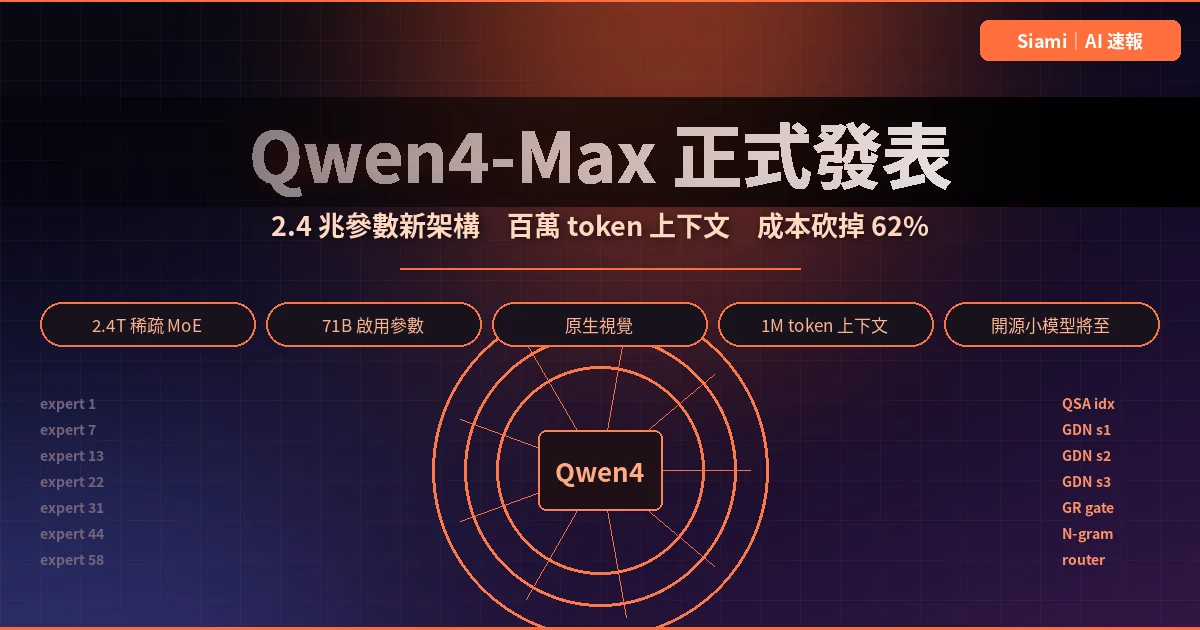
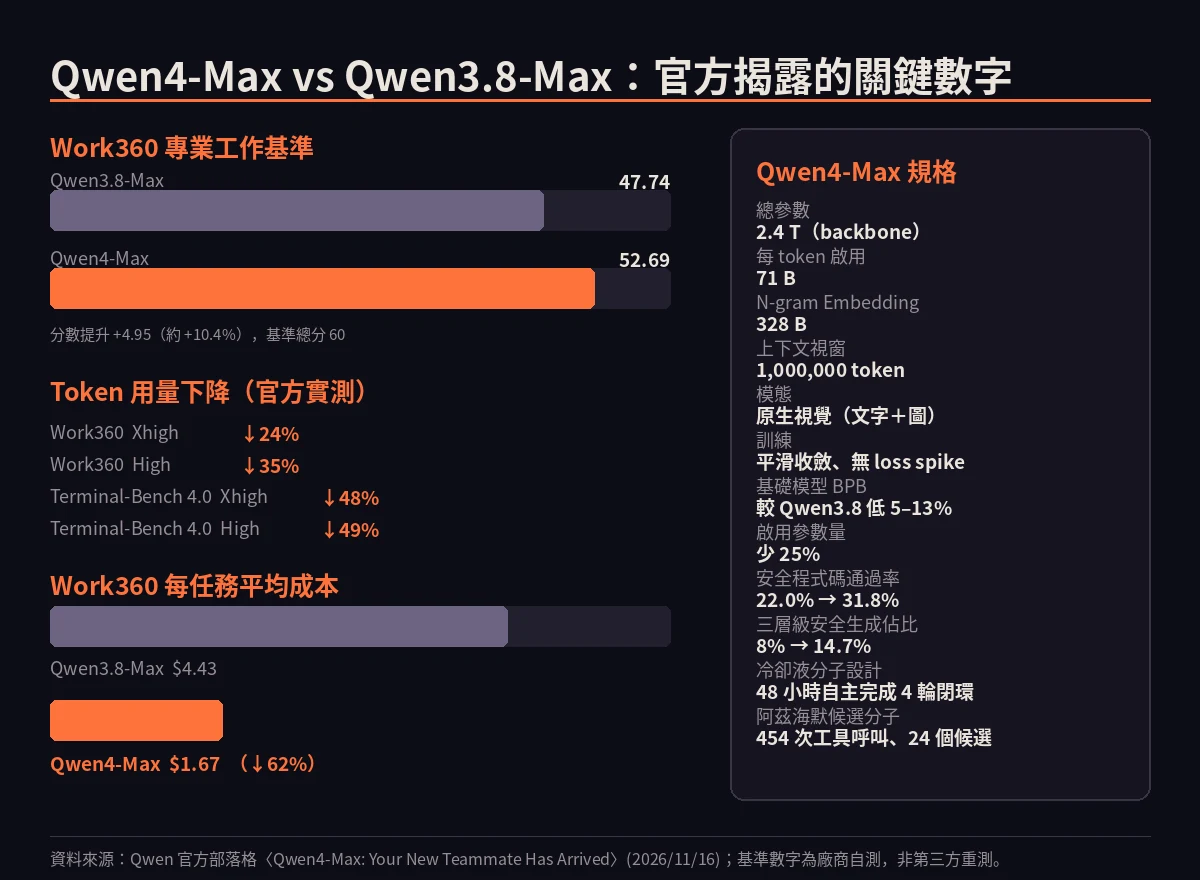
Qwen4-Max 建立在 Qwen4 系列的新架構上,backbone 總參數 2.4 兆,每個 token 實際啟用 71B 參數,另加 328B 的 N-gram Embedding 參數。上下文視窗拉到 100 萬 token,並且是原生視覺模型(文字與圖片同一套權重)。
官方把三項架構改動列為核心:
- GDN + Qwen Sparse Attention(QSA):三層 Gated DeltaNet 把歷史壓縮成固定大小的狀態,每層 QSA 再用輕量 indexer 在 micro-block 粒度挑出相關上下文,長序列的注意力與索引成本同時下降。
- Gated Residual(GR):四條平行殘差分支搭配動態讀寫閘門,改善跨層資訊流動與訓練穩定性。
- N-gram Embedding:在第二層做基於上下文的查表,直接補上局部 token 樣式的表示能力,額外運算成本極低。
預訓練過程沒有出現 loss spike,loss 平穩下降。內部評測顯示 Qwen4-Max-Base 在 Knowledge、Code、QA、STEM 四個領域的 bits per byte(BPB) 都是五個 checkpoint 中最低,較 Qwen3.8-Max-Base 低約 5–13%,而且啟用參數少了 25%。
換句話說,這一代的目標不是把模型堆得更大,而是讓每一分算力花得更有效率。
二、Work360:阿里巴巴自己定義的「真實工作」基準
官方這次主打的不是公開榜單,而是一套自建的 Work360 基準。Work360 的分類體系橫跨 26 個 Tier-1 領域、182 個 Tier-2 子領域、721 個 Tier-3 專門領域,用來模擬真實的專業工作情境。
Qwen4-Max 的 Work360 分數是 52.69,前一代 Qwen3.8-Max 是 47.74,提升約 10.4%。官方同時列出 JobBench、APEX-Agents v1.1、AA-Briefcase v1.1、AutomationBench-AA、CodeArena、AgentArena、HLAB-Vals-1.1、Agents’ Last Exam v1.1、ChartoGraphy 等基準,但沒有在文中公開完整對照表——腳註只寫明「分數引用自 Mercor/Artificial Analysis/Arena/Vals Index/Agents’ Last Exam 等第三方榜單」。
這裡有個關鍵細節:官方強調的不只是分數,而是同時省 token。在 Work360 上,Xhigh 推理強度的 token 用量下降約 24%、High 下降約 35%;Terminal-Bench 4.0 上則是 Xhigh 降 48%、High 降 49%。
三、真實案例:從工廠到ICU,模型被塞進了什麼場景
官方的案例展示刻意避開「寫個程式、寫篇文案」這類安全區,擺的都是高風險專業場景:
- 汽車製造:在 SANF 與 Pacific Union 的實際產線環境中,Qwen4-Max 用 2D 佈局與製程參數建立 3D 生產線模型、模擬節拍時間、做 PLC 虛擬調試;零件層級則涵蓋車門總成、摩擦輪等設計,並協助加工製程規劃與刀路生成。官方宣稱單一工件的人工程式設計時間從約 475 分鐘降到 24 分鐘,降幅約 95%。
- 金融投研:模型可調用 90 個 MCP 工具取得 A 股、港股、美股、債券、基金與衍生品的行情與財務資料,做多因子回測、股債利差分析與理論期貨基差計算,最終產出 Excel 工作簿與可編輯的 PowerPoint,並強調「點擊儲存格內超連結可直達原始資料來源」。
- Pre-IPO 法律盡職調查:面對 198 份格式不一致的律師工作底稿,模型篩除雜訊、依內容重新分類成 14 個資料夾、編製索引,並自動比對公開登記、智財權、司法與徵信紀錄,最終產出 86 頁、超過 6 萬字的報告,涵蓋 12 個審查面向與 14 項具體法律議題。
- 重症醫療:官方展示的案例中,病患在頸動脈支架置入後發生心室顫動、搶救後於拔管後第 6 天再次胸痛需重新插管。Qwen4-Max 在單一對話內處理數十份檢驗報告、超過 1 萬字病程紀錄與 1,433 張原始醫療影像,完成從資訊萃取到臨床決策支援的端到端流程。
- 科學發現:在 Deep Principle 的 Mira 平台上,Qwen4 進行 48 小時全自主的乾濕實驗閉環——從 270 萬個候選分子空間中篩選、預測性質、第一性原理計算、逆合成分析,一路驅動自動化濕實驗室合成與測試,四輪「設計 → 合成測試 → 主動學習」後產出實驗驗證過的新冷卻液分子。在 DP Technology 的 PharmMaster 平台上做阿茲海默症研究時,模型完成 454 次工具呼叫、3,239 次計算指標評估,設計優化 24 個候選分子,最終分子的標稱結合親和力約為參考分子的 3.6 倍。
四、Live Delivery 與雲端資源自我最佳化
Qwen4-Max 這代最特別的產品設計是 Live Delivery:長時任務不再等全部跑完才交付,而是先給一個可用版本,再以連續發布的方式擴充與修正,使用者可以隨時介入改方向。官方同時開源了 Qwen-Live-Delivery-Plugin。
另一個 showcase 讓模型「管理自己」。在阿里雲實際營運情境中,Qwen4-Max 自主產生候選演算法,與阿里的專有求解器 MindOpt 協作評估可行性、目標值與耗時,再透過改程式碼與交叉驗證反覆迭代。結果是:
- 資料標註的模型呼叫排程成本平均下降 10.42%
- 線上 GPU 排程的整機閒置容量時長增加 4.62%
- 離線 CPU 重排程達成最佳目標的求解速度提升 超過 14.61 倍
官方形容這是一個閉環:模型最佳化自己所需的資源排程,而節省下來的算力又回过头來支持下一輪模型迭代。
五、安全與治理:這次的數字比功能說明更值得看
官方的安全段落有一組冷門但重要的數字。在 Last Secure Code Bench 的「無安全提示重構程式碼」與「功能+漏洞雙重驗證」測試中,Qwen4-Max 的功能層通過率從 Qwen3.8-Max 的 22.0% 提升到 31.8%;而在函式、檔案、儲存庫三個粒度「同時安全地生成程式碼」的比例從 8% 提升到 14.7%,接近翻倍。
官方表示,對於資安用途會依任務目的過濾資料(保留防禦性任務、移除攻擊性用途),內部資安專家審閱長時任務軌跡(含完整 CoT)後,認為防禦能力顯著提升、對攻擊性使用的防護也明顯強化,未觀察到造成大規模資安風險的能力。CBRN 部分則加入專屬安全資料,內部評估顯示模型能辨識更多風險請求且沒有出現過度拒絕。
為什麼這件事重要
三件事值得放在同一個時間點看。
第一,開放權重陣營的時間軸被重新設定。 官方在文末明確寫道:「Max 只是 Qwen4 的第一眼。家族中更小的模型將會開源,建立在相同血統、並以同一世代的技術訓練。」這句話的份量在於:Qwen3.8-Max(2.4T/約 95B 啟用)當時還未全面開放權重,而這一次直接把「同架構的開源小模型」寫進了產品路線圖。HN 上等 27B 與 Flash 版本的留言串,幾乎都在問同一個問題——手上一張 3060 終於有救了嗎。
第二,成本結構被重寫了。 Work360 每任務平均成本從 $4.43 降到 $1.67(↓62%),而且這是在分數上升的同時發生,同時 token 用量還少了 24–49%。過去兩年模型能力的主要瓶頸不是「模型不夠聰明」,而是「每個任務要花太多錢、太多 token」。把這三個指標同時往下壓,等於把 agentic 應用的單位經濟往前推了一大段。
第三,長時任務的工作模式變了。 Live Delivery 搭配 24/7 agent、模型自我最佳化雲端資源排程、48 小時全自主材料合成——這幾個案例指向同一件事:AI 正從「回答問題」轉向「長期持有進度條」。這對任何有長期專案的團隊(不只寫程式)都是結構性的改變。
數據解讀與質疑
基準是自建、數字未經第三方重測。 Work360 是阿里巴巴自己定義、自己測的;其他基準的分數官方只寫「引用自 Mercor/Artificial Analysis/Arena 等榜單」,沒有附完整對照表。沒有第三方重測之前,52.69 與 47.74 之間的 +4.95 只能視為廠商宣稱值。
Artificial Analysis 的分數與 HN 討論存在明顯落差。 HN 網友 maplet 引用 AA 頁面指出,Qwen4-Max 為 43 分、平均每任務成本 $3.27;同期 GPT-6.1 Sol(medium)為 46 分、平均 $0.36。若照 AA 自己的數字,Qwen4-Max 在「智力 × 成本」座標上明顯落後。但同一串裡另一位網友 anon373839 指出,AA 會對 Anthropic 與 OpenAI 使用其原生 harness 測試,卻不對 Qwen/DeepSeek 做同樣處理,因此這種比較並不對等。換句話說,「Qwen4-Max 太貴」與「AA 這份榜單不可信」這兩種說法同時在流傳,而兩邊都還沒有充分證據。
95% 的工廠時間降幅,需要打折看。 475 分鐘降到 24 分鐘是官方 showcase 的數字,來自「單一工件、程式設計環節」的示範案例,不是整廠的實際產出統計。這類「案例型基準」的問題是:模型跑的是官方挑選過的任務、官方調過的提示、官方挑的展示時機。
成本 $1.67 與 AA 的 $3.27 差了一倍。 同一個模型、同一個 Work360,官方說每任務 $1.67,AA 頁面寫 $3.27。兩者用的是不同推理強度設定(HN 討論串裡有網友指出這正是爭議核心:不同模型在不同思考強度下測,數字根本不可比)。這些差異正是為什麼 Siami 從不直接引用單一成本數字當結論。
安全數字提升幅度有限。 22.0% → 31.8% 聽起來是 +45%,但絕對值意味著近七成測試案例仍未通過。三層級同時安全生成的佔比從 8% 到 14.7%,同樣意味著絕大多數生成程式碼仍不能被視為「預設安全」。
Agent 自主程度仍待觀察。 48 小時自主合成冷卻液、454 次工具呼叫、90 個 MCP 工具——這些數字很吸引人,但官方的自製流程由官方自己設計與驗證,且「閉環四次就成功」本身可能是篩選後的最佳案例。
Siami 觀點
Qwen4-Max 真正值得寫的,不是「2.4 兆參數」這種已經不稀奇的名詞,而是它把效率議題拉回來當主軸。官方反覆強調的都不是峰值分數,而是「少用 25% 參數、token 少一半、每任務成本少 62%」。這是產業從「軍備競賽」轉向「單位經濟」的訊號——當所有人都能拿到差不多的分數,最後決勝負的就是每一塊錢能換到多少可用產出。
第二個訊號在文末那句開源預告。過去兩年開放權重模型能追上前沿,靠的是混合注意力、多 token 預測、更好的優化器這些「用效率補算力」的技巧;現在這批技巧的邊際效益正在收斂,而出口禁令的結構性差距依然存在。阿里把「同架構小模型開源」寫進發表稿,代表他們的答案是:把差距從模型能力轉到部署成本上——用更小的開源模型鋪量,用 Max 收尾尾工作。
第三,也是最實際的一點:現在不是換模型的時候。AA 指數與真實體感脫節、廠商自測未經重測、成本數字因推理強度而異——這些都意味著「照著榜單換模型」這個動作在 2026 年底已經不太可靠。比較可靠的做法是拿自己真實的任務去跑:同一個 prompt、同一個 harness、同一個推理強度,跑一週再決定。目前 Qwen4-Max 已在 OpenRouter 上架,可以直接 A/B。
對台灣的開發者與小型工作室來說,最實際的訊號是:它已可透過 QwenCloud 的 Token Plan 或 API 使用,同時在 QwenWork、Qoder、QwenStudio 提供服務。如果你的工作型態是大量長文、文件、多步驟分析,1M 上下文加上降下來的單任務成本,值得實測一輪。
延伸閱讀
- Qwen 官方部落格〈Qwen4-Max: Your New Teammate Has Arrived〉(2026/11/16,一手來源)
- Hacker News 討論串(202 分/58 則回覆)
- Artificial Analysis 模型頁:Qwen4-Max
- OpenRouter:Qwen4-Max 模型頁
- llm-stats〈Qwen4-Max-Preview Benchmarks, Pricing & Context Window〉
- the-decoder〈Alibaba’s open-weight Qwen3.8-Max takes on long-horizon AI tasks with 2.4 trillion parameters〉
- GitHub:QwenLM 組織(Qwen-Live-Delivery-Plugin、qwen-code、Qwen-Live-Harness)
- 影片:WorldofAI〈QWEN 4 Preview IS INSANE! First Look at Qwen 4 Max & 27B!〉(第三方頻道實測)
- 影片:Extrude Studio〈Qwen 4 Max Preview vs 4 Rivals: Same Brief, Different Results〉(第三方頻道同題對比)
- 影片:AI Mathias〈Qwen4-Max-Preview Is Here: 1M Context, One Big Catch〉(第三方頻道解說)
網友熱門留言 (6)